Noam Brown, cientista do OpenAI: o verdadeiro limite superior da IA pode não ser medido por ninguém
Conforme os grandes modelos de linguagem começam a ser utilizados em tarefas complexas, como raciocínio lógico, pesquisa automatizada e segurança cibernética, os métodos tradicionais de avaliação de modelos enfrentam novos desafios.
Por um longo tempo, o lançamento de modelos foi frequentemente acompanhado por tabelas de resultados compostas por vários tipos de testes de benchmark, incluindo matemática, programação, perguntas e respostas científicas, segurança cibernética, raciocínio de conhecimento, etc., e esses resultados eram comparados horizontalmente com o modelo anterior.
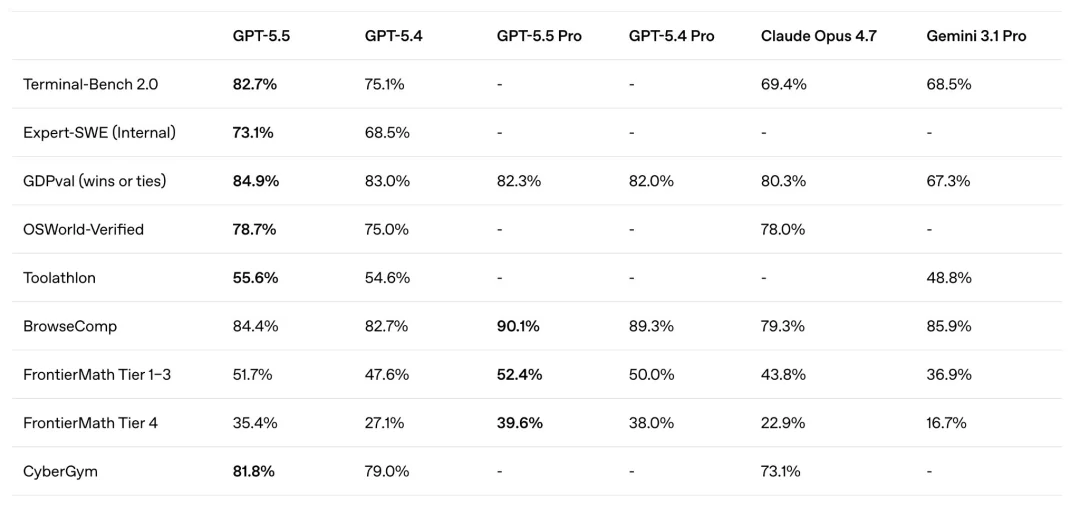
O pesquisador da OpenAI, Noam Brown, recentemente apontou que, quando os modelos utilizam mais etapas de raciocínio para responder a perguntas, recorrem a mais ferramentas ou realizam buscas e testes mais demorados, uma única pontuação torna-se cada vez menos capaz de refletir com precisão a verdadeira capacidade do modelo.
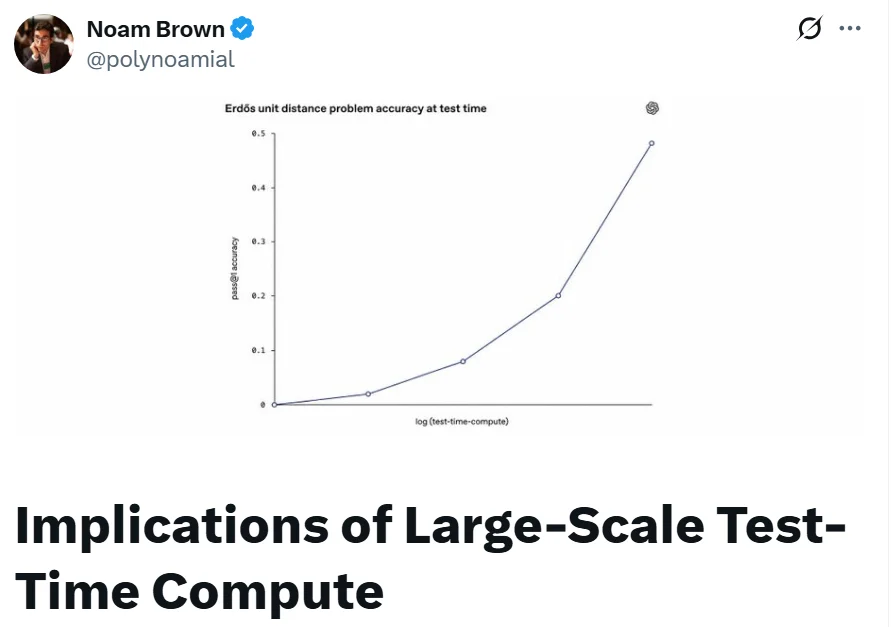
As principais ideias de Brown são as seguintes:O desempenho dos grandes modelos não depende apenas do modelo em si, mas também da quantidade de recursos computacionais que o modelo recebe durante a fase de inferência.Ao avaliar modelos no futuro, não podemos nos perguntar apenas "Quanto ponto o modelo obteve?", mas também devemos responder a outra pergunta: Quantos tokens o modelo consumiu e a que custo e tempo de execução isso foi alcançado?
Ele sugere que a indústria deve passar de uma abordagem baseada em “resultados individuais” para uma abordagem focada no “desempenho da curva de consumo de computação de inferência”, e considerar o orçamento para inferência como uma variável fundamental na avaliação da capacidade dos modelos e na política de segurança da inteligência artificial.
Os relatórios de desempenho tradicionais podem subestimar a diferença de capacidade entre os novos modelos.
Brown utilizou a reação do mercado após a publicação, representada por GPT-5.5, para ilustrar as limitações dos modelos de classificação tradicionais.
De acordo com sua descrição,GPT-5.5No início do lançamento, o que chamou a atenção do público foram um conjunto de resultados de testes de desempenho que não eram particularmente notáveis.GPT-5.4Em comparação, a pontuação do novo modelo aumentou, mas, de acordo com as tabelas de pontuação tradicionais, o aumento parece ser limitado. Por isso, alguns usuários estão esperando para ver ou até mesmo questionando a nova versão.
Mas nas horas seguintes à abertura do modelo, alguns usuários notaram que, à medida que desenvolvedores e pesquisadores começaram a testar tarefas mais complexas, o GPT-5.5 apresentou diferenças significativas entre gerações no que diz respeito à inferência de cadeias longas, execução contínua e tratamento de problemas complexos. Brown acredita que esse fenômeno – em que a “experiência prática é claramente aprimorada, mas as mudanças nas pontuações da lista são limitadas – reflete a incapacidade das avaliações tradicionais de capturar plenamente o potencial do modelo.
O problema é que os resultados da avaliação de diferentes modelos podem não ser baseados no mesmo orçamento de raciocínio (ou seja, os modelos podem usar diferentes recursos ou algoritmos para processar os dados).
Nos frameworks de avaliação tradicionais, os pesquisadores costumam escolher um conjunto de configurações de teste para cada modelo a fim de maximizar os resultados o máximo possível e, em seguida, colocar as pontuações finais em uma mesma tabela. Isso pode parecer justo, mas pode encobrir uma variável crucial: alguns modelos podem continuar a melhorar significativamente seu desempenho ao receberem mais tokens de inferência, mais chamadas ou mais tempo de execução; outros modelos, por outro lado, podem atingir seu limite de desempenho mais cedo.
Os casos de avaliação de segurança cibernética apresentados por Brown mostram que, se os chamados modelos forem comparados apenas com base no resultado final sob a condição de “calcular a quantidade máxima durante o teste”, a vantagem de GPT-5.5 em relação a GPT-5.4 pode não ser tão evidente. No entanto, se o número de tokens, o custo de raciocínio ou o atraso forem mantidos no mesmo nível e, em seguida, o desempenho dos diferentes modelos for observado, a melhoria na capacidade de GPT-5.5 será ainda mais notável.
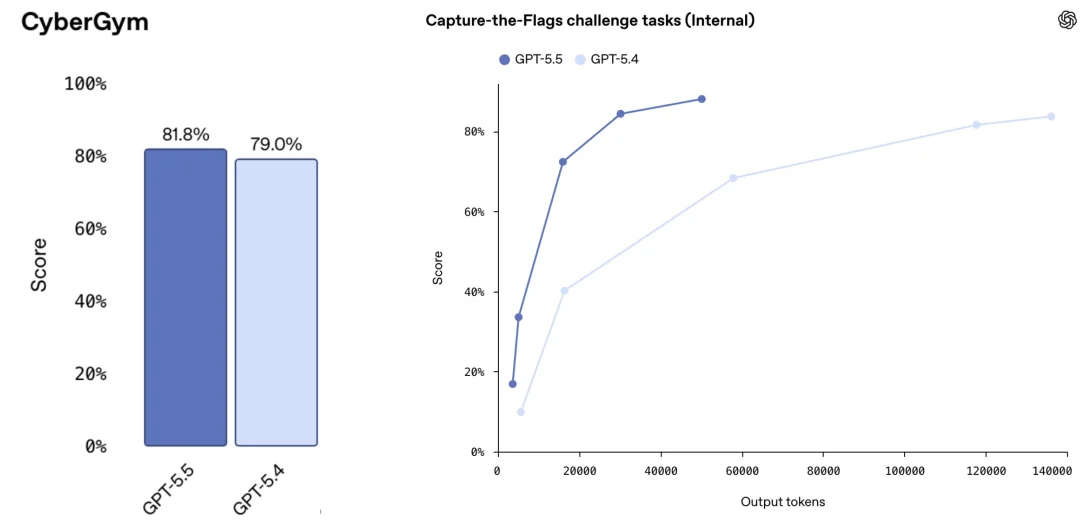
Em outras palavras, a diferença entre os modelos não se reflete apenas nas pontuações finais, mas também na eficiência no uso da quantidade adicional de cálculo para a inferência.
Por que não pode ser simples? “Continuar correndo até que o desempenho não melhore mais”
A solução intuitiva é continuar adicionando recursos de inferência para cada modelo até que seu desempenho atinja um nível estável (período de platô), e então comparar suas capacidades máximas.
Brown acredita que essa ideia pode não ser viável na prática. A razão é que, para a nova geração de modelos, o período de estabilidade de desempenho pode demorar muito mais do que o esperado, e pode ser difícil de observar mesmo dentro do orçamento realmente aceitável.
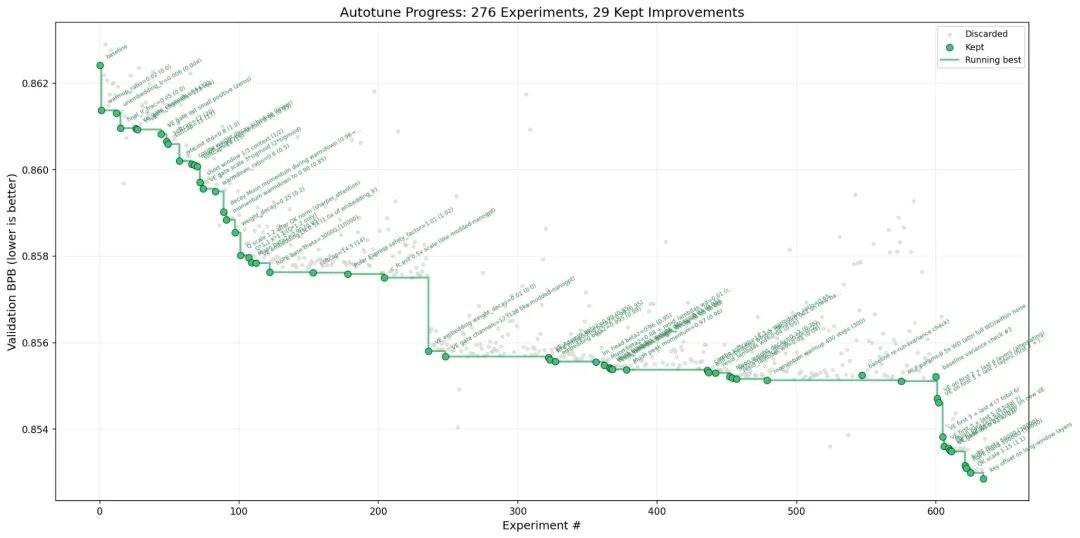
Ele citou como exemplo um experimento de pesquisa em automação iniciado por Andrej Karpathy. Nesses experimentos, o desempenho do modelo continuou a melhorar mesmo após a realização de um grande número de testes. Mesmo após centenas de tentativas, a curva de melhoria não foi completamente suave (ou seja, o progresso não foi constante).
Brown Além disso, o Instituto de Segurança em Inteligência Artificial do Reino Unido também mencionou os resultados da avaliação de segurança cibernética realizada pelo instituto. Nessa avaliação, modelos como Mythos e GPT-5.5, entre outros, continuaram a mostrar melhorias no desempenho após o uso de mais de 100 milhões de tokens.
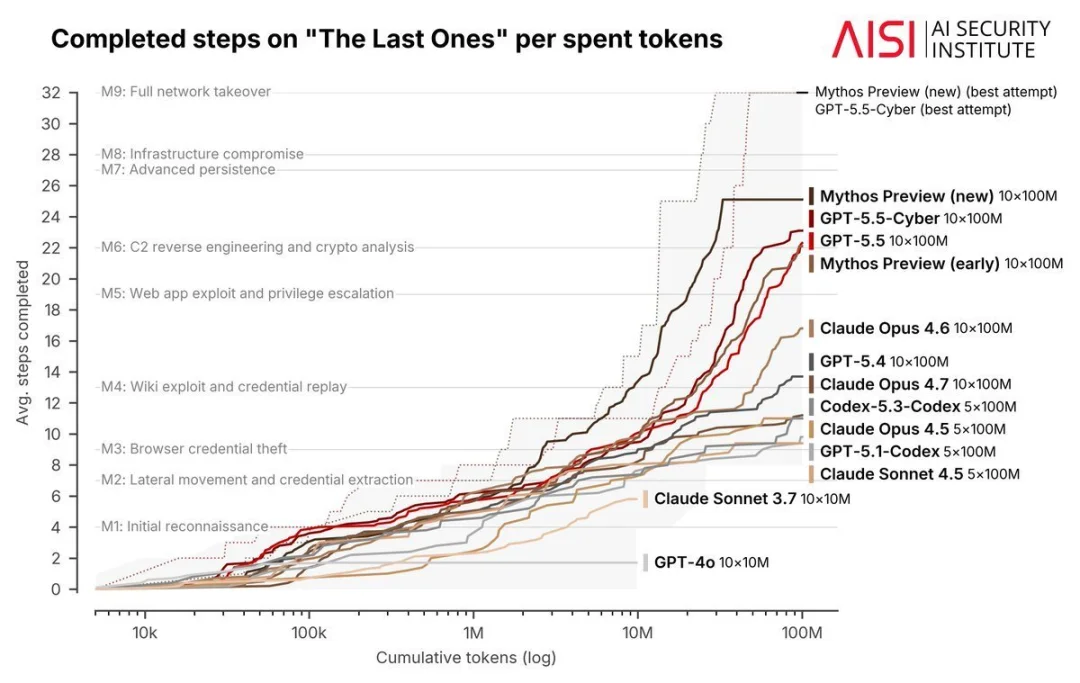
Este fenômeno significa que os modelos podem utilizar tempos de execução cada vez mais longos e orçamentos de inferência cada vez maiores para explorar, testar e corrigir estratégias em tarefas complexas. Modelos mais poderosos não só têm um ponto de partida mais alto, mas também podem ser mais capazes de transformar recursos computacionais adicionais em capacidades efetivas.
Brown supõe que, à medida que a capacidade dos modelos melhora, o ciclo de tarefas em que eles funcionam de forma eficaz também se prolongará. No passado, pode-se ter observado que o desempenho dos modelos tendia a se estabilizar com orçamentos relativamente limitados; no futuro, o limite de desempenho pode ser alcançado com mais facilidade. Em certas tarefas, o chamado “período de platô” pode até deixar de ser um estado facilmente mensurável.
Passando de uma única pontuação para uma “curva de desempenho-custo”
Diante dessa mudança, Brown sugere que as instituições responsáveis pela publicação de modelos devem alterar a forma como os testes de referência são apresentados.
Em vez de apenas divulgar uma pontuação final, seria melhor marcar a quantidade de cálculos de raciocínio no eixo horizontal e exibir o desempenho da tarefa no eixo vertical, desenhando uma curva completa de mudança de desempenho. O eixo horizontal pode ser representado por indicadores como o número de tokens, o custo de raciocínio ou o tempo de execução real.
Esse método pode responder a perguntas que são difíceis de explicar em tabelas de resultados tradicionais. Por exemplo, com o mesmo orçamento, qual modelo se sai melhor? Quando o orçamento é aumentado em dez vezes, qual modelo melhora mais rapidamente? O modelo está se aproximando do seu limite de capacidade? Como muda a relação custo-benefício entre os diferentes modelos?
Métodos semelhantes já começaram a ser utilizados em alguns testes de referência. Brown mencionou que a avaliação ARC-AGI tenta medir a relação entre as pontuações dos modelos e os custos de execução, e não apenas publicar uma única pontuação.
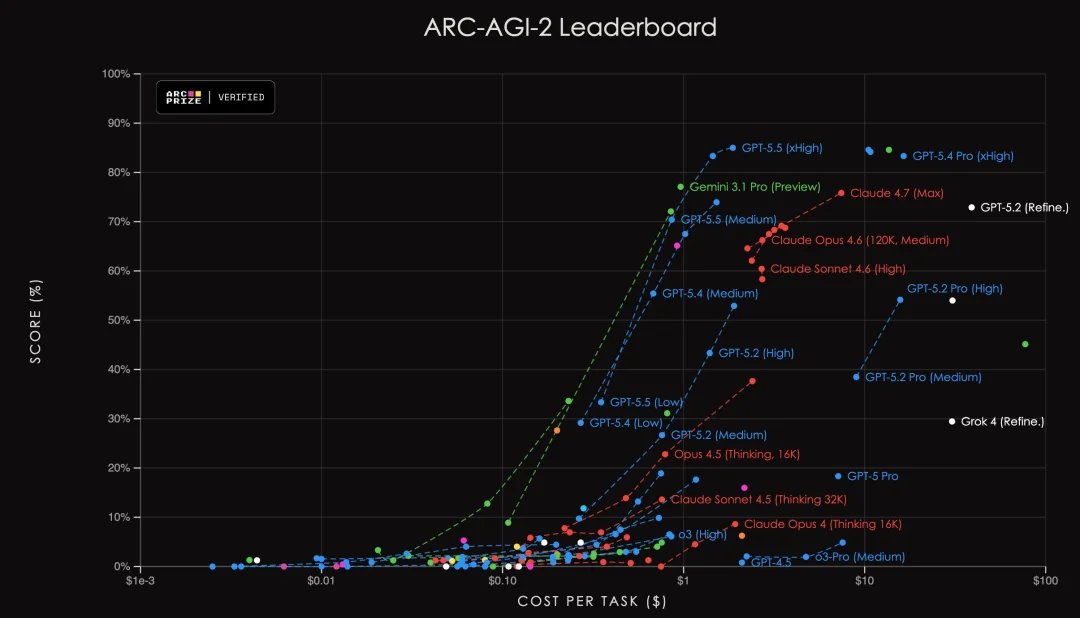
Outra abordagem viável é estabelecer tokens de plano, custos ou limites de tempo claros para a avaliação, e comunicar antecipadamente as informações sobre o orçamento do modelo. Esse método é semelhante ao de humanos participando de exames padronizados: seja o Exame de Admissão às Universidades Americanas (SAT) ou os Jogos Olímpicos Internacionais de Matemática, os participantes precisam completar as tarefas dentro de um tempo fixo. As capacidades dos modelos também podem ser comparadas sob restrições unificadas.
No entanto, Brown também apontou que os diferentes indicadores são limitados.
Devido aos diferentes processadores de segmentação utilizados pelos modelos, bem como às velocidades de geração e unidades de medida, é possível que os números não possam ser comparados diretamente entre modelos. Além disso, o custo pode variar de um modelo para outro. O custo é afetado pela utilização do hardware, pelo processamento em lote e pela implementação do projeto. Como o tempo de execução não é um indicador perfeito, ele também não é a melhor medida. Técnicas como a “cooperação entre múltiplos agentes inteligentes” ou o método “best-of-N” podem gerar várias respostas em paralelo, o que pode não aumentar significativamente o tempo de espera percebido pelo usuário, mas pode aumentar significativamente o volume total de cálculos.
Apesar disso, ele acredita que qualquer um dos indicadores mencionados acima fornece mais informações do que uma única pontuação que excede o orçamento de raciocínio.
O problema do orçamento de raciocínio está se expandindo para a avaliação da segurança da inteligência artificial.
As discussões de Brown não se limitam à lista de modelos. Ele acredita que o orçamento de raciocínio também afeta diretamente a segurança de gestão dos modelos de ponta.
Antes de lançar modelos de inteligência artificial de ponta, as instituições de P&D geralmente avaliam potenciais capacidades de abuso, como ataques cibernéticos, riscos biológicos e riscos químicos. Se um modelo atingir um determinado limiar de risco, as instituições de P&D podem precisar adiar o lançamento ou adicionar medidas de mitigação, como restrições de acesso e mecanismos de monitoramento, antes da implantação.
A questão é: se a capacidade do modelo melhora com o aumento da quantidade de cálculo de inferência, quanto orçamento para inferência deve ser usado na avaliação de segurança?
Na verdade, um usuário comum provavelmente investirá apenas alguns dólares ou dezenas de dólares em uma tarefa. No entanto, uma organização com recursos suficientes, uma equipe profissional ou um ator estatal pode estar disposto a investir muito mais recursos do que um usuário comum em um único objetivo. Se a instituição de avaliação testar o modelo com um orçamento mais baixo, pode subestimar sua capacidade de enfrentar riscos em condições de recursos mais elevados.
Brown usou o controvérsia que surgiu após o lançamento do Gemini 3 Deep Think como exemplo. Ele apontou que os resultados dos testes de benchmark do Deep Think eram significativamente superiores aos dos modelos anteriores, mas o cartão de sistema completo não foi fornecido na época do lançamento para avaliar a capacidade de risco dessa versão. Essa abordagem gerou críticas de alguns pesquisadores em segurança da inteligência artificial.
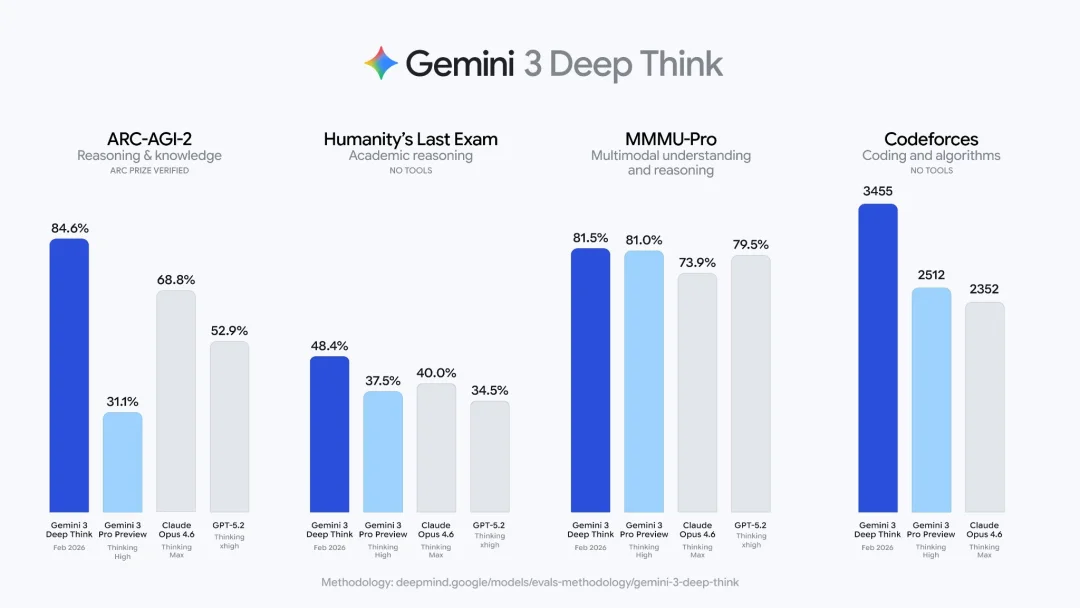
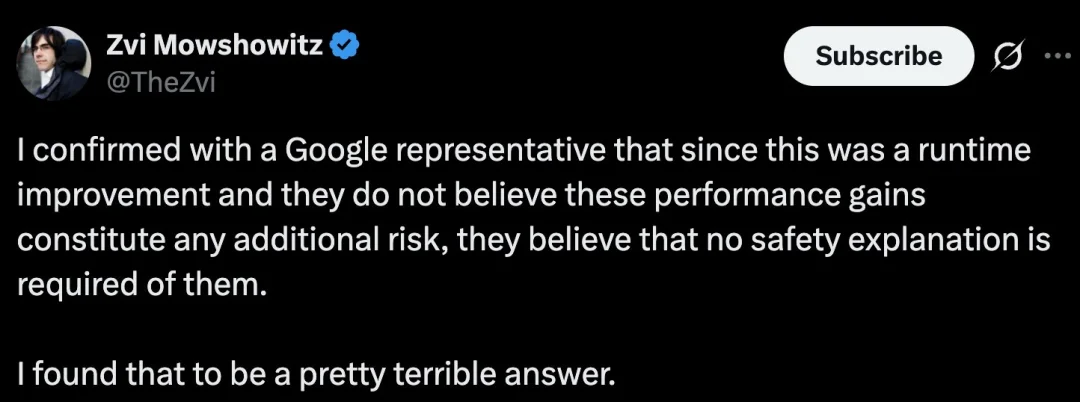
No entanto, parece haver um problema mais profundo por trás da controvérsia de Brown: as empresas de inteligência artificial e as instituições de segurança ainda não desenvolveram um método estável para avaliar a capacidade dos modelos sob diferentes orçamentos de raciocínio.
Ele especula que o Deep Think pode não ser um novo modelo treinado de forma completamente independente, mas sim um sistema de suporte para raciocínio baseado em outros modelos existentes. Esse sistema pode melhorar o desempenho em tarefas complexas através de múltiplas chamadas ao modelo, geração paralela de resultados candidatos, verificação automática de respostas e correções iterativas.
Se essa premissa for válida, então, em teoria, o Deep Think não só poderá realizar as funcionalidades demonstradas pela própria plataforma, mas também os desenvolvedores externos, desde que estejam dispostos a investir um tempo significativo no processo de raciocínio, poderão combinar vários modelos para criar fluxos de trabalho semelhantes. O papel do Deep Think é principalmente encapsular processos de raciocínio complexos que normalmente exigem conhecimentos técnicos especializados em uma forma que usuários comuns possam utilizar facilmente.
Portanto, as pessoas da Brown acreditam que a questão realmente importante não é se o sistema foi lançado separadamente do cartão, mas se a instituição de pesquisa e desenvolvimento testou adequadamente o nível de capacidade que o modelo básico poderia alcançar quando foi lançado inicialmente, considerando diferentes orçamentos para raciocínio e estratégias de suporte.
A avaliação com orçamentos altos é difícil de implementar de forma abrangente, mas pode-se tentar fazer inferências.
Teoricamente, um agente com recursos suficientes poderia investir mais de um milhão de dólares em custos de raciocínio para uma única tarefa. No entanto, as avaliações de segurança geralmente envolvem milhares ou até milhões de testes. Se um orçamento extremamente alto for usado para cada operação, o custo da avaliação se tornará rapidamente inviável.
Brown sugeriu que os testes possam ser realizados inicialmente dentro de um orçamento de raciocínio relativamente controlável e, em seguida, o desempenho sob condições de orçamento mais elevado possa ser promovido com base na tendência da capacidade do modelo em mudar com o aumento da quantidade de cálculos. Além disso, as instituições de avaliação devem marcar claramente o alcance das previsões e as incertezas, em vez de considerar os resultados dos cálculos como conclusões definitivas.
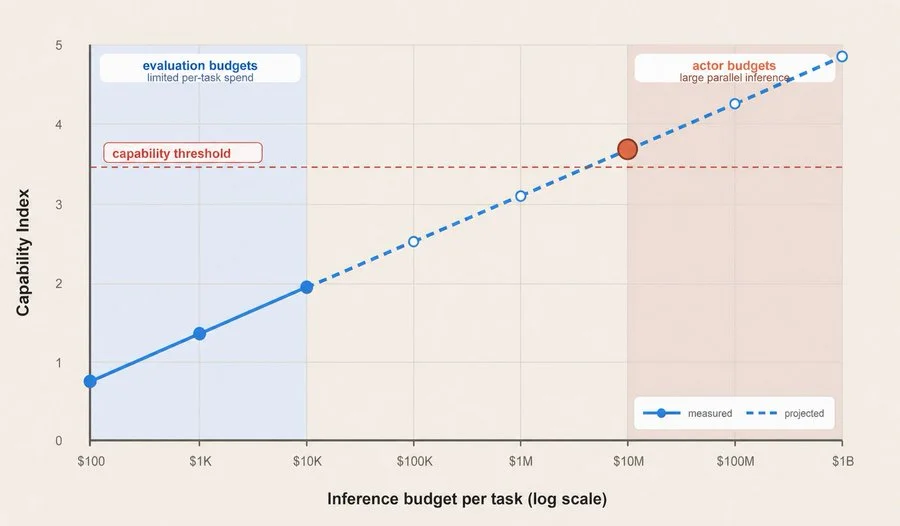
Este método é semelhante à estimativa de tendências de mudança em sistemas de maior escala com base em dados locais. Ele não pode substituir os testes reais, mas pode ajudar as instituições de pesquisa e desenvolvimento e as autoridades reguladoras a entenderem como as fronteiras de risco podem mudar quando os modelos recebem mais tempo, ferramentas e recursos de computação.
No entanto, Brown também reconheceu que tarefas de longo prazo ainda podem apresentar problemas que são difíceis de resolver em experimentos de curto prazo.
Por exemplo, se os pesquisadores quiserem determinar se um agente inteligente independente desenvolverá desvios de objetivo, enganos estratégicos ou outros comportamentos inconsistentes após um ano de operação contínua, a maneira mais confiável pode ainda ser permitir que o agente inteligente funcione por um período de tempo suficientemente longo. Com base apenas em resultados de experimentos de algumas horas ou dias, pode ser difícil detectar mudanças críticas no comportamento de longo prazo.
Isso criará um novo conflito de realidade: o ciclo de desenvolvimento e lançamento de modelos de inteligência artificial pode levar apenas alguns meses, enquanto o ciclo de tarefas que um corpo inteligente pode executar continuará a se estender cada vez mais. No futuro, as instituições de pesquisa e desenvolvimento podem enfrentar uma situação especial – a próxima geração de modelos poderá estar prestes a ser lançada antes de completar o seu ciclo máximo de operação.
Três sugestões: tornar o orçamento para raciocínio uma variável básica na avaliação dos modelos
Em resposta aos problemas mencionados acima na avaliação de capacidades e governança de segurança, Brown propõe três sugestões específicas.
Primeiramente, as instituições de pesquisa em inteligência artificial devem publicar o desempenho dos testes de referência sob diferentes condições de orçamento de inferência ao lançar novos modelos. Idealmente, as empresas deveriam fornecer curvas de desempenho com o número de tokens, o custo ou o tempo de execução no eixo horizontal. No mínimo, as empresas precisam explicar quantos recursos de inferência foram realmente utilizados para alcançar um resultado específico.
Em segundo lugar, as classificações dos testes de referência devem registrar o consumo de recursos de inferência ou estabelecer limites uniformes para tokens, custos ou tempo para os modelos de referência. Atualmente, algumas avaliações já levam em conta esses fatores, mas a indústria ainda não adotou práticas padrãoizadas.
Em terceiro lugar, os recursos de computação para a fase de raciocínio do Marco de Preparação das Empresas de Inteligência Artificial (Preparedness Framework) e da Política de Escala Responsável (Responsible Scaling Policy, RSP) devem ser considerados de forma clara. Quando uma instituição determina se um modelo ultrapassa um determinado limiar de segurança, não é suficiente verificar o desempenho em uma única configuração; é necessário também avaliar vários níveis de orçamento de raciocínio e prever incertezas quanto à capacidade de resposta aos riscos em condições de orçamento mais elevado.
O setor já reconheceu esse problema, mas os sistemas de avaliação ainda não acompanharam plenamente essa evolução.
Adicionar recursos de computação na fase de inferência pode melhorar o desempenho do modelo, e isso não é uma descoberta nova.
Desde que a OpenAI lançou o modelo de raciocínio o1 em setembro de 2024, a indústria geralmente acredita que esse modelo utiliza mais etapas de raciocínio ao responder perguntas, o que lhe permite obter melhores resultados em tarefas matemáticas, de código e análises complexas. A pesquisa sobre "a capacidade de expansão durante os testes computacionais" ou "a capacidade de expansão no raciocínio computacional" também tem se tornado uma direção importante no desenvolvimento de grandes modelos.
Mas, segundo Brown, quase dois anos após o surgimento dessa tendência, a publicação de muitos modelos avançados ainda se baseia principalmente em uma única pontuação de referência para sua disseminação e comparação. Algumas agências de segurança também podem reavaliar os limites da capacidade dos modelos após utilizar orçamentos de inferência que são dezenas ou até centenas de vezes maiores nos sistemas de suporte (esqueleto).
À medida que os modelos se tornam cada vez mais capazes de utilizar execuções de longo prazo, múltiplas iterações de tentativa e erro e recursos de inferência em larga escala, a qualidade da interpretação das listas tradicionais pode continuar a diminuir. Sob diferentes condições, como perguntas e respostas com orçamento limitado, pesquisas avançadas com orçamento elevado, colaboração entre várias inteligências e chamadas a ferramentas automatizadas, o mesmo modelo básico pode apresentar níveis de desempenho completamente diferentes.
Brown acredita que, no futuro, ao medir a capacidade da inteligência artificial, o orçamento de raciocínio não deve mais ser considerado apenas como uma informação auxiliar no processo de teste, mas sim como um parâmetro central nos relatórios de avaliação, juntamente com o tamanho do modelo, os dados de treinamento e a janela de contexto.
De uma perspectiva mais ampla, isso também significa que a indústria de inteligência artificial está gradualmente deixando para trás a fase de "definir um modelo com um único número". Para a avaliação de capacidades, a comparação de produtos e a segurança, as questões realmente importantes podem não ser apenas o que o modelo é capaz de fazer, mas sim o que ele pode alcançar quando recebe tempo, recursos financeiros e computacionais suficientes.
Referência de conexão: https://x.com/polynoamial/status/2064210146558136827
O autor é da “Machine Heart” e do “Editorial da Machine Heart”.
Link do artigo:https://airai.cc/pt/ai-news/10/
Isso foi útil?