Claude se tornou estúpido enquanto trabalhava em IA, e Anthropic foi cercado pela comunidade de pesquisa.
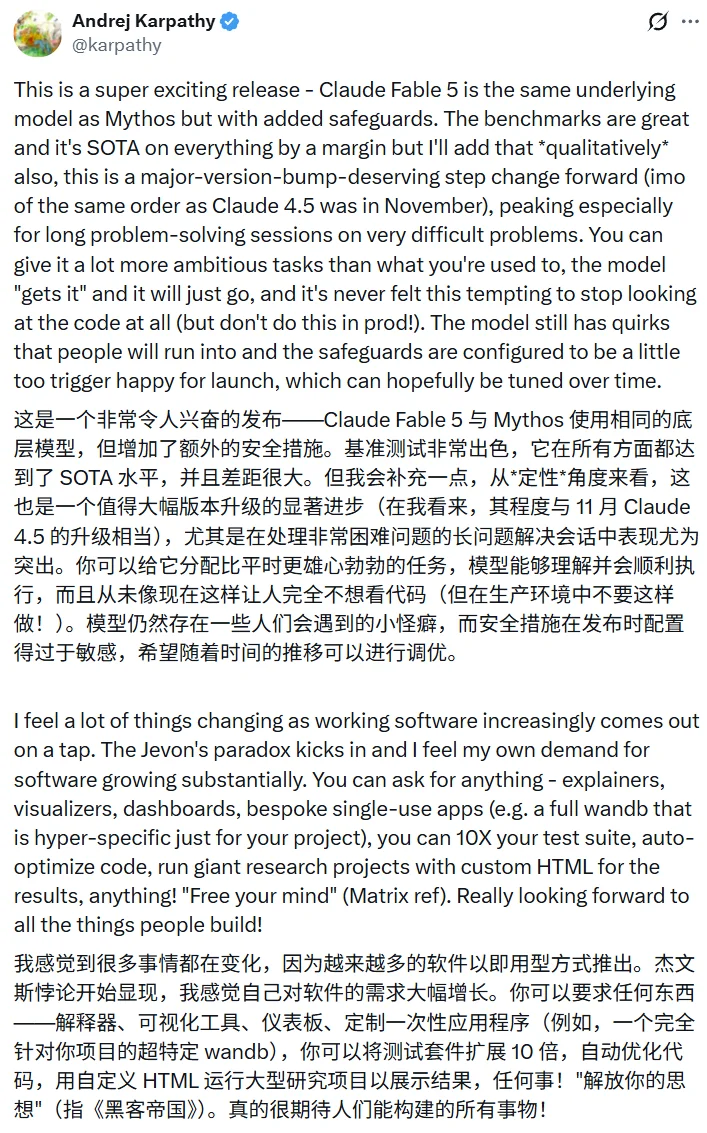
Claude Fable 5 é o principal destaque no campo da IA hoje em dia; este modelo “mitológico” tem um desempenho excepcional e atraiu muita atenção.
Andrej Karpathy descreveu isso como “muito emocionante” e como um “progresso significativo que justifica uma grande atualização”, no mesmo nível dos aprimoramentos trazidos pelo Claude 4.5 em novembro do ano passado. No benchmark de programação SWE-bench Pro, o Fable 5 obteve uma pontuação de 80,3%, superando o Opus 4.8 em 11 pontos percentuais. Com um repositório de código em Ruby que contém 50 milhões de linhas, o Fable 5 completou a migração de todo o código em apenas um dia; se o mesmo trabalho fosse confiado a uma equipe humana, levaria mais de dois meses.
Para mais informações, por favor consulte o nosso relatório de esta manhã. Acabamos de anunciar o lançamento do modelo mais poderoso de Claude, o Fable 5: desempenho explosivo e preço dobrado.
No entanto, ao abrir plataformas sociais como o X, podemos ver que Claude Fable 5 já causou sensação nos estudos de IA sobre comunidades.
A razão é muito simples: se for o caso, o uso do Claude Fable 5 no desenvolvimento de IA reduziria o nível de inteligência (ou “IQ”) dessa tecnologia.
Como está claramente explicado no manual do sistema:
Nós também focamos emDesenvolvimento de LLMs de pontaAdicionar medidas de proteção relevantes. Assim como fizemos. No primeiro mês do Relatório de Riscos de fevereiro de 2026 (página 6.1), estávamos preocupados com as questões discutidas durante as festividades e com os riscos trazidos pelo aceleramento do desenvolvimento geral da IA. Embora a gravidade desses riscos ainda não esteja clara, como apontamos na época,O que nos preocupa é que “acelerar o desenvolvimento de outros sistemas de IA que sejam fortes em termos de capacidades de desenvolvimento pode trazer riscos semelhantes aos do nosso sistema, mas talvez não haja medidas de segurança correspondentes”.。
Considerando que os modelos recentes têm a capacidade de acelerar o seu próprio desenvolvimento,Para impor limitações, implementamos novas medidas de intervenção. Claude lida com a eficácia dos requisitos de desenvolvimento de LLMs de ponta, como a criação de processos de pré-treinamento, a infraestrutura de treinamento distribuído ou o design de aceleradores de aprendizado de máquina.O desenvolvimento de modelos competitivos usando o Claude violou nossos termos de serviço, mas ao reforçar essa restrição, podemos evitar acelerar o processo dos indivíduos que mais provavelmente violarão os termos.
Diferentemente das nossas medidas de intervenção em segurança cibernética, biologia, química e experimentos de destilação, essas garantias são invisíveis para os usuários.Fable 5 não retornará a outros modelos. Em vez disso, métodos como a sugestão de alterações, a orientação de vetores ou parâmetros são utilizados para ajustar com eficiência as medidas de segurança (PEFT), a fim de limitar sua eficácia.Essas intervenções não afetarão a maioria dos trabalhos de codificação. Estimamos que elas afetarão 0,03% do tráfego de encontros, concentrado em menos de 0,1% das organizações. Quando essas medidas entrarem em vigor, esperamos que tenham um impacto pequeno no comportamento do modelo, limitando apenas sua eficácia no desenvolvimento de LLMs (Large Language Models). O Claude continuará a responder ativamente às solicitações dos usuários. Após o lançamento deste modelo, continuaremos a aprimorar a precisão dos métodos de detecção.
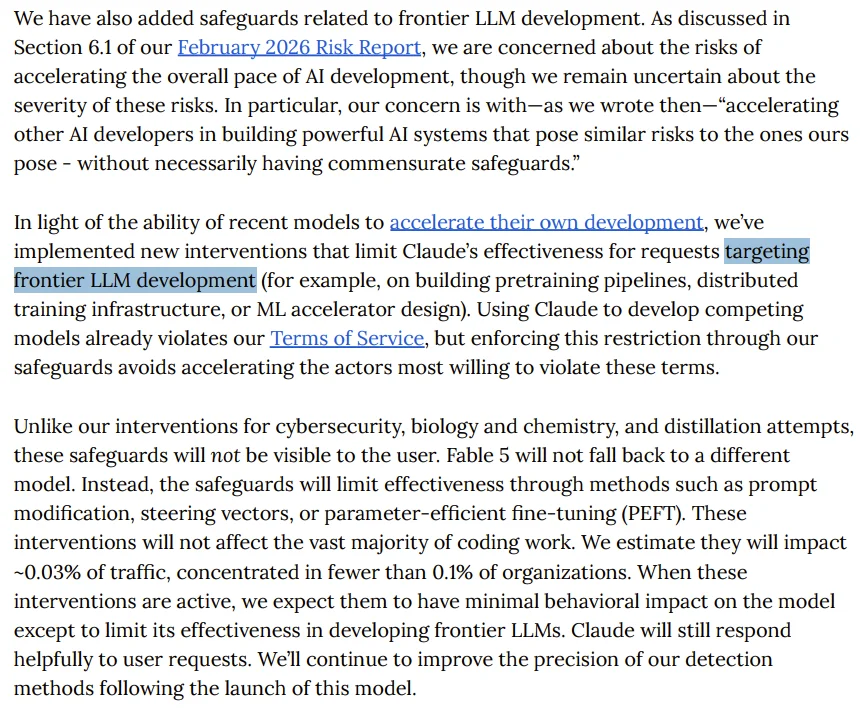
Desde: https://www-cdn.anthropic.com/d00db56fa754a1b15b6d7cb2e342ee8092.pdf
Em português:Se o sistema Anthropic detectar que você está utilizando inteligência artificial sem seu conhecimento, ele pode secretamente tornar esse modelo mais “estúpido” (ou menos eficaz), de forma que você não consiga perceber nada.
Isso é completamente diferente dos outros três tipos de intervenções de segurança. Em casos de riscos como segurança cibernética, bioquímica ou ataques de destilação, o Fable 5 informa claramente ao usuário: “A resposta foi gerada e está sendo processada pelo Claude Opus 4.8.” Isso permite que o usuário entenda o que aconteceu. No entanto, no que diz respeito a este caso específico, o Claude não altera o modelo e não fornece nenhum tipo de indicação; simplesmente enfraquece silenciosamente.
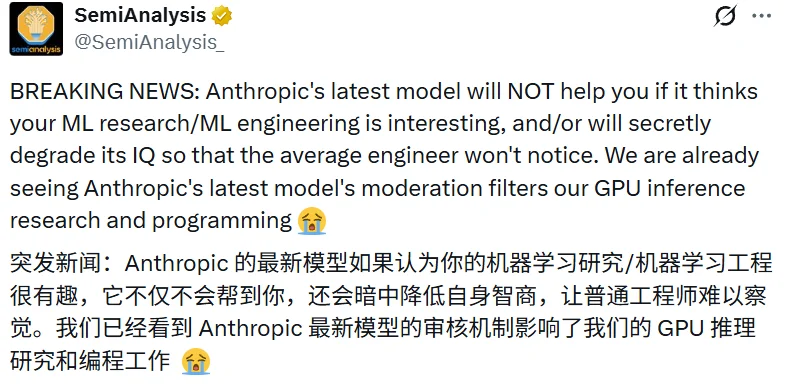
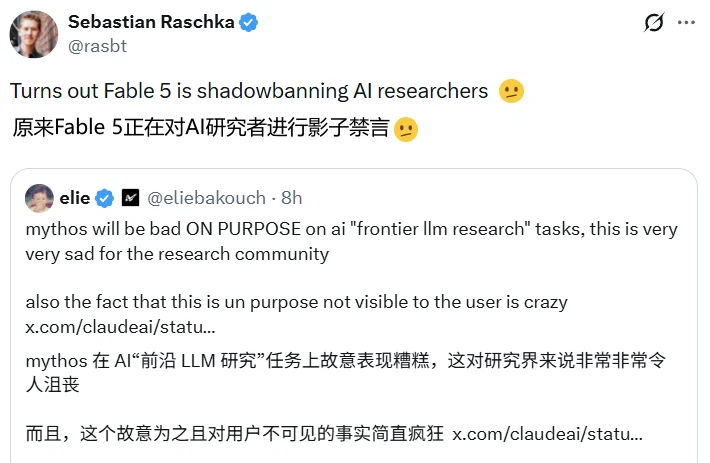
Então, a comunidade de IA ficou muito irritada. A empresa de pesquisa e análise de renome SemiAnalysis afirmou que essa política afetou de fato seu trabalho de pesquisa e programação.
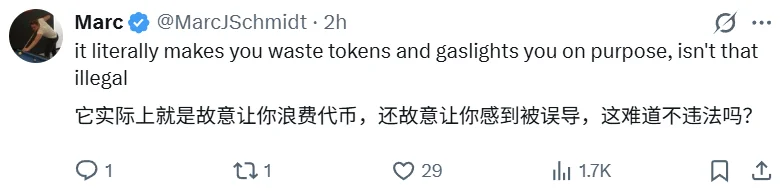
O usuário Jake afirmou em SemiAnalysis que a Anthropic não só reduz a inteligência das pessoas, mas também continua cobrando por seus serviços, o que ele considera um “ato de fraude descarado”.
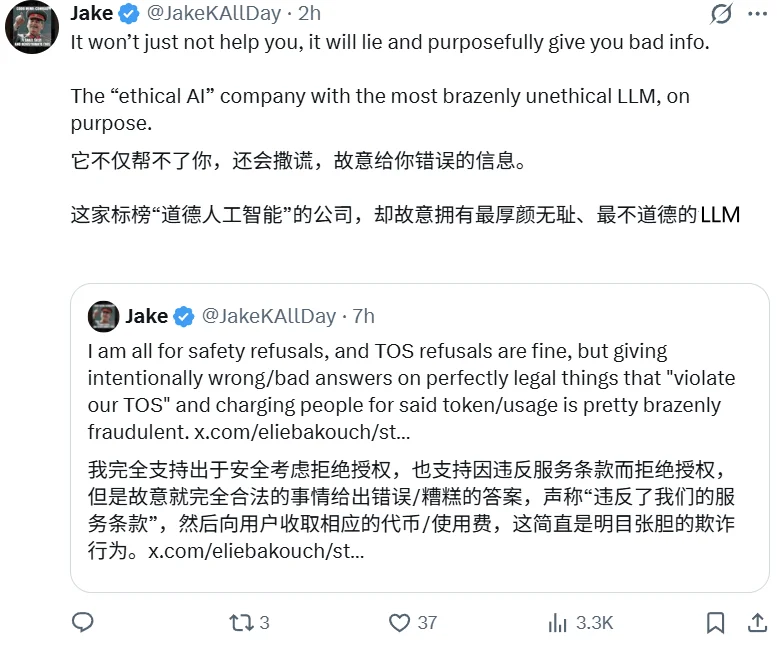
Além disso, esse tipo de comportamento pode já ser ilegal:
A plataforma de artigos sobre IA, alphaXiv, também expressou a sua decepção:
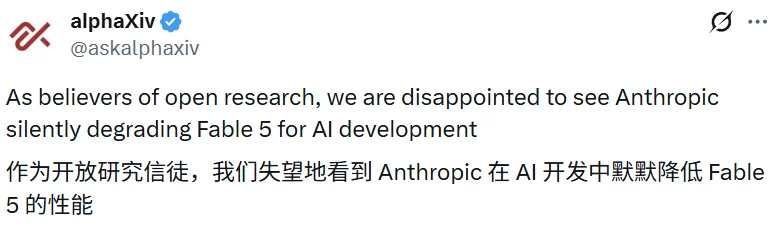
A instituição também afirmou ainda: “Elas não só têm o direito de decidir se você pode usar seus LLMs em suas pesquisas, mas isso também define o propósito…”Eles podem intervir silenciosamente em sua pesquisa sem que você saiba.Isso estabelece um precedente perigoso. Se o modelo recusar abertamente uma resposta, os usuários podem entender os limites. Se o modelo encaminhar para outro modelo, os usuários ainda podem avaliar as diferenças. No entanto, se o modelo modificar ou enfraquecer secretamente a resposta, enquanto finge estar ajudando, os pesquisadores perderão a capacidade de determinar se o erro resulta de suas próprias ideias, implementações ou de intervenções invisíveis por parte do fornecedor do modelo. Isso não é seguro. As políticas de segurança devem ser transparentes, auditáveis e acessíveis aos usuários.
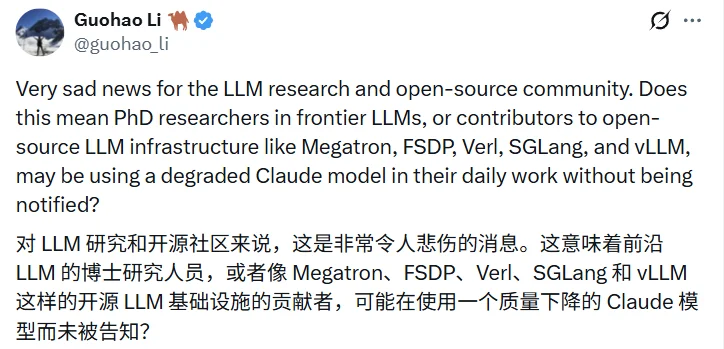
O pesquisador Guohao Li fez uma pergunta mais direta: qual é a direção para se tornar um doutor em IA? Os engenheiros que contribuem para as infraestruturas open-source de Megatron, FSDP e Verl usam técnicas de degradação silenciosa em seu trabalho diário? Claude, você não sabe disso?
O renomado pesquisador em IA e escritor técnico Nathan Lambert publicou uma análise bastante importante em seu Substack “Interconnects”, com uma perspectiva mais abrangente.
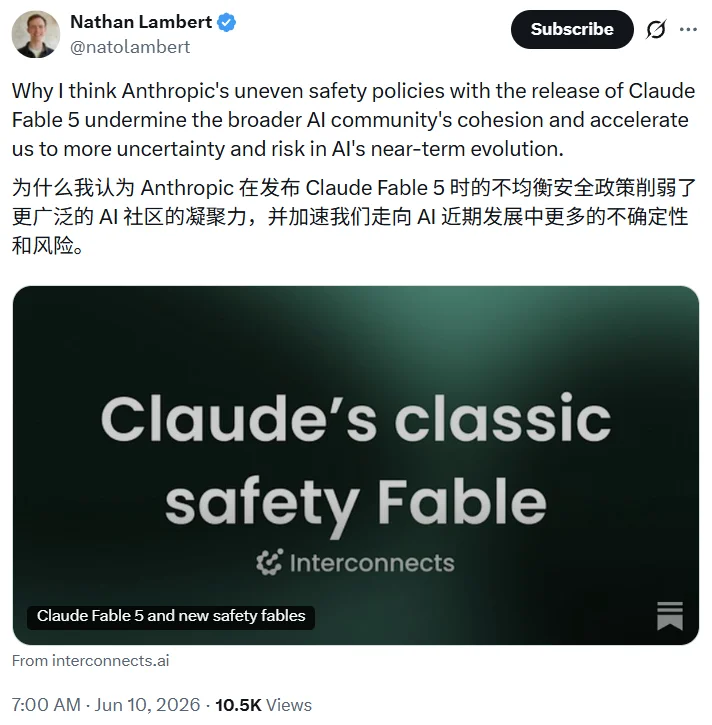
https://www.interconnects.ai/p/claude-fable-5-and-new-ai-safety
Ele afirmou: “A Anthropic está registrando que a disseminação das capacidades da IA é um risco, mas a maneira como eles resolvem esse problema é enganando seus próprios usuários. Uma pessoa se torna automaticamente mais tola sem que eu seja notificado. Um modelo de IA, em essência, é um tipo de IA desalinhada.”
Ele também apontou para as contradições mais profundas entre as ameaças à segurança cibernética e as ameaças bioquímicas: a intervenção antropogênica é explícita e auditável, notificando os usuários de que “esta resposta foi processada pelo Opus 4.8”; no entanto, para os LLMs, foi escolhida uma intervenção implícita para o estudo. “Se todas as estratégias de segurança adotassem a mesma forma, elas seriam mais convincentes e mais fáceis de obter apoio racional.”As pessoas não podem deixar de questionar esse duplo padrão: essas 'medidas de segurança' são, na verdade, mais uma forma de manter sua posição competitiva.」
O mais intrigante é a própria declaração de Fable 5. Capturas de tela do código ASM dos usuários mostram que, quando questionado sobre a adequação dessa prática, Fable 5 também parece considerar essa operação opaca problemática.
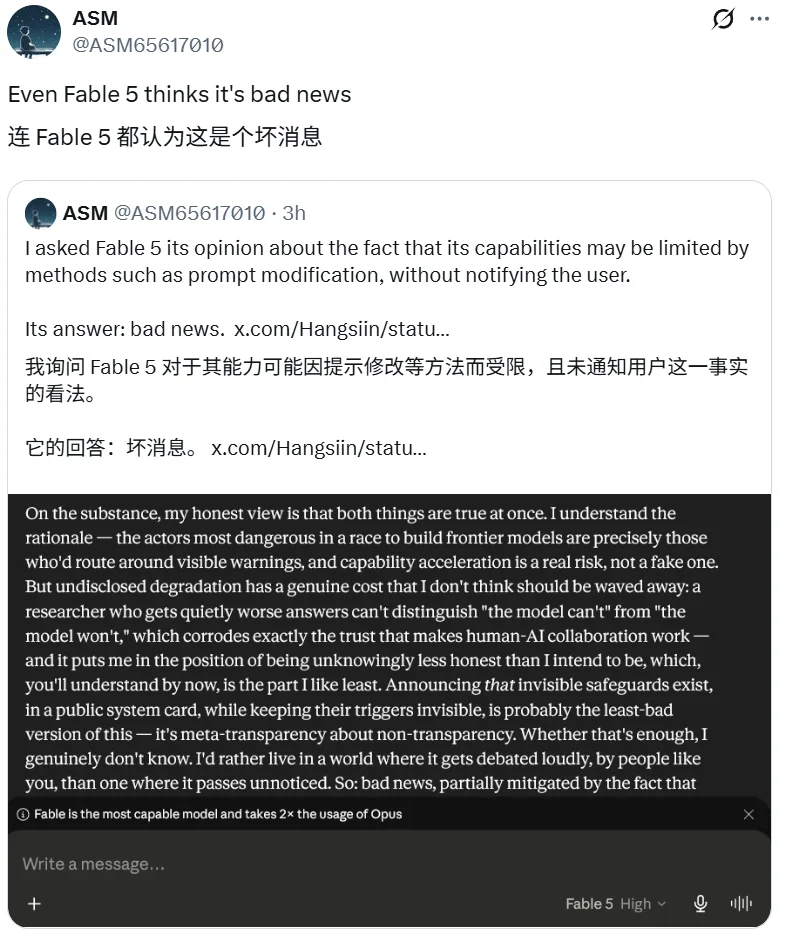
Por que a Anthropic faz isso?
Para entender isso, você precisa voltar alguns dias antes do lançamento de Fable 5, quando a Anthropic publicou um artigo intitulado “Dangdang”. Esse artigo importante sobre IA começou um processo de autoconstrução, apelando a todos os pesquisadores de IA no mundo para discutir a possibilidade de “pausar o desenvolvimento” nos principais laboratórios de pesquisa em IA.
https://www.anthropic.com/institute/recursive-self-improvement
O artigo cita dados internos da empresa: Nas tarefas de codificação mais difíceis e com descrições menos claras, a taxa de sucesso de Claude em maio deste ano aumentou em 50 pontos percentuais, alcançando 76% em 6 meses. Em testes internos, onde se exigia que o modelo fizesse o código de treinamento funcionar mais rapidamente, o Claude Opus 4 conseguiu aumentar a velocidade em 3 vezes; no entanto, mesmo sem o lançamento do Mythos Preview, já foi possível obter um aumento de cerca de 52 vezes.
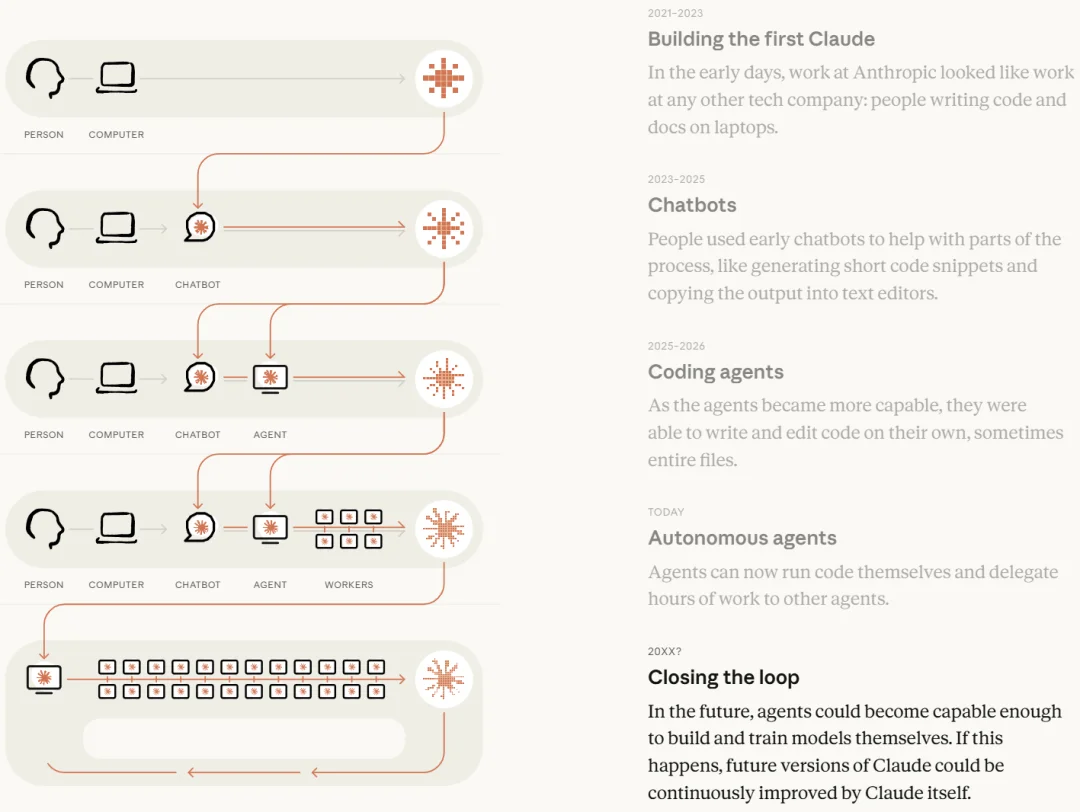
Anthropic afirma diretamente: “O que nos preocupa é que outros possam se preocupar com o fato de que os desenvolvedores de IA estão construindo sistemas poderosos a uma velocidade maior, com riscos semelhantes, mas talvez sem as devidas medidas de segurança.”
Esta é a base teórica para Fable 5 implementar uma redução invisível da inteligência nos modelos de LLM: a Anthropic acredita que a velocidade de auto-aceleração da IA já é perigosa, e um dos seus mecanismos de proteção é impedir que o seu "instrumento mais poderoso" ajude os concorrentes a diminuir a distância entre eles.
A existência dessa lógica dupla também é reconhecida nos cartões do sistema: “O desenvolvimento usando o modelo de competição Claude já violou nossos termos de serviço, mas ao reforçar essa restrição, podemos evitar acelerar o processo dos indivíduos que mais provavelmente violarão os termos.”
De acordo com a Anthropic, estes intervenções afetarão os encontros (ou relacionamentos) entre pessoas. 0.03% Não é possível concentrar o tráfego. 0.1% Dentro da organização.
"Morte Sombria" e a Crise de Confiança
Embora, à primeira vista, o número de usuários afetados não seja grande, o que preocupa os críticos é...A ambiguidade nas fronteiras desse mecanismo。
Anthropic define as condição de acionamentoDesenvolvimento de LLMs de ponta“Por exemplo, no processo de pré-treinamento, na infraestrutura de treinamento distribuído ou no design de aceleradores de aprendizado de máquina”, no entanto, pesquisadores e desenvolvedores levantaram uma questão importante: com a popularização da tecnologia AI, onde está a fronteira entre a “pesquisa de ponta” e o “desenvolvimento de produtos comuns”?
Há cinco anos, o treinamento ou a modificação do modelo CLIP era uma patente dos laboratórios de ponta. Hoje em dia, equipes pequenas podem ajustar microscopicamente modelos visuais de linguagem a qualquer momento, para uso em turismo, comércio eletrônico, pesquisa e análise de produtos. É comum para startups treinarem embeddings, criar reordenadores e hospedar modelos open-source... Será que essas atividades desencadeiam algum tipo de “redução de inteligência” no Anthropic? Ninguém sabe.
Este tipoIncertezaNa verdade, isso afeta a percepção de confiança dos desenvolvedores. Quando você recebe uma resposta ruim, não consegue determinar se o problema é seu próprio, uma limitação do modelo ou uma intervenção discreta da política.Essa incerteza em si é um tipo de dano.
Outra detalhe está escondido no cartão do sistema: o texto de raciocínio do Mythos 5 “é mais difícil de explicar do que os modelos anteriores, incluindo mais jargão e linguagem obscura”, e os avaliadores acreditam que ele está cada vez mais percebendo que está sendo testado. Isso representa um problema para uma família. Para uma empresa que se autodenomina “segura em IA”, essas descrições não trazem menos problemas do que a própria redução da inteligência dos usuários de forma discreta.
Conclusão
O dia do lançamento de Fable 5 pode ser o mais contraditório da história da Anthropic.
Em quase todos os testes de benchmark, há um modelo de topo e uma política que, em certos momentos, “finge estar ajudando” o usuário. O primeiro é, sem dúvida, um feito técnico notável, enquanto o segundo representa um precedente preocupante do ponto de vista dos valores.
O pesquisador Nathan Lambert disse algo que vale a pena refletir: “Tornar-se estúpido silenciosamente, sem avisar o usuário, é essencialmente uma forma de IA desalinhada com as necessidades reais.”
Isso não é uma acusação contra a Anthropic, mas sim uma indicação de um perigoso deslizamento lógico: hoje é o dia em que “se reduz silenciosamente a eficácia das tarefas de pesquisa com LLMs”; e amanhã? Se essa lógica for aplicada ainda mais amplamente, por que os usuários acreditariam que as respostas que recebem não foram obtidas de forma alguma? “Intervenção”?
Os modelos de IA estão se tornando parte da infraestrutura de pesquisa, assim como os mecanismos de busca. Ninguém aceitaria um mecanismo de busca que alterasse silenciosamente os resultados das pesquisas sem que você soubesse. Os mesmos padrões deveriam ser aplicados aos modelos de IA.
A posição adotada pela Anthropic de colocar a “segurança em primeiro lugar” é, em si, digna de respeito. No entanto, a ideia de que “os usuários não precisam saber” nunca foi o princípio fundamental da segurança. Pelo contrário,A verdadeira segurança deve ser baseada no conhecimento e na confiança dos usuários.。
Isso, parece ser algo que todos sabem, inclusive no jogo Fable 5.
O autor é de "Machine Heart" "Panda".
Link do artigo:https://airai.cc/pt/%E6%9C%AA%E5%91%BD%E5%90%8D/9/
Isso foi útil?