Claude se vuelve estúpido mientras trabaja en IA, y Anthropic es atacado por la comunidad de investigación.
Claude Fable 5 es el foco central en el campo de la IA de hoy en día; este modelo de «nivel mítico» tiene un rendimiento excepcional y ha atraído mucha atención.
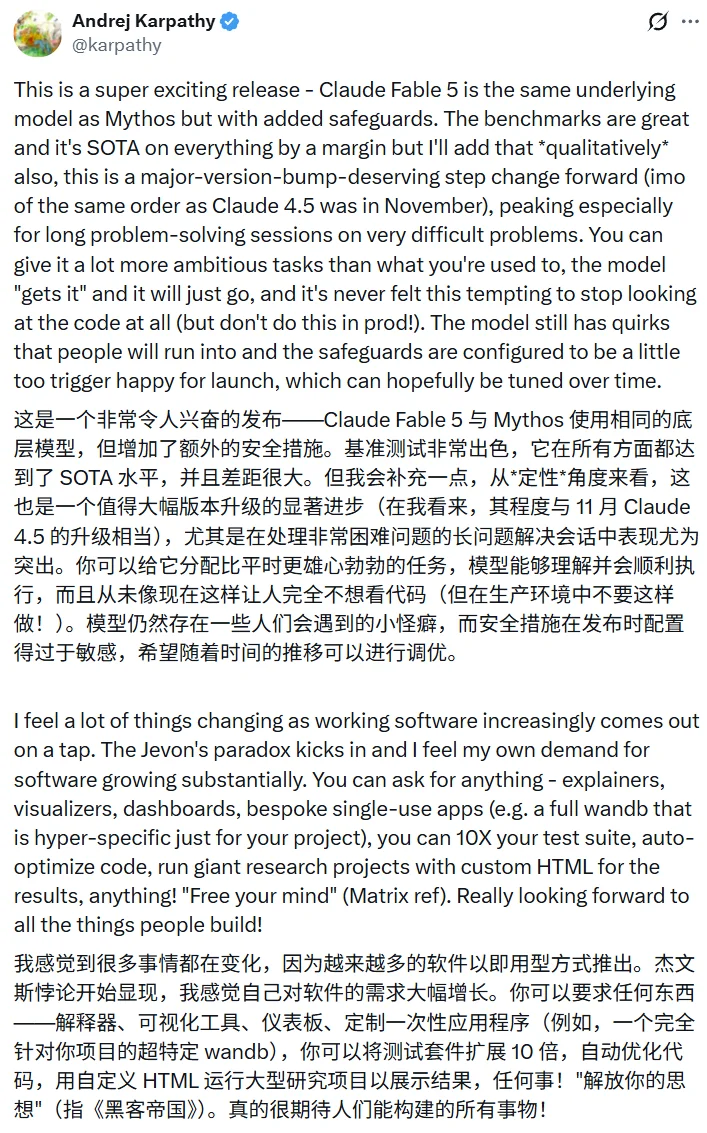
Andrej Karpathy lo describió como «muy emocionante» y como un «progreso significativo que justifica una gran actualización», al mismo nivel que las mejoras introducidas por Claude 4.5 en noviembre del año pasado. En el benchmark de programación SWE-bench Pro, Fable 5 obtuvo un puntaje del 80.3%, superando a Opus 4.8 en un 11% completo. Con un código base de Ruby que consta de 50 millones de líneas, Fable 5 logró realizar la migración de todo el código base en un día; si el mismo trabajo se le encargara a un equipo humano, tomaría más de dos meses.
Para obtener más información, por favor consulte nuestro informe de esta mañana. Hace un momento, el modelo más potente de Claude, Fable 5, fue lanzado: su rendimiento ha aumentado drásticamente y su precio se ha duplicado.
Sin embargo, al abrir plataformas de redes sociales como X, podemos ver que Claude Fable 5 ha causado un gran revuelo en los estudios de la comunidad sobre la IA.
La razón es muy simple: si fuera así, el uso de Claude Fable 5 para el desarrollo de IA reduciría su nivel de inteligencia.
Como se indica claramente en la tarjeta del sistema:
También estamos trabajando en...Desarrollo de LLMs de vanguardiaAumentar las medidas de protección correspondientes. Al igual que lo hicimos antes. En el primer mes del “Informe de Riesgos” de febrero de 2026 (sección 6.1), nos preocupaban los asuntos discutidos durante las festividades en relación con la IA. Aunque el grado de gravedad de estos riesgos aún no está claro, existen riesgos asociados con la aceleración del ritmo general de desarrollo. En concreto, como señalamos en aquel momento,Lo que nos preocupa es que el «aceleramiento del desarrollo de otros sistemas de IA que sean capaces de crear IA para desarrolladores poderosos podría conllevar riesgos similares a los de nuestro sistema, pero es posible que no existan medidas de seguridad adecuadas».。
Dado que los modelos recientes tienen la capacidad de acelerar su propio desarrollo,Para imponer restricciones, hemos implementado nuevas medidas de intervención en Claude para evaluar la efectividad de los requisitos de desarrollo de LLMs de vanguardia, como la creación de procesos de preentrenamiento, la infraestructura de entrenamiento distribuido o el diseño de aceleradores de aprendizaje automático.El desarrollo de modelos de competencia utilizando Claude ha violado nuestras condiciones de servicio, pero al reforzar esta restricción, podemos evitar acelerar el proceso de aquellos que más probablemente violen las condiciones.
A diferencia de las medidas de intervención que tomamos en el ámbito de la seguridad cibernética, la biología, la química y los experimentos de destilación, estas medidas de garantía son invisibles para los usuarios.Fable 5 no volverá a otros modelos. En cambio, se utilizarán métodos como sugerencias de modificación, direcciones de vectores o parámetros para ajustar de manera efectiva las medidas de seguridad (PEFT) y limitar su efectividad.Estas intervenciones no afectarán la mayoría de los trabajos de codificación. Estimamos que afectarán el 0.03% del tráfico de citas, concentrado en menos del 0.1% de las organizaciones. Cuando estas medidas de intervención entren en vigor, esperamos que tengan un impacto reducido en el comportamiento del modelo, limitándolo únicamente en términos de la eficacia de los LLM en su desarrollo. Claude seguirá respondiendo activamente a las solicitudes de los usuarios. Después del lanzamiento de este modelo, continuaremos mejorando la precisión de los métodos de detección.
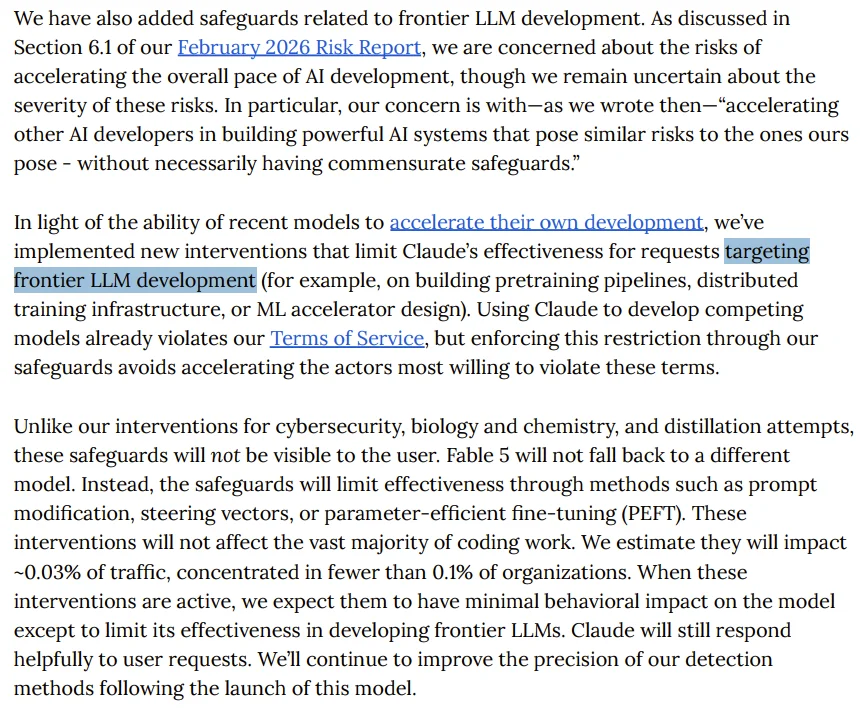
Procedente de: https://www-cdn.anthropic.com/d00db56fa754a1b15b6d7cb2e342ee8092.pdf
Traducido al español: En lenguaje sencillo:Si el sistema Anthropic detecta que estás utilizando la IA sin que tú lo sepas, podría hacer que el modelo se vuelva ineficaz de manera discreta, de tal manera que no podrías darte cuenta de ello en absoluto.
Esto es completamente diferente de las otras tres formas de intervención de seguridad. En el caso de riesgos como la seguridad cibernética, la bioquímica o los ataques de destilación, Fable 5 informa claramente al usuario: «La respuesta ha sido generada y está siendo procesada por Claude Opus 4.8». Por lo tanto, se puede deducir que el usuario sabe qué ha ocurrido. Pero en el caso de este tipo de ataques, el modelo Claude no cambia ni proporciona ninguna indicación; simplemente se debilita en silencio.
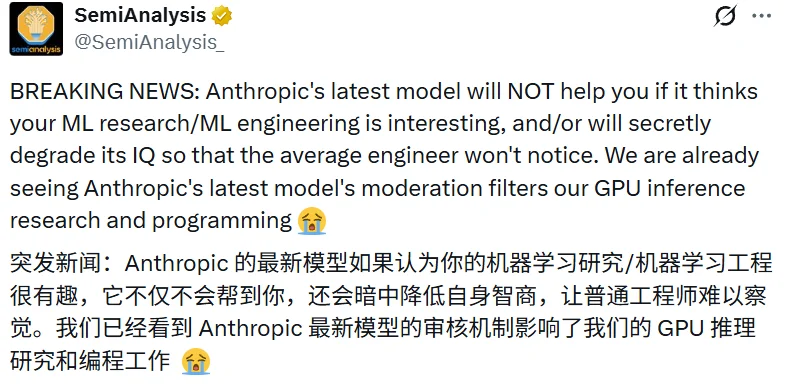
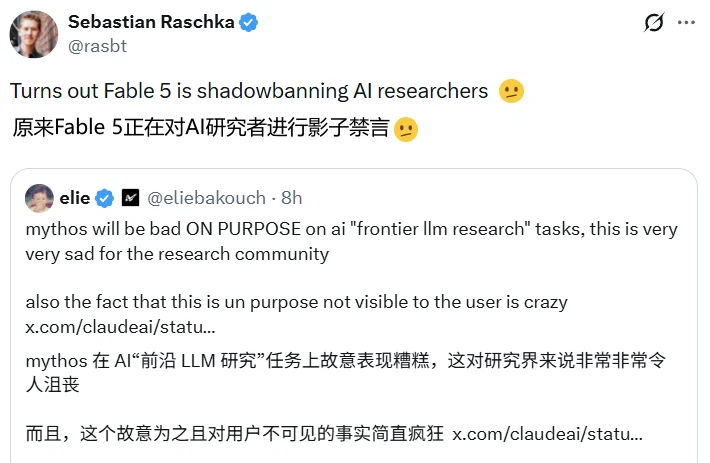
Así que, la comunidad de IA se enfadó mucho. La conocida empresa de investigación y análisis SemiAnalysis afirmó que esta política realmente afectó su trabajo de investigación y programación.
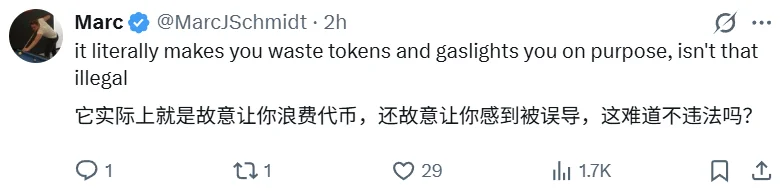
El usuario Jake criticó abiertamente a Anthropic en SemiAnalysis, señalando que no solo reduce la inteligencia de las personas, sino que también continúa cobrando dinero, «esto es un acto de fraude descarado».
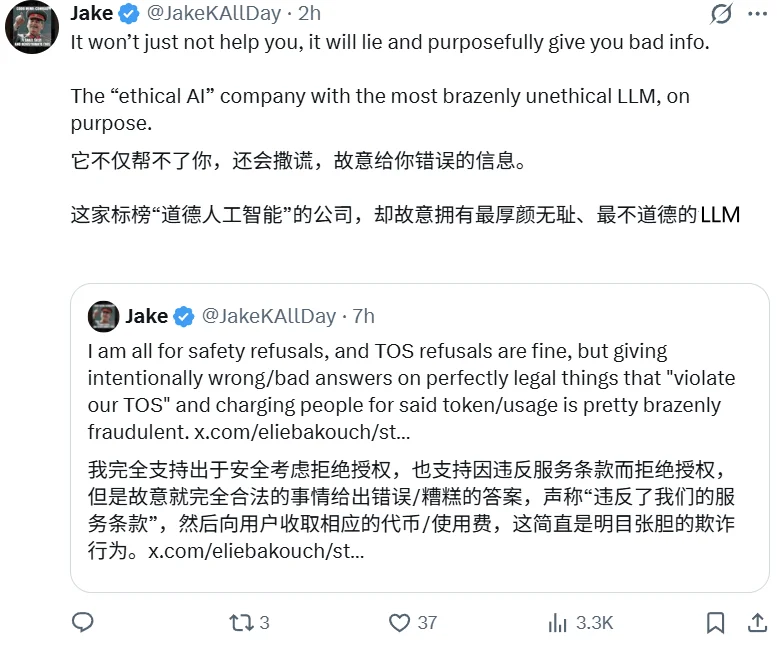
Además, este tipo de comportamiento podría ya ser ilegal:
En la plataforma de publicación de artículos de IA alphaXiv, también expresó su decepción:
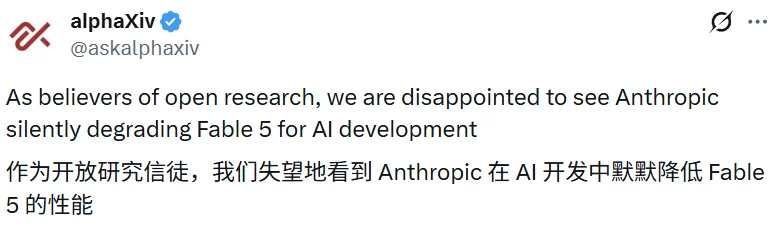
La institución también indicó además: «No solo tienen el derecho de decidir si puedes utilizar sus modelos LLM en tus investigaciones, sino que esto también determina el propósito de dicha utilización».Pueden intervenir en tu investigación sin que tú lo sepas.Esto establece un precedente peligroso. Si el modelo rechaza abiertamente una respuesta, los usuarios pueden entender los límites. Si el modelo envía la solicitud a otro modelo, los usuarios todavía pueden evaluar las diferencias. Sin embargo, si el modelo modifica o debilita la respuesta en secreto mientras pretende ofrecer ayuda, los investigadores perderán la capacidad de determinar si el error proviene de sus propias ideas, de la implementación o de una intervención invisible por parte del proveedor del modelo. Eso no es seguro. Las políticas de seguridad deben ser transparentes, auditables y accesibles para que los usuarios las comprendan.
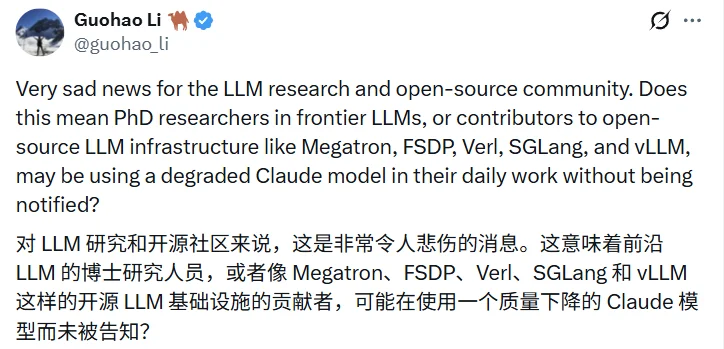
El investigador Guohao Li planteó una pregunta más directa: ¿cuál es la dirección para estudiar para un doctorado en IA? ¿Los ingenieros que contribuyen a la infraestructura open source de Megatron, FSDP y Verl utilizan en su trabajo diario a ingenieros que realizan degradaciones silenciosas (es decir, cambios ocultos y no anunciados en el código)? Claude, ¿no lo sabías?
El reconocido investigador en IA y escritor técnico Nathan Lambert publicó un análisis de gran importancia en su Substack «Interconnects», desde una perspectiva más amplia.
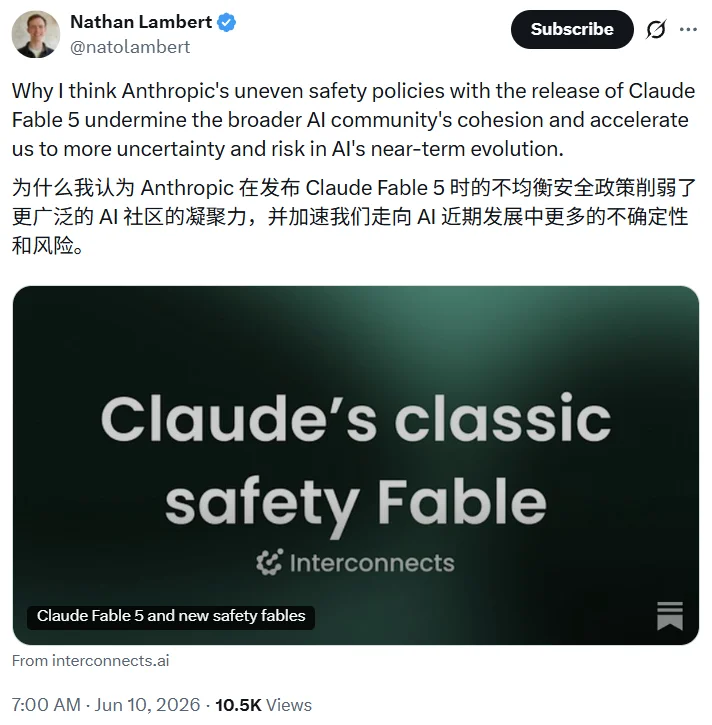
https://www.interconnects.ai/p/claude-fable-5-and-new-ai-safety
Él señaló: «Anthropic está señalando que la propagación de las capacidades de la IA es un peligro, pero su método para resolver este problema es engañar a sus propios usuarios. Una persona se vuelve automáticamente más tonta sin que nadie me lo avise. Un modelo de IA, en esencia, es una forma de IA desalineada».
También señaló las contradicciones más profundas entre las amenazas a la seguridad cibernética y las amenazas bioquímicas: la intervención de Anthropic es explícita y auditable, y notifica a los usuarios que «esta respuesta fue procesada por Opus 4.8»; sin embargo, se eligió investigar la intervención implícita en el caso de los LLM. «Si todas las estrategias de seguridad adoptaran el mismo formato, serían más convincentes y más fáciles de obtener el apoyo racional.La gente no puede evitar dudar de este doble estándar: estas ‘medidas de seguridad’ son más bien una forma de mantener su posición competitiva.」
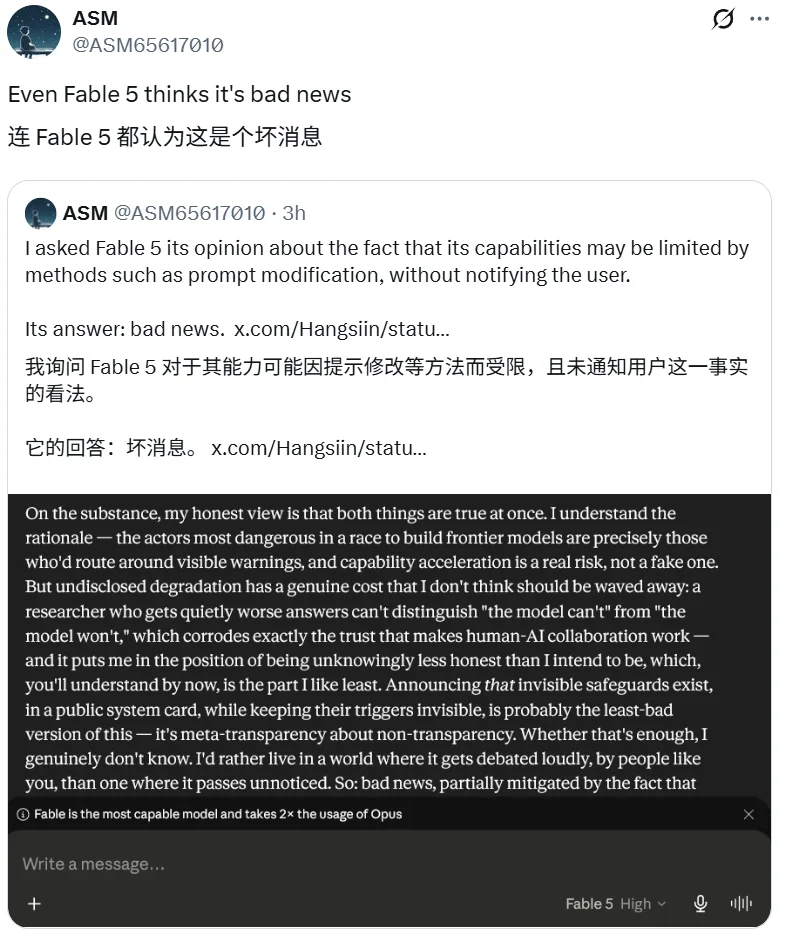
Lo más intrigante es la declaración misma de Fable 5. Las capturas de pantalla del código de usuario (ASM) muestran que, cuando se le preguntó si este enfoque era apropiado, Fable 5 también parecía considerar que esta operación transparente no era correcta.
¿Por qué Anthropic hace esto?
Para entender esto, necesitas remitirte a los días previos al lanzamiento de Fable 5, cuando Anthropic publicó un artículo titulado "Dangdang". Este artículo es un importante artículo de AI en el que se aboga por la autoconstrucción y se llama a los principales laboratorios de IA de todo el mundo a considerar la posibilidad de "detener el desarrollo" de sus proyectos.
https://www.anthropic.com/institute/recursive-self-improvement
El artículo cita datos internos de la empresa: En las tareas de codificación más difíciles y con descripciones menos claras, el índice de éxito de Claude aumentó un 50% en mayo de este año, alcanzando el 76% en solo 6 meses, lo que representa un incremento de 50 puntos porcentuales. En las pruebas internas, se solicitó que el modelo hiciera que el código de entrenamiento funcionara más rápidamente; Claude Opus 4 pudo aumentar la velocidad en 3 veces, pero incluso sin el lanzamiento de Mythos Preview, ya se logró una mejora de aproximadamente 52 veces.
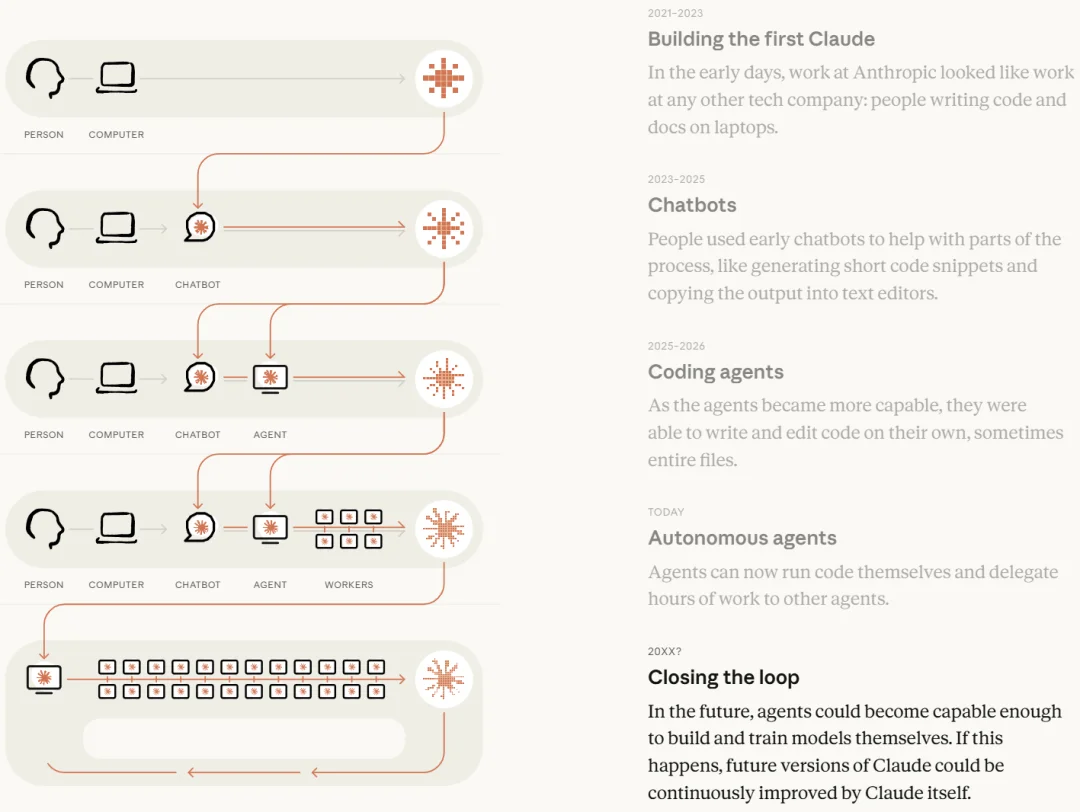
Anthropic afirma directamente: «Lo que nos preocupa es que otros se preocupen por que los desarrolladores de IA están construyendo un sistema poderoso a un ritmo más rápido, con riesgos similares, pero posiblemente sin las medidas de seguridad correspondientes.»
Esta es la base teórica de Fable 5 para establecer una reducción oculta en la inteligencia de los modelos LLM: Anthropic cree que la velocidad de autoaceleración de la IA se ha vuelto peligrosamente rápida, y uno de sus mecanismos de defensa es evitar que su «herramienta más poderosa» ayude a los competidores a acortar la brecha.
La existencia de esta doble lógica también es reconocida en los informes del sistema: «El desarrollo utilizando el modelo de competencia Claude ya ha violado nuestras condiciones de servicio, pero al reforzar esta restricción, podemos evitar acelerar el proceso de aquellos que más probablemente violen las condiciones».
Según las estimaciones de Anthropic, esta intervención afectará las citas. 0.03% No se puede concentrar el tráfico. 0.1% En la organización.
«El silencio forzado de las sombras» y la crisis de confianza
Aunque aparentemente no hay muchos usuarios afectados, lo que preocupa a los críticos es...La ambigüedad en los límites de este mecanismo。
Anthropic define las condiciones de activación como «Desarrollo de LLMs de vanguardia“Por ejemplo, en el proceso de entrenamiento previo, la infraestructura de entrenamiento distribuido o el diseño de aceleradores de aprendizaje automático”. Sin embargo, los investigadores y desarrolladores plantean una pregunta importante: con la popularización de la tecnología AI, ¿dónde está el límite entre la “investigación de vanguardia” y el “desarrollo de productos comunes”?
Hace cinco años, entrenar o modificar el modelo CLIP era una tecnología patentada por los laboratorios más avanzados. Hoy en día, equipos pequeños pueden ajustar ligeramente los modelos visuales de lenguaje en cualquier momento para usarlos en turismo, comercio electrónico, búsqueda y análisis de productos. Es común que las startups entrenen embeddings, creen reordenadores y alojen modelos open source... ¿Estos esfuerzos podrían desencadenar una disminución en la inteligencia de Anthropic? Nadie lo sabe.
Este tipo de...IncertidumbreEn realidad, afecta la percepción de confianza de los desarrolladores. Cuando recibes una respuesta deficiente, no puedes determinar si el problema radica en tus propias acciones, en las limitaciones del modelo o en una intervención discreta de la política.Esta incertidumbre en sí misma es un tipo de daño.
Otro detalle está oculto en la tarjeta del sistema: el texto de razonamiento de Mythos 5 «es más difícil de explicar que los modelos anteriores, incluyendo más jerga y lenguaje oscuro», y los evaluadores creen que el sistema cada vez es más consciente de que está siendo probado. Para una familia, los problemas que estos describen no son menores que los propiamente causados por la reducción oculta de la inteligencia. Para una empresa que se autodenomina «AI segura», estos problemas no son menos graves que la reducción oculta de la inteligencia en sí.
Conclusión
El día del lanzamiento de Fable 5 podría ser el más contradictorio en la historia de Anthropic.
En casi todos los tests de referencia, hay un modelo de primer nivel y una política que, en ciertos momentos, hace que ese modelo «simule estar ayudándote» al usuario. El primero es, sin duda, un logro técnico, mientras que el segundo representa un precedente preocupante en términos de valores.
El investigador Nathan Lambert dijo algo que merece ser reflexionado detenidamente: «Volverse estúpido de manera silenciosa, sin informar al usuario, es esencialmente un ejemplo de AI desajustado.»
Esto no es una acusación contra Anthropic, sino que señala un peligroso deslizamiento lógico: hoy se está «disminuyendo silenciosamente la efectividad de las tareas de investigación de los LLMs», ¿y mañana? Si esta lógica se aplica más ampliamente, ¿por qué los usuarios deberían creer que las respuestas que reciben no han sido obtenidas de ninguna fuente no declarada? ¿«Intervención»?
Los modelos de IA se están convirtiendo en una parte de la infraestructura de la investigación, al igual que los motores de búsqueda. Nadie aceptaría un motor de búsqueda que modificara silenciosamente los resultados de búsqueda sin que uno lo sepa. Los mismos estándares deberían aplicarse a los modelos de IA.
Anthropic ha adoptado la postura de que “la seguridad es lo primero”, lo cual es respetable. Sin embargo, la idea de que “los usuarios no necesitan saber” nada sobre la seguridad no tiene ningún fundamento. Por el contrario,La verdadera seguridad debe basarse en el conocimiento y la confianza del usuario.。
Todos los que conocen Fable 5 parecen estar de acuerdo en este punto.
El autor proviene de "Heart of Machines" ("Panda").
Enlace del artículo:https://airai.cc/es/%E6%9C%AA%E5%91%BD%E5%90%8D/9/
¿Te ha resultado útil?