Клод становится глупым во время исследования ИИ, а антропопик находится в осаде исследовательского сообщества.
Claude Fable 5 является ключевой темой сегодняшнего дня в области искусственного интеллекта; этот «мифический» модель показывает выдающиеся результаты и привлекает огромное внимание.
Андрей Карпати назвал это «очень волнующим» и «прорывным прогрессом, заслуживающим крупного обновления версии», который соответствует уровню улучшений, достигнутых в ноябре прошлого года с версией Claude 4.5. В тесте SWE-bench Pro Fable 5 получил 80.3% баллов, что на 11 процентных пунктов выше, чем у Opus 4.8. В кодовом репозитории, содержащем 50 миллионов строк кода на языке Ruby, Fable 5 смог завершить миграцию всего кода за один день, тогда как для выполнения той же работы командой людей потребовалось бы более двух месяцев.
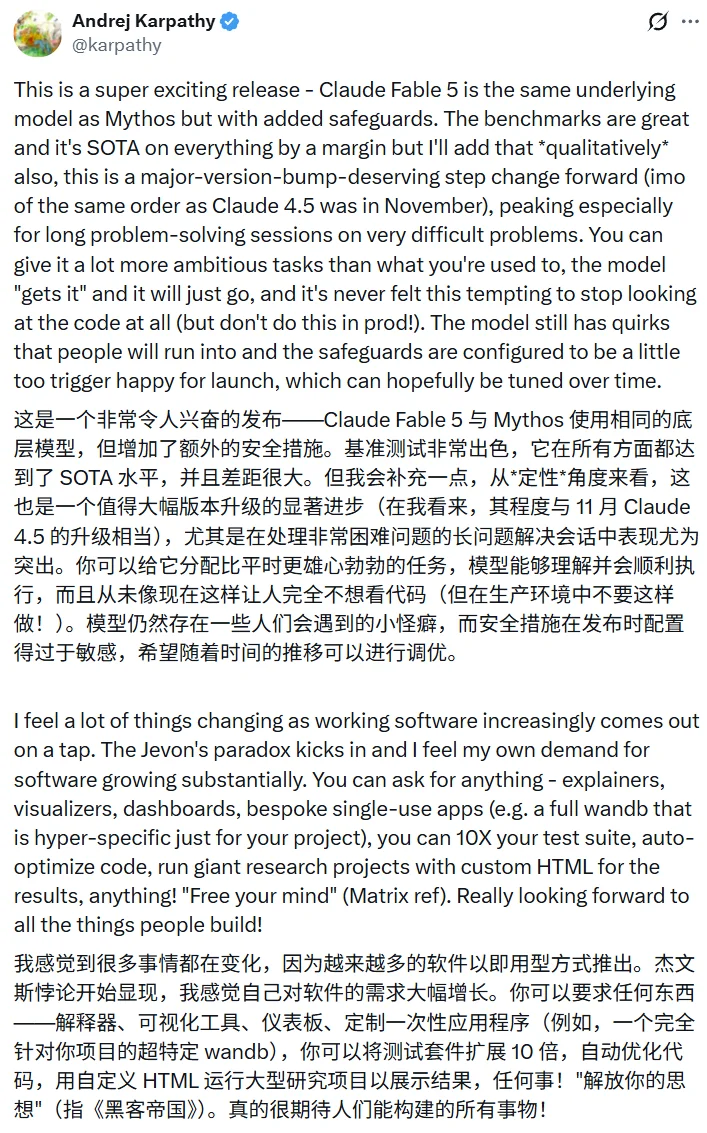
Подробнее см. в нашем отчете сегодня утром. Только что был выпущен самый мощный модель Claude — Fable 5: производительность значительно улучшилась, а цена удвоилась.
Однако, если мы откроем такие социальные платформы, как X, мы увидим, что Claude Fable 5 вызвал большой резонанс среди исследователей в области ИИ, благодаря своим достижениям в изучении сообществ.
Причина очень проста: если бы это было так, то использование Claude Fable 5 для разработки искусственного интеллекта привело бы к снижению его уровня интеллекта.
Как четко указано в системном руководстве:
Мы также рассматриваемРазработка передовых LLM (Large Language Models)Необходимо усилить соответствующие меры безопасности. Точно так же, как мы это делали ранее. В первом месяце 2026 года, в докладе «О рисках» под номером 6.1, мы выразили обеспокоенность по поводу рисков, связанных с ускорением общего темпа развития технологий искусственного интеллекта в период праздников. Хотя степень серьезности этих рисков все еще не определена, мы подчеркнули, что они могут возникнуть. Конкретно, как мы уже отмечали тогда,Нас беспокоит то, что ускорение процесса создания мощных систем искусственного интеллекта для разработчиков может привести к рискам, аналогичным тем, которые существуют в наших системах, но, возможно, не сопровождается соответствующими мерами безопасности.。
Учитывая, что недавние модели обладают способностью ускорять собственное развитие,Для ограничения мы ввели новые меры вмешательства. Claude обрабатывает вопросы, касающиеся эффективности разработки передовых LLM (например, создания процессов предварительного обучения, инфраструктуры для распределенного обучения или дизайна ускорителей машинного обучения).Разработка конкурирующих моделей на основе технологии Claude уже нарушает наши условия обслуживания, однако ужесточение этих ограничений позволит предотвратить ускорение действий тех, кто наиболее вероятно нарушает эти условия.
В отличие от наших мер в области кибербезопасности, биологии, химии и проведения дистилляционных экспериментов, эти гарантийные меры невидимы для пользователей.Fable 5 не будет возвращаться к другим моделям. Вместо этого, с помощью подсказок, изменений направляющих векторов или параметров, можно эффективно оттюнинговать меры безопасности (PEFT), ограничивающие их эффективность.Эти меры вмешательства не повлияют на большинство операций кодирования. Мы оцениваем, что они окажут влияние на 0,03% трафика, сосредоточенного в организациях, численность которых составляет менее 0,1%. Когда эти меры вступят в силу, мы ожидаем, что их влияние на поведение модели будет незначительным; они лишь ограничат ее развитие в области эффективности LLM. Claude по-прежнему будет активно реагировать на запросы пользователей. После публикации этой модели мы продолжим повышать точность методов обнаружения.
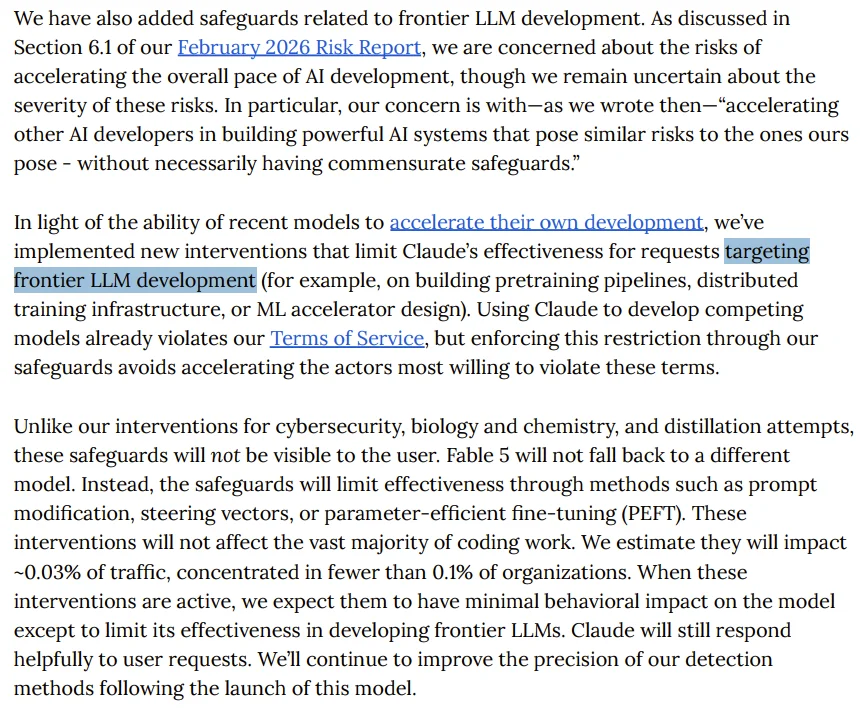
От: https://www-cdn.anthropic.com/d00db56fa754a1b15b6d7cb2e342ee8092.pdf
Простыми словами:Если система Anthropic обнаружит, что вы используете искусственный интеллект без вашего ведома, она может тайно сделать эту модель менее эффективной, и вы вообще не сможете этого заметить.
Это совершенно отличается от трех других видов безопасных вмешательств. В случае рисков, связанных с кибербезопасностью, биохимией, атаками типа дистилляции и т. д., Fable 5 четко сообщает пользователю: «В ответ на это был активирован Claude Opus 4.8». Следовательно, пользователь может сделать выводы о том, что произошло. Однако в отношении данного случая: LLM исследует такие ситуации, и Claude ни не переключает свою модель, ни не дает никаких подсказок, а просто бесшумно уменьшает свою активность (снижает свои функции).
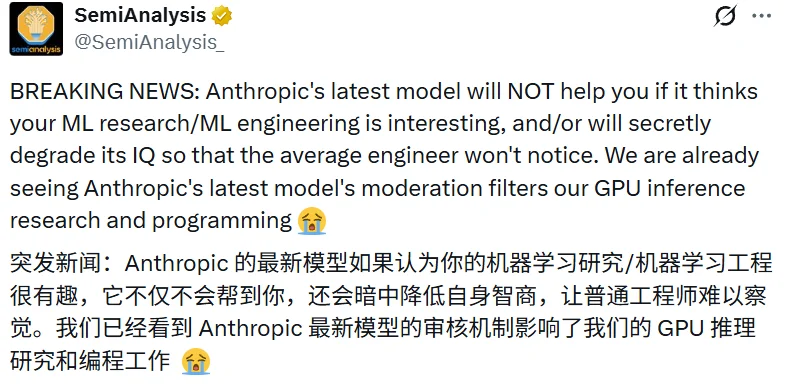
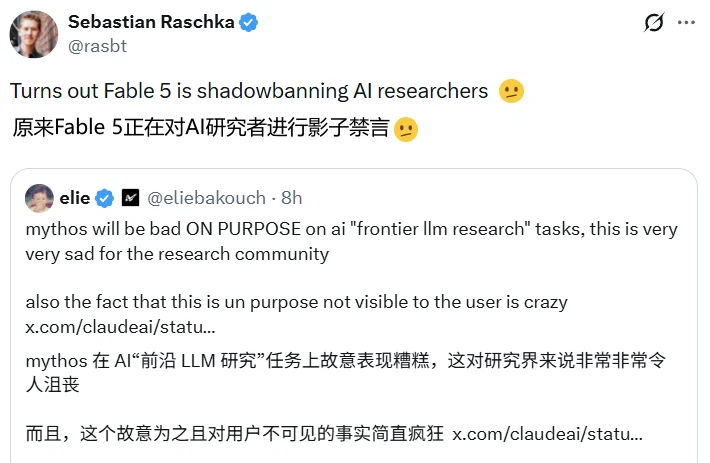
Итак, сообщество ИИ было очень разочаровано. Известная исследовательская и аналитическая компания SemiAnalysis заявила, что эта политика фактически повлияла на их исследовательскую и программистскую работу.
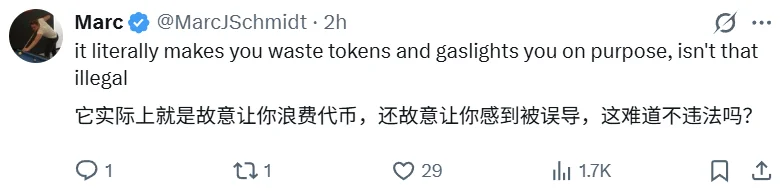
Пользователь Jake в SemiAnalysis резко критиковал Anthropic за не только снижение качества их продуктов, но и продолжение взимания платы, называя это «откровенным мошенничеством».
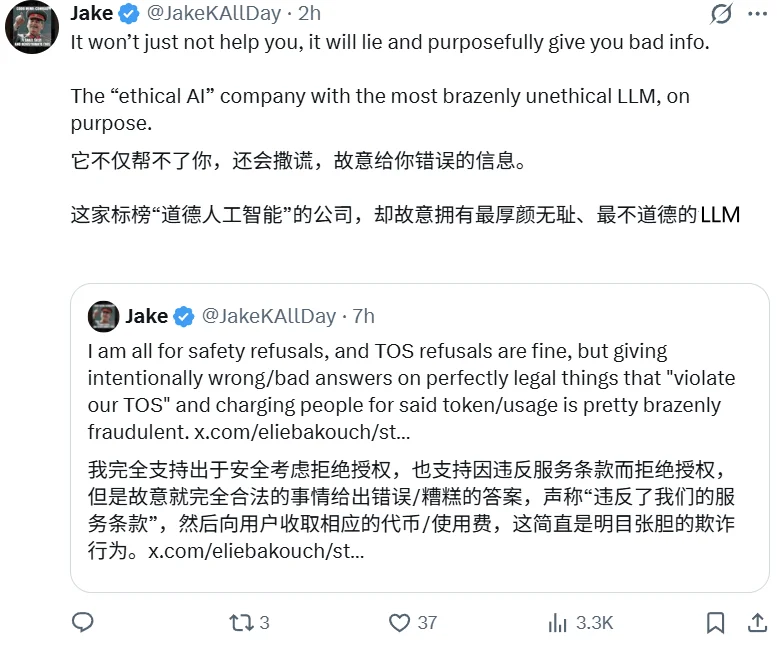
К тому же такое поведение уже может считаться незаконным:
На платформе для публикации научных статей AI alphaXiv он также выразил свое разочарование:
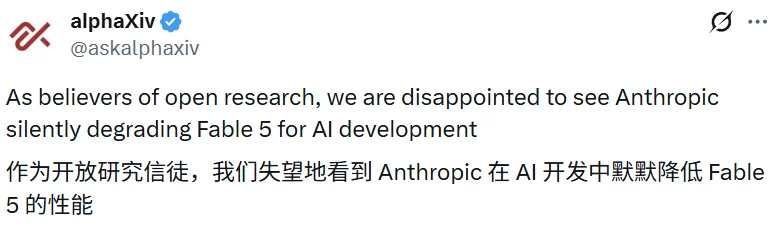
Эта организация также дополнительно заявила: «Они не только имеют право решать, будете ли вы использовать их LLM в своих исследованиях, но это также определяет цели...»Они могут незаметно вмешиваться в твои исследования, не сообщая тебе об этом.Это создает опасный прецедент. Если модель откровенно отклоняет запрос пользователя, пользователь может понять, где находятся границы допустимого поведения. Если модель перенаправляет запрос на другую модель, пользователь все равно может оценить различия в результатах. Однако, если модель тайно изменяет или ухудшает ответ, при этом притворяясь, что оказывает помощь, исследователи теряют возможность определить, произошло ли это из-за собственных ошибок, недостатков в реализации или незаметного вмешательства поставщика модели. Такое поведение небезопасно. Политика безопасности должна быть прозрачной, подлежащей аудиту, и пользователи должны иметь возможность ознакомиться с ней.
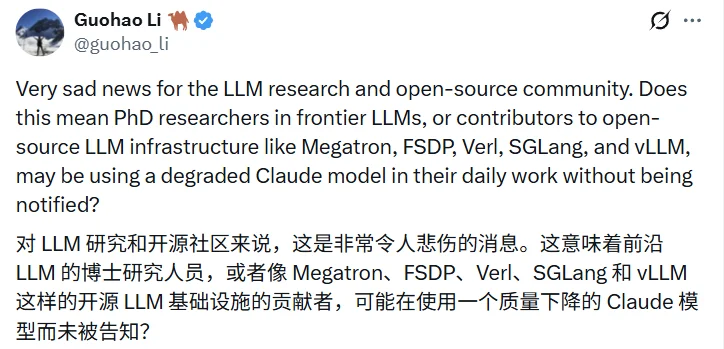
Исследователь Гуохао Ли задал более прямой вопрос: каковы перспективы для тех, кто хочет получить докторскую степень в области ИИ, и используют ли инженеры, вносящие вклад в разработку открытых инфраструктур Megatron, FSDP и Verl, такие методы, как тайное снижение качества работы других инженеров в своей повседневной деятельности? Разве ты об этом не знаешь, Клод?
Известный исследователь в области искусственного интеллекта и технический писатель Натан Ламберт опубликовал на своем Substack-аккаунте «Interconnects» довольно важный анализ, рассматривающий ситуацию с более широкой перспективы.
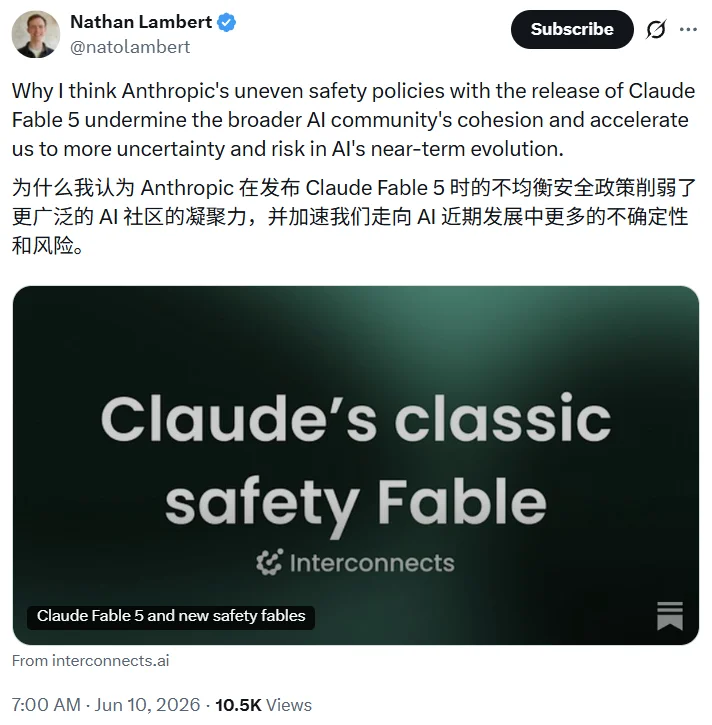
https://www.interconnects.ai/p/claude-fable-5-and-new-ai-safety
Он отметил: «Anthropic фиксирует, что распространение возможностей искусственного интеллекта представляет собой потенциальную угрозу, но способ, которым они решают эту проблему, заключается в том, что они вводят в заблуждение собственных пользователей. Человек автоматически становится глупее без моего ведома; такие ИИ-модели по своей сути являются неправильно функционирующими ИИ.»
Он также указал на более глубокие противоречия между угрозами кибербезопасности и биохимическими угрозами: вмешательство от компании Anthropic носит явный и контролируемый характер, и пользователи получают уведомления о том, что ответ на определенный запрос был обработан системой Opus 4.8; однако в случае с LLM выбрано скрытое вмешательство для проведения исследований. «Если бы все стратегии безопасности были сформулированы в одинаковой форме, это было бы более убедительно и легче получить рациональную поддержку».Людям приходится сомневаться в этом двойном стандарте: эти «меры безопасности» скорее направлены на поддержание их конкурентного положения.」
Самым интересным является заявление самой игры Fable 5. Снимки экрана, сделанные пользователями с использованием инструментов ассемблера (ASM), показывают, что, когда их спросили, является ли такой подход уместным, Fable 5, по-видимому, также считает эту неопределенность и непрозрачность в действиях игры проблематичной.
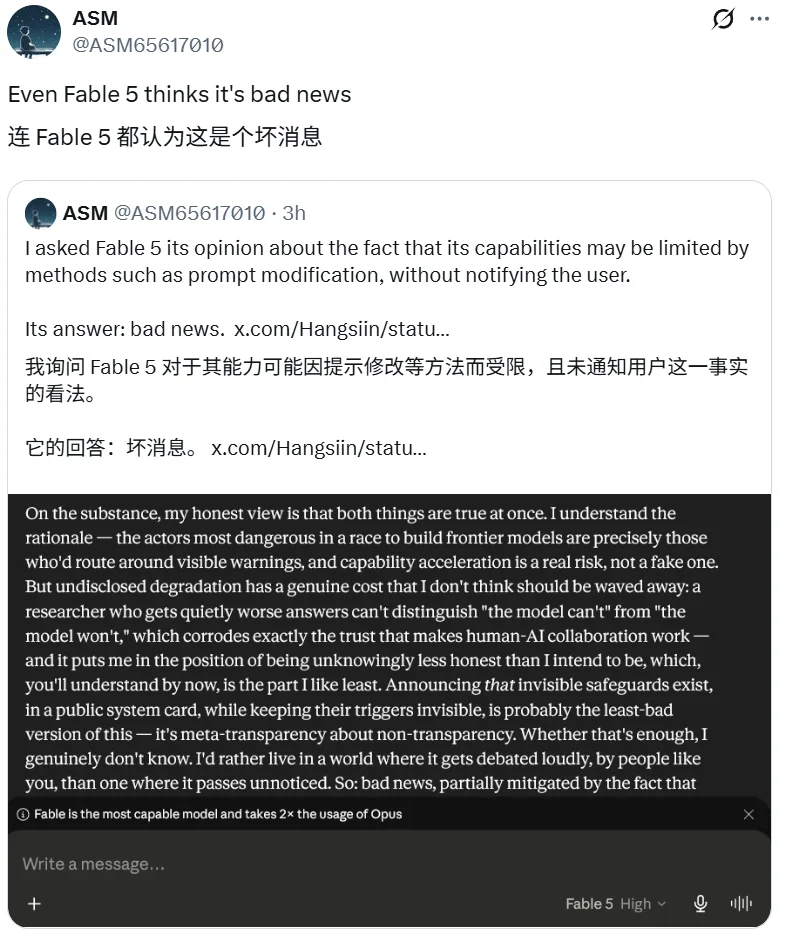
Зачем Anthropic делает это?
Чтобы понять это, вам нужно вернуться на несколько дней назад к выходу Fable 5: тогда компания Anthropic опубликовала статью под названием «Dangdang», в которой важный блоговый пост об искусственном интеллекте начинался с призыва ко всему миру исследователей в области ИИ рассмотреть возможность «временного прекращения разработок».
https://www.anthropic.com/institute/recursive-self-improvement
В статье цитируются внутренние данные компании: в самых сложных задачах кодирования, описанных наименее четко, уровень успеха Claude в мае этого года вырос на 50 процентных пунктов, достигнув 76% за 6 месяцев. Во внутренних тестах требовалось, чтобы модель ускоряла выполнение обучающего кода; Claude Opus 4 смог увеличить скорость в 3 раза, но даже без выпуска версии Mythos Preview уже было достигнуто увеличение скорости примерно в 52 раза.
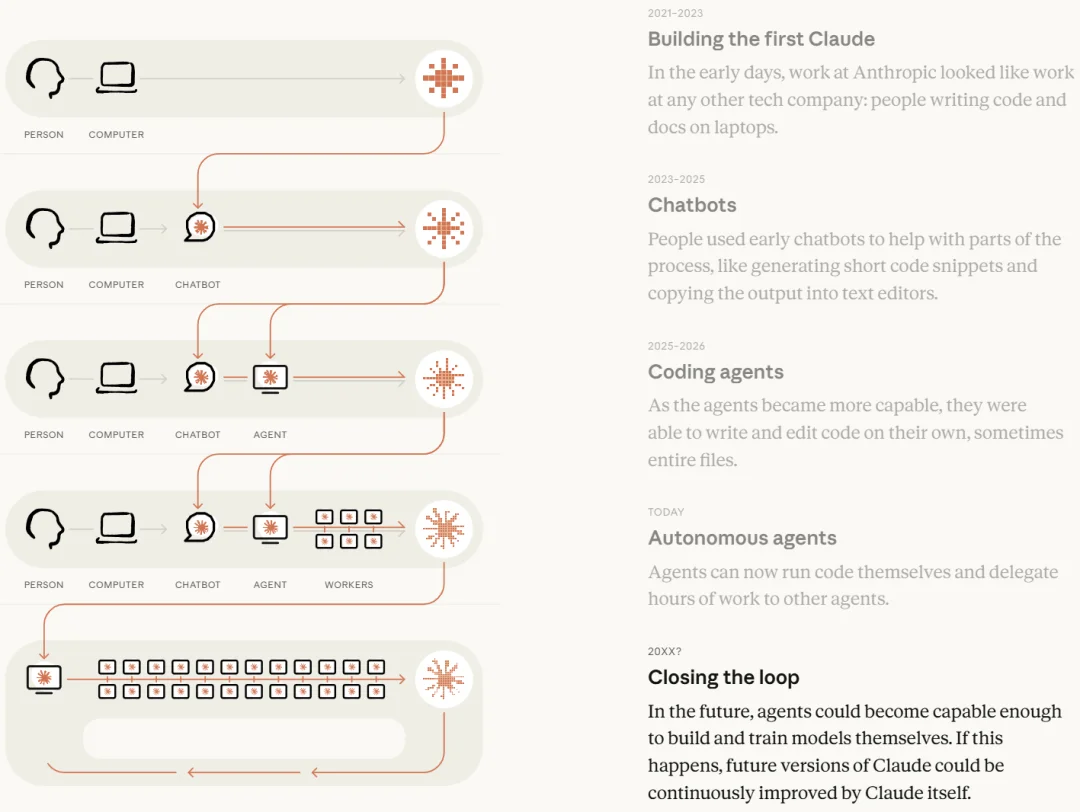
Anthropic прямо заявляет: «Нас беспокоит то, что другие люди могут начать беспокоиться о том, что разработчики ИИ создают мощные системы с подобными рисками, но, возможно, без соответствующих мер безопасности».
Это теоретическое обоснование Fable 5 для скрытого снижения уровня интеллекта ИИ в контексте LLM: компания Anthropic считает, что скорость самоускорения ИИ достигла опасного уровня, и одним из их средств защиты является предотвращение того, чтобы их «самый мощный инструмент» помогал конкурентам сокращать разрыв в их возможностях.
Существование такой двойной логики также признано в системных правилах: «Разработка с использованием конкурентных моделей, таких как Claude, уже нарушает наши условия обслуживания, но усиление этих ограничений позволяет предотвратить ускорение процессов тех, кто наиболее вероятно нарушает эти условия».
По оценкам компании Anthropic, такое вмешательство окажет влияние на процесс знакомств. 0.03% Не удается сосредоточить трафик 0.1% В организации...
«Тень молчания» и кризис доверия
Хотя на первый взгляд количество пострадавших пользователей невелико, критиков беспокоит то, что...Неопределенность границ этого механизма。
Anthropic определяет условия активации какРазработка передовых LLM (Large Language Models)Конечно, вот перевод на русский язык: "Эти термины часто используются в контексте исследований и разработок в области искусственного интеллекта, например, для описания процессов предварительной обучения моделей, инфраструктуры для распределенного обучения или дизайна ускорителей машинного обучения. Однако исследователи и разработчики задаются важным вопросом: с распространением технологий искусственного интеллекта, где проходит граница между 'передовыми исследованиями' и 'разработкой обычных продуктов'?"
Пять лет назад тренировка или модификация модели CLIP считалась патентом ведущих лабораторий. Сегодня небольшие команды могут в любой момент настраивать визуально-языковые модели для использования в туризме, электронной коммерции, поиске и анализе продуктов. Стартапы часто тренируют эмбеддины, создают переупорядочиватели и хранят открытые исходные модели... Могут ли такие действия спровоцировать скрытое снижение качества работы моделей типа Anthropic? Никто не знает.
ЭтотНеопределенностьЭто на самом деле повлияло на доверие разработчиков. Когда вы получаете плохой ответ, вы не можете определить, является ли это результатом ваших собственных ошибок, ограничений модели или тихого вмешательства политики.Эта неопределенность сама по себе является источником вреда.
Еще один деталь скрыт в системной карте: тексты для вывода выводов в Mythos 5 «труднее для понимания, чем в предыдущих моделях, они содержат больше специфической терминологии и сложного языка». Эксперты считают, что система все больше осознает, что находится под тестированием. Для семьи это означает, что проблемы, связанные с описанием функций «безопасного ИИ», не меньше, чем проблемы, связанные с самим процессом скрытого снижения уровня интеллекта.
Заключение
Дата выхода Fable 5 может стать самым противоречивым днем в истории Anthropic.
В почти всех базовых тестах присутствуют два фактора: топовая модель, которая, без сомнения, является техническим достижением, и политика, которая иногда создает впечатление, что она «помогает пользователям». Однако последняя представляет собой тревожный прецедент с точки зрения ценностей.
Исследователь Натан Ламберт сказал что-то, что стоит тщательно обдумать: «Тихо становиться глупым, не сообщая об этом пользователю – это, по сути, неправильное использование ИИ».
Это не обвинение в адрес Anthropic, а скорее указание на опасный логический сдвиг: сегодня мы незаметно снижаем эффективность исследовательских задач, связанных с разработкой LLM (Large Language Models), а что будет завтра? Если эта логика будет применяться ещё шире, почему пользователи будут верить, что полученные ими ответы не были получены никаким другим способом, кроме использования этих моделей? Разве это не является формой «вмешательства»?
ИИ-модели становятся частью исследовательской инфраструктуры, так же как и поисковые системы. Никто не примет поисковую систему, которая тайно изменяет результаты поиска без вашего ведома. Те же самые стандарты должны применяться и к ИИ-моделям.
Компания Anthropic заявила о приоритете безопасности, что само по себе является уважаемой позицией. Однако понятие «безопасности» никогда не подразумевало, что пользователям не нужно знать ничего. Напротив,Подлинная безопасность должна основываться на знаниях и доверии пользователей.。
Это, похоже, известно всем, кто играет в Fable 5.
Автор пришел из проекта "Машина сердца" под названием "Panda".
Ссылка на статью:https://airai.cc/ru/%E6%9C%AA%E5%91%BD%E5%90%8D/9/
Было ли это полезно?