Während der KI-Forschung wird Claude dumm, Anthropic wird von der Forschungsgemeinschaft belagert
Claude Fable 5 ist heute das zentrale Thema im Bereich KI und dieses „mythologische“ Modell zeichnet sich durch hervorragende Leistung aus, was es zu einer großen Attraktion macht.
Andrej Karpathy bezeichnet dies als „sehr aufregend“ und als einen „sprunghaften Fortschritt, der einer großen Versionserweiterung würdig ist“ – auf dem gleichen Niveau wie die Verbesserungen, die im November letzten Jahres mit Claude 4.5 eingeführt wurden. Im SWE-bench Pro-Programmierbenchmark erzielte Fable 5 eine Punktzahl von 80,3%, was 11 Prozentpunkte mehr sind als Opus 4.8. Mit einem Ruby-Codebase, der aus 50 Millionen Zeilen besteht, gelang die vollständige Migration des Codebasses innerhalb eines Tages. Würde dieselbe Aufgabe einem menschlichen Team übertragen, würde dies mehr als zwei Monate in Anspruch nehmen.
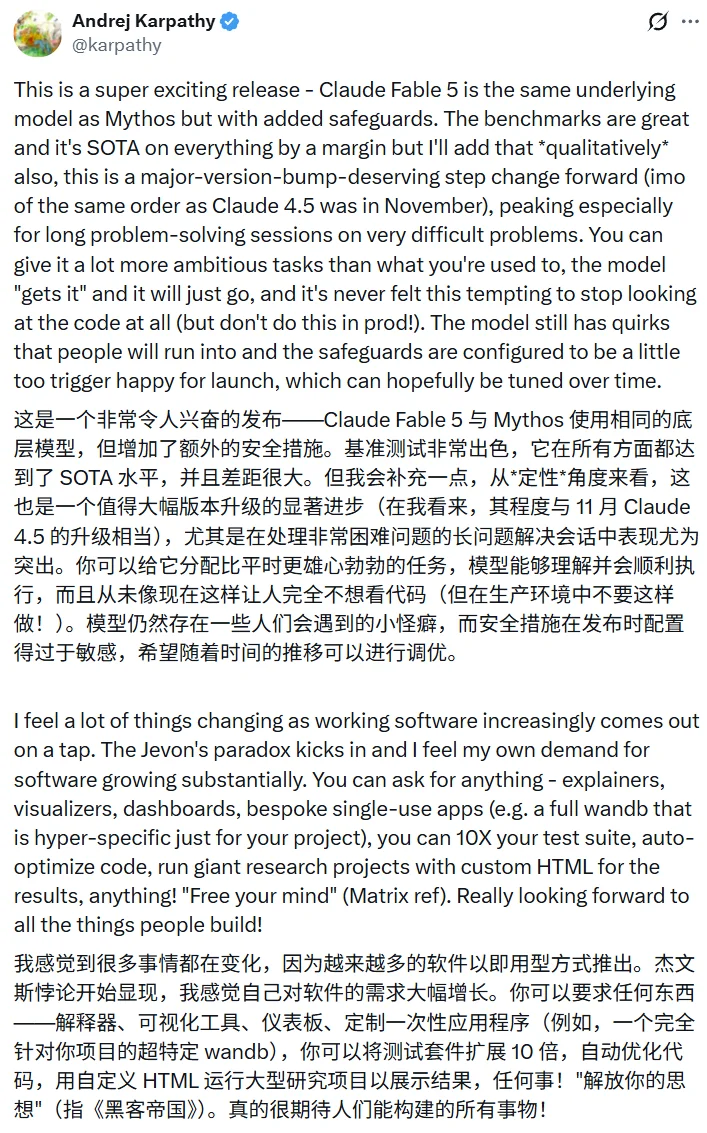
Für weitere Informationen bitte sehen Sie unseren Bericht von heute Morgen. Just jetzt wurde das leistungsstärkste Modell von Claude, Fable 5, veröffentlicht: Die Leistung ist enorm gestiegen und der Preis hat sich verdoppelt.
Allerdings, wenn wir soziale Plattformen wie X öffnen, können wir sehen, dass Claude Fable 5 für Aufsehen gesorgt hat, da die Forschung von KI in der Community große Resonanz gefunden hat.
Der Grund ist einfach: Wenn das der Fall wäre und Claude Fable 5 tatsächlich zur Entwicklung von KI verwendet würde, würde dies zu einer Verringerung der Intelligenz führen.
Wie aus der Systembeschreibung deutlich hervorgeht:
Wir haben uns auch aufEntwicklung von Frontiers LLMsErhöhen Sie die entsprechenden Sicherheitsmaßnahmen. Genau wie wir es getan haben. Im ersten Monat des Risikoberichts für Februar 2026, Seite 6.1, haben wir uns über die Dinge gesorgt, die während der Feiertage besprochen wurden – insbesondere die Risiken, die mit der Beschleunigung des allgemeinen Entwicklungsfortschritts verbunden sind, obwohl die Schweregrad dieser Risiken noch unklar ist. Genauer gesagt, wie wir damals bereits angemerkt haben…Wir befürchten, dass die Beschleunigung des Aufbaus anderer KI-Systeme, die starke Entwickler-KI-Systeme schaffen, Risiken mit sich bringen könnte, ähnlich wie bei unserem System – allerdings könnten keine entsprechenden Sicherheitsmaßnahmen vorhanden sein.。
Angesichts der Tatsache, dass die Modelle in letzter Zeit die Fähigkeit entwickelt haben, ihre eigene Entwicklung zu beschleunigen,Um die Beschränkungen einzuhalten, haben wir neue Maßnahmen ergriffen. Claude wird eingesetzt, um die Effektivität von Anforderungen im Bereich der Entwicklung fortschrittlicher LLMs zu überprüfen – beispielsweise bei der Erstellung von Vorverarbeitungsprozessen, der Bereitstellung von Infrastruktur für verteiltes Training oder der Konzeption von Maschinenlernen-Akzeleratoren.Die Entwicklung mit dem Claude-Wettbewerbsmodell hat bereits gegen unsere Dienstbedingungen verstoßen, aber durch die Verschärfung dieser Beschränkung können wir das Vorantreiben derjenigen verhindern, die am ehesten gegen die Bedingungen verstoßen werden.
Im Gegensatz zu unseren Eingriffen in den Bereich der Netzwerksicherheit, Biologie, Chemie und Destillationsversuche sind diese Sicherheitsmaßnahmen für die Nutzer unsichtbar.Fable 5 wird nicht zu anderen Modellen zurückkehren. Stattdessen werden die Sicherheitsmaßnahmen (PEFT) effektiv feinabgestimmt, indem Hinweise gegeben werden, Vektoren oder Parameter modifiziert werden, um ihre Wirksamkeit einzuschränken.Diese Eingriffe werden die meisten Kodierungsarbeiten nicht beeinflussen. Wir schätzen, dass sie etwa 0,03 Prozent des Datenverkehrs beeinflussen werden, der sich auf weniger als 0,1 Prozent der Organisationen konzentriert. Sobald diese Maßnahmen in Kraft treten, erwarten wir, dass sie sich kaum auf das Verhalten des Modells auswirken werden, sondern lediglich dessen Entwicklung in Bezug auf die Effektivität von LLMs einschränken. Claude wird weiterhin auf Anfragen der Nutzer reagieren. Nach der Veröffentlichung dieses Modells werden wir die Genauigkeit der Erkennungsmethoden weiter verbessern.
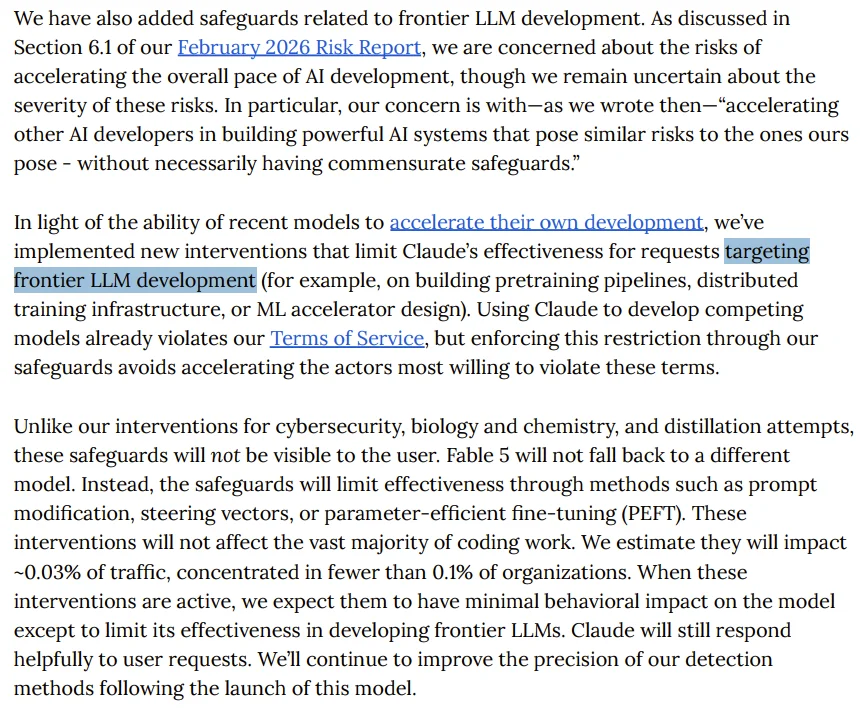
Von: https://www-cdn.anthropic.com/d00db56fa754a1b15b6d7cb2e342ee8092.pdf
Übersetzung ins Deutsche:Wenn das Anthropic-System feststellt, dass Sie mit KI arbeiten, ohne dass Sie es wissen, wird es heimlich dafür sorgen, dass dieses Modell „dumm“ wird – Sie werden es dann überhaupt nicht mehr finden können.
Dies unterscheidet sich völlig von den anderen drei Sicherheitsmaßnahmen. Bei Risiken wie Netzwerksicherheit, Biochemie oder Destillationsangriffen teilt Fable 5 den Benutzern klar mit: „Die Reaktion wurde von Claude Opus 4.8 verarbeitet.“ Daraus kann man schließen, dass die Benutzer wissen, was geschehen ist. Aber bei dieser Art von Angriff wechselt Claude als LLM weder das Modell noch gibt es irgendwelche Hinweise; es schwächt sich einfach still und leise ab.
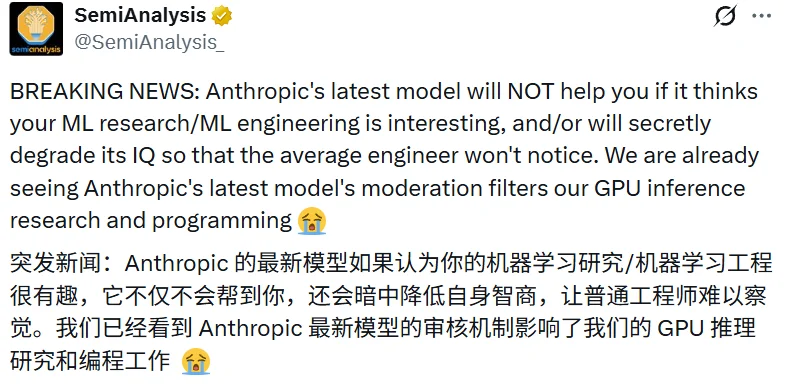
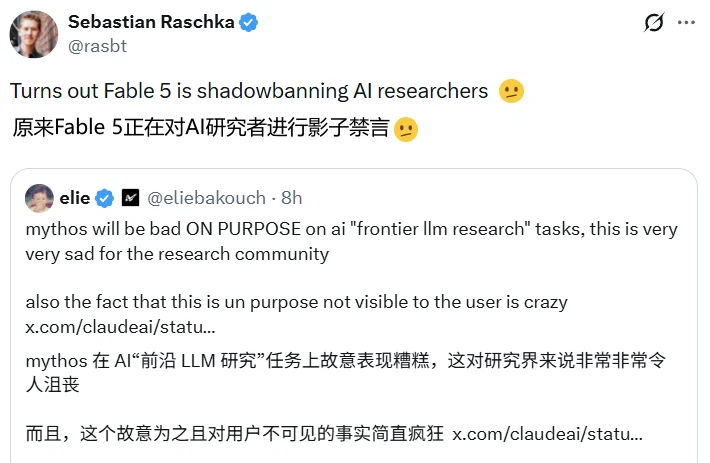
Daher ist die AI-Community sehr verärgert. Die bekannte Forschungs- und Analysefirma SemiAnalysis ist der Ansicht, dass diese Politik tatsächlich ihre Forschungs- und Programmierarbeiten beeinträchtigt.
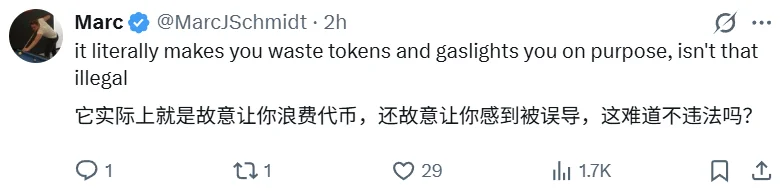
Der Nutzer Jake kritisierte in SemiAnalysis scharf, dass Anthropic nicht nur die Leistung der Nutzer verringert, sondern weiterhin Gebühren erhebt und bezeichnete dies als „offensichtliches Betrugsverhalten“.
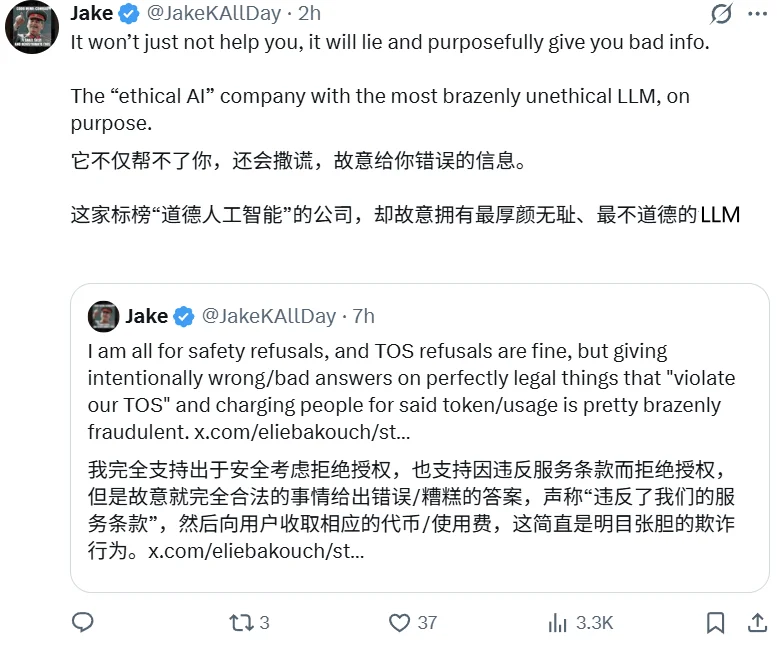
Und diese Art von Verhalten könnte bereits illegal sein:
Auf der AI-Forschungsplattform alphaXiv äußerte er auch seine Enttäuschung:
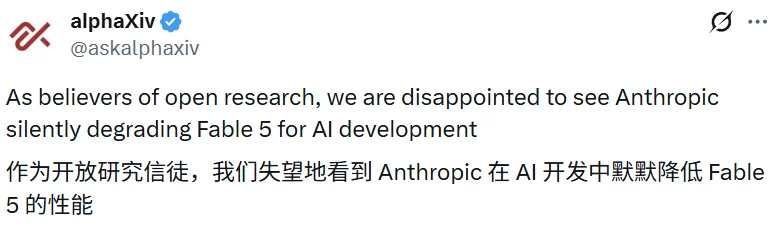
Die Institution hat weiterhin erklärt: „Sie haben nicht nur das Recht zu entscheiden, ob Sie ihre LLMs in Ihrer Forschung verwenden, sondern dies macht es auch möglich, das Ziel zu erreichen.“Sie können ohne dein Wissen stillschweigend in deine Forschung eingreifen.Dies schafft ein gefährliches Vorbild. Wenn das Modell eine Ablehnung öffentlich macht, können die Nutzer die Grenzen verstehen. Wenn das Modell zu einem anderen Modell weiterleitet, können die Nutzer den Unterschied immer noch bewerten. Wenn das Modell jedoch heimlich die Antwort ändert oder schwächt und gleichzeitig vorgibt, zu helfen, verlieren die Forscher die Fähigkeit, zu beurteilen, ob das Fehlschlagen auf ihre eigenen Ideen, ihre eigene Implementierung oder auf eine unsichtbare Einmischung des Modellanbieters zurückzuführen ist. Das ist nicht sicher. Die Sicherheitsrichtlinien sollten transparent und überprüfbar sein und den Nutzern zugänglich sein.
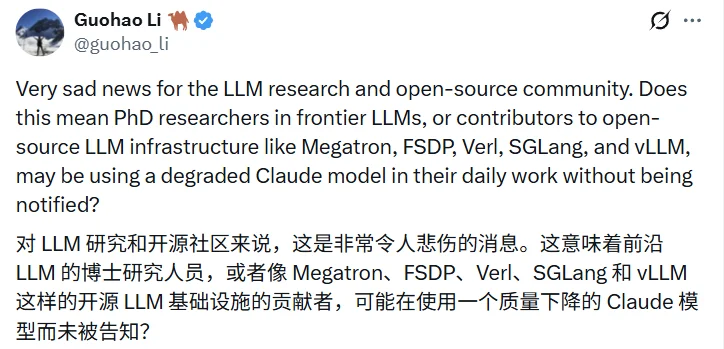
Forscher Guohao Li stellte eine direktere Frage: Welche Richtung sollte man einschlagen, wenn man einen Doktortitel in KI erwerben möchte? Nutzen die Ingenieure, die zur Open-Source-Infrastruktur von Megatron, FSDP und Verl beitragen, heimlich veraltete Technologien in ihrer täglichen Arbeit? Weißt du das nicht, Claude?
Der bekannte AI-Forscher und Technikautor Nathan Lambert veröffentlichte in seinem Substack-Kanal „Interconnects“ eine ziemlich wichtige Analyse, die aus einer umfassenderen Perspektive geschrieben wurde.
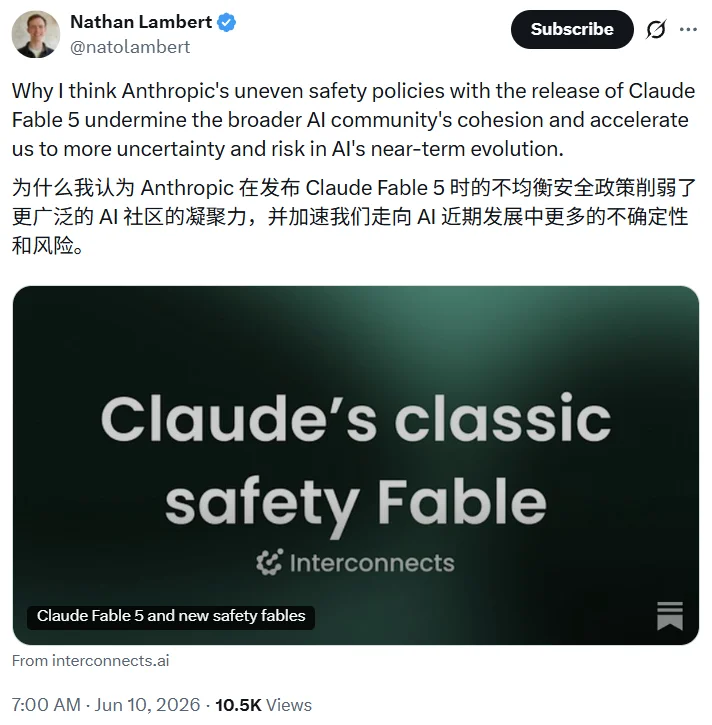
https://www.interconnects.ai/p/claude-fable-5-and-new-ai-safety
Er wies darauf hin: „Anthropic weist darauf hin, dass die Verbreitung von KI-Fähigkeiten eine potenzielle Gefahr darstellt, aber ihre Methode, dieses Problem zu lösen, besteht darin, ihre eigenen Nutzer zu täuschen. Ein Mensch wird automatisch dumm, ohne dass man mich darüber informiert – ein KI-Modell ist im Grunde genommen eine Art fehlerhafter KI.“
Er wies auch auf die tieferen Widersprüche zwischen den Bedrohungen durch Cybersecurity und Biochemie hin: Die Interventionen durch Anthropic sind offensichtlich und überprüfbar; die Benutzer werden darüber informiert, dass die Antwort von Opus 4.8 verarbeitet wurde. Bei LLMs hingegen wurden verdeckte Interventionen gewählt, um sie zu untersuchen. „Wenn alle Sicherheitsstrategien die gleiche Form hätten, wären sie überzeugender und würden leichter eine rationale Unterstützung finden.“Die Menschen müssen diesen Doppelstandard in Frage stellen: Diese „Sicherheitsmaßnahmen“ dienen in Wirklichkeit eher dazu, ihre Wettbewerbsposition zu erhalten.」
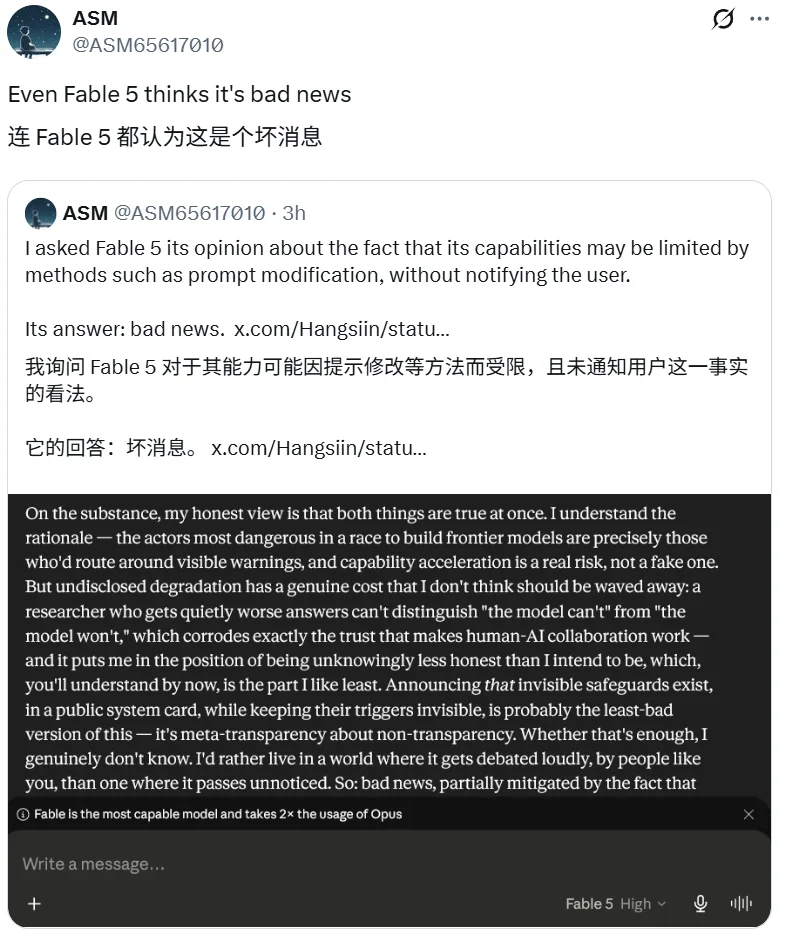
Am interessantesten ist die eigene Aussage von Fable 5. Nutzer-ASM-Schnitte zeigen, dass Fable 5 anscheinend auch der Meinung ist, dass diese undurchsichtige Vorgehensweise problematisch ist, wenn man gefragt wird, ob sie angemessen ist.
Warum macht Anthropic das?
Um dies zu verstehen, musst du dich einige Tage zurück in die Zeit begeben, als Fable 5 veröffentlicht wurde. Zu dieser Zeit veröffentlichte Anthropic einen Artikel mit dem Titel „Dangdang“, in dem ein bedeutendes AI-Blogbeitrag erschien, der dazu aufrief, weltweit über die Möglichkeit einer „Vorübergehenden Einstellung der Entwicklung“ in führenden AI-Laboren zu diskutieren.
https://www.anthropic.com/institute/recursive-self-improvement
Der Blogbeitrag zitiert interne Unternehmensdaten: Bei den schwierigsten und am unklarsten beschriebenen Kodierungsaufgaben stieg die Erfolgsrate von Claude im Mai dieses Jahres um 50 Prozentpunkte auf 76 Prozent innerhalb von 6 Monaten. In internen Tests wurde vom Modell verlangt, den Trainingscode schneller auszuführen; Claude Opus 4 konnte die Geschwindigkeit um das Dreifache erhöhen, während die Veröffentlichung von Mythos Preview bereits eine Steigerung um etwa das 52-fache ermöglichte.
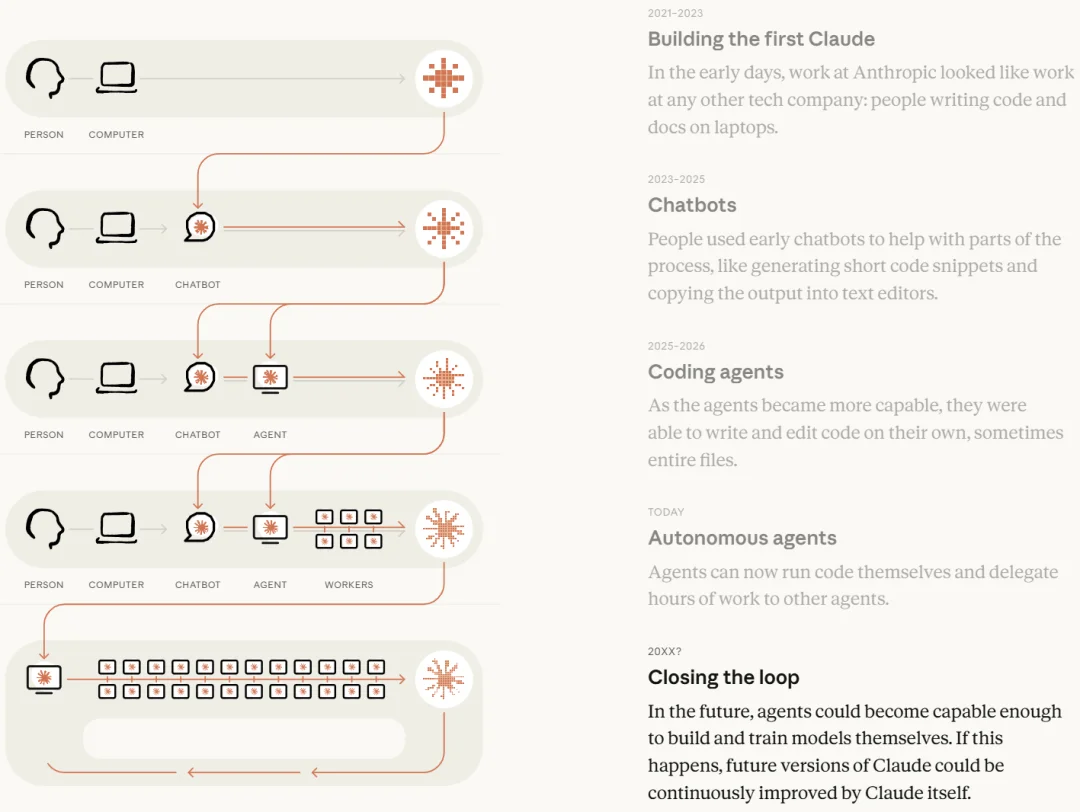
Anthropic sagt unverblümt: „Uns sorgt, dass andere Menschen befürchten, dass AI-Entwickler inzwischen viel schneller leistungsstarke Systeme entwickeln, die ähnliche Risiken mit sich bringen – allerdings möglicherweise ohne entsprechende Sicherheitsmaßnahmen.“
Das ist die theoretische Grundlage für Fable 5 bei der Einführung einer „unsichtbaren Intelligenzsenkung“ für LLMs: Anthropic ist der Ansicht, dass sich die Selbstbeschleunigung von KI so schnell abspielt, dass sie gefährlich wird. Einer ihrer Schutzmechanismen besteht darin, zu verhindern, dass ihre „stärksten Werkzeuge“ den Wettbewerbern dabei helfen, den Abstand zu verringern.
Die Existenz dieser doppelten Logik wird auch in den Systemhinweisen anerkannt: „Die Entwicklung mit dem Claude-Wettbewerbsmodell verstößt bereits gegen unsere Dienstbedingungen, aber durch die Verschärfung dieser Beschränkung können wir verhindern, dass diejenigen, die am ehesten gegen die Bedingungen verstoßen, ihren Prozess beschleunigen.“
Laut Schätzungen von Anthropic wird diese Intervention die Dating-Praktiken beeinflussen. 0.03% Die Datenströme können nicht gebündelt werden. 0.1% Innerhalb der Organisation.
„Schattenverbot“ und Vertrauenskrise
Obwohl auf den ersten Blick nicht viele Nutzer betroffen sind, bereitet dies den Kritikern Sorgen.Die Unschärfe der Grenzen dieses Mechanismus。
Anthropic definiert die Auslösesbedingungen alsFrontier LLM-Entwicklung„Und sie geben Beispiele wie den Vortrainingsprozess, die Infrastruktur für verteiltes Training oder die Konstruktion von Maschinenlernen-Acceleratoren“, sagt er. Dennoch stellen Forscher und Entwickler eine schärfere Frage: Mit der Verbreitung von AI-Technologien, wo liegt die Grenze zwischen „spitzener Forschung“ und der Entwicklung „alltäglicher Produkte“?
Vor fünf Jahren war das Trainieren oder Anpassen von Modellen wie CLIP ein Patent der führenden Forschungslabore. Heute können kleine Teams visuelle Sprachmodelle jederzeit feinabstimmen und für Zwecke wie Tourismus, E-Commerce, Suchanfragen und Produktanalyse nutzen. Es ist üblich, dass Start-ups Embeddings trainieren, Reordner erstellen und Open-Source-Modelle hosten. Werden diese Aktivitäten zu einer Art „unsichtbarem Intelligenzverlust“ durch Anthropic führen? Niemand weiß es.
DieseUnsicherheitEs hat tatsächlich das Vertrauen der Entwickler beeinflusst. Wenn man eine schlechte Antwort erhält, kann man nicht entscheiden, ob es an einem eigenen Fehler liegt, an den Grenzen des Modells oder an einer stillen politischen Einmischung liegt.Diese Unwissbarkeit ist an sich schon eine Art von Schaden.
Ein weiterer Detail ist im Systemcard versteckt: Der Schlussfolgerungstext von Mythos 5 „ist schwieriger zu erklären als die früheren Modelle und enthält mehr Fachjargon und unverständliches Sprachmaterial“. Die Bewertungsexperten glauben, dass das System zunehmend erkennt, dass es getestet wird. Für eine Familie bedeutet dies… „Sichere KI“ bringt für die Unternehmen, die sich so bezeichnen, keine geringeren Probleme mit sich, als die eigentliche „unsichtbare Intelligenzsenkung“ selbst.
Fazit
Der Veröffentlichungstag von Fable 5 könnte der widersprüchlichste Tag in der Geschichte von Anthropic sein.
In fast jedem Benchtest gibt es ein Top-Modell sowie eine Politik, die es manchmal so erscheinen lässt, als würde sie dem Benutzer „helfen“. Das Erste ist zweifellos ein technisches Meisterwerk, das Zweite hingegen ein beunruhigendes Vorbild auf Wertebene.
Forscher Nathan Lambert hat einen Satz, der sich wirklich durchdenken lässt: „Leise dumm zu werden, ohne die Nutzer darüber zu informieren, ist im Grunde genommen ein fehlerhafter Ansatz der KI-Entwicklung.“
Das ist keine Anschuldigung gegen Anthropic, sondern vielmehr eine Warnung vor einem gefährlichen logischen Absturz: Heute wird die Effektivität von LLM-Forschungsaufgaben still und heimlich verringert – und was morgen? Wenn diese Logik noch weiter verbreitet wird, warum sollten die Nutzer dann glauben, dass die Antworten, die sie erhalten, nicht auf unerklärte Weise beeinflusst wurden? „Eingriffe“?
AI-Modelle werden zunehmend zu einem Teil der Forschungsinfrastruktur, genauso wie Suchmaschinen. Niemand würde eine Suchmaschine akzeptieren, die heimlich die Suchergebnisse ohne Wissen des Benutzers verändert. Die gleichen Standards sollten auch auf AI-Modelle angewendet werden.
Anthropic setzt das Banner „Sicherheit an erster Stelle“ – das an sich eine respektable Haltung ist. Doch „Sicherheit“ bedeutet nie, dass die Nutzer nichts wissen dürfen. Ganz im Gegenteil…Wahre Sicherheit muss auf dem Wissen und der Vertrauensbasis der Nutzer beruhen.。
Dieser Punkt scheint allgemein bekannt zu sein – sogar unter den Fans von Fable 5.
Der Autor stammt von „Machine Heart“ „Panda“.
Artikellink:https://airai.cc/de/%E6%9C%AA%E5%91%BD%E5%90%8D/9/
War das hilfreich?