OpenAI-Wissenschaftler Noam Brown: Die wahre Obergrenze der KI kann sich niemand leisten
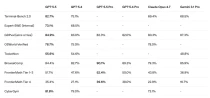
Mit dem zunehmenden Einsatz großer Sprachmodelle in anspruchsvollen Aufgaben wie komplexer Inferenz, automatisierter Forschung und Netzwerksicherheit stehen herkömmliche Methoden zur Bewertung von Modellen vor neuen Herausforderungen.Seit langem werden Modelle veröffentlicht, zusammen mit Ergebnistabellen, die aus verschiedenen Benchmarks wie Mathematik, Programmierung, wissenschaftlichen Fragen und Antworten sowie Netzwerksicherheit bestehen, und diese werden mit den Ergebnissen der vorherigen Generationen verglichen.