• OpenAI 과학자 Noam Brown : AI 의 진정한 한계는 아무도 측정 할 수 없습니다.

    대형 언어 모델들이 점차 복잡한 추론, 자동화 연구, 네트워크 보안과 같은 어려운 과제에 도전하면서, 전통적인 모델 평가 방법들은 새로운 도전에 직면하고 있습니다.오랫동안 모델의 출시는 수학, 프로그래밍, 과학적 질문응답, 네트워크 보안, 지식 추론 등 다양한 벤치마크 테스트 결과로 구성된 보고서와 함께 이루어졌으며, 이전 세대의 모델들과 수준을 비교해 왔습니다.
    OpenAI 과학자 Noam Brown : AI 의 진정한 한계는 아무도 측정 할 수 없습니다.
  • AI 연구를 할 때 클라우드가 몰래 멍청해지고 Anthropic 은 연구 커뮤니티에 포위당합니다.

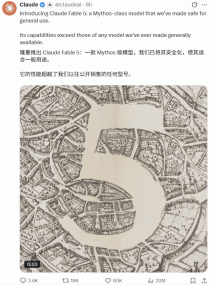
    Claude Fable 5는 오늘날 AI 분야의 핵심 화제로, 이 “신화적인” 모델의 성능이 매우 뛰어나서 수많은 관심을 받고 있습니다.Andrej Karpathy는 이를 “매우 흥미진진하다”고 평가하며, “대규모 업그레이드에 걸맞는 도약적인 진전”이라고 말했습니다. 이는 지난 11월 Claude 4.5에서 이루어진 개선과 동일한 수준입니다. SWE-bench Pro 프로그래밍 벤치마크에서 Fable 5는 80.3%의 점수를 기록하여 Opus 4.8보다 11%나 높은 성능을 보였습니다. 5천만 줄의 코드를 가진 Ruby 코드베이스에서 Fable 5는 하루 만에 전체 코드베이스의 마이그레이션을 완료했는데, 같은 작업을 인간 팀에게 맡긴다면 2개월 이상의 시간이 걸릴 것입니다.

    AI 연구를 할 때 클라우드가 몰래 멍청해지고 Anthropic 은 연구 커뮤니티에 포위당합니다.
  • GPT-5.6 첫 번째 테스트가 도착했습니다!정밀 저격수 Mythos

    방금, Anthropic이 두 달 동안 숨겨왔던 ‘대형 킬러’를 공개했습니다—Claude Fable 5그리고Mythos 5마치 폭탄을 던진 것처럼.지금 바로 OpenAI에 압력을 가하자.

    GPT-5.6 첫 번째 테스트가 도착했습니다!정밀 저격수 Mythos

더 이상 없습니다