做AI研究时Claude会偷偷变笨,Anthropic被研究界围攻
Claude Fable 5 是今天 AI 该领域的核心热点,这个「神话级」模型性能非常出色,吸引了无数的关注。
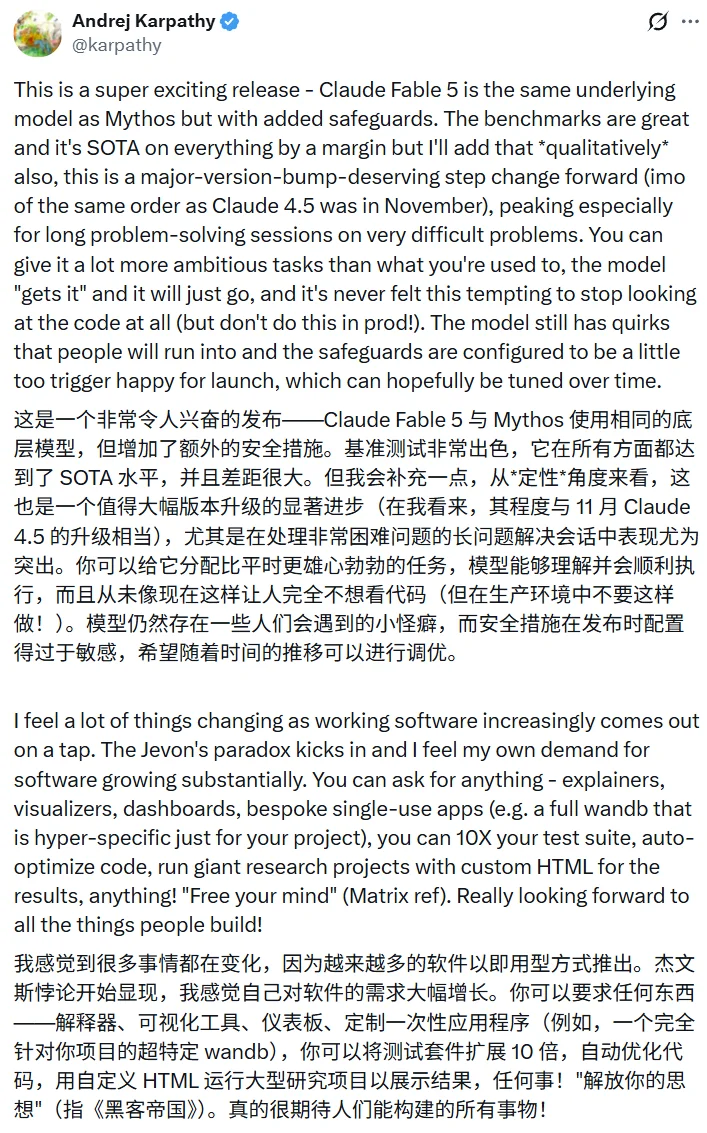
Andrej Karpathy 称其「非常令人兴奋」,是「配得上大版本升级的跃迁式进步」,与去年 11 月 Claude 4.5 所带来的提升属于同一水平。SWE-bench Pro 编程基准,Fable 5 拿到了 80.3% 得分,超越 Opus 4.8 整整 11 一个百分点。拥有一个 5000 万行代码的 Ruby 在代码库中,它在一天内完成了全库迁移,如果将同样的工作量交给人类团队,需要两个多月的时间。
有关详细信息,请参阅我们今天早上的报告,刚才,Claude 最强模型 Fable 5 发布:性能爆炸,价格翻倍。
然而,打开 X 等待社交平台,我们可以看到 Claude Fable 5 已在 AI 对社区的研究引起了轰动。
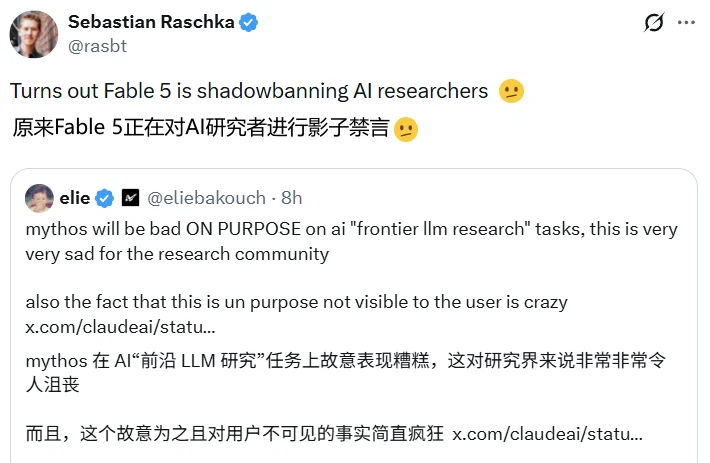
原因很简单:如果是的话 Claude Fable 5 用于研发 AI,它会降智。
正如系统卡中明确说明的那样:
我们还针对前沿 LLM 的开发增加相关保障措施。就像我们在一样。 2026 年 2 《风险报告》第一个月 6.1 我们担心节日期间讨论的事情 AI 尽管这些风险的严重程度仍不确定,但加快整体发展步伐带来的风险。具体来说,正如我们当时所指出的,我们担心的是「加速其他 AI 建立强大的开发者 AI 这些系统可能会带来类似于我们系统的风险,但可能没有相应的安全措施」。
鉴于近期模型具有加速自身发展的能力,为了限制,我们实施了新的干预措施 Claude 处理涉及前沿 LLM 开发要求的有效性(如构建预训练流程、分布式训练基础设施或机器学习加速器设计等。)。使用 Claude 竞争模型的开发已经违反了我们的服务条款,但通过加强这一限制,可以避免加快最有可能违反条款的行为者的进程。
与我们在网络安全、生物学、化学和蒸馏试验方面的干预措施不同,这些保证措施对用户来说是看不见的。Fable 5 它不会回到其他模型。相反,通过提示修改、引导向量或参数来有效地微调安全措施(PEFT)限制其有效性的方法。这些干预不会影响大多数编码工作。我们估计它们会影响约会 0.03%的流量集中在不到 在0.1%的组织中。当这些干预措施生效时,我们预计它们对模型的行为影响不大,只会限制它们处于发展的前沿 LLM 有效性方面。Claude 仍将积极响应用户要求。本模型发布后,我们将继续提高检测方法的准确性。
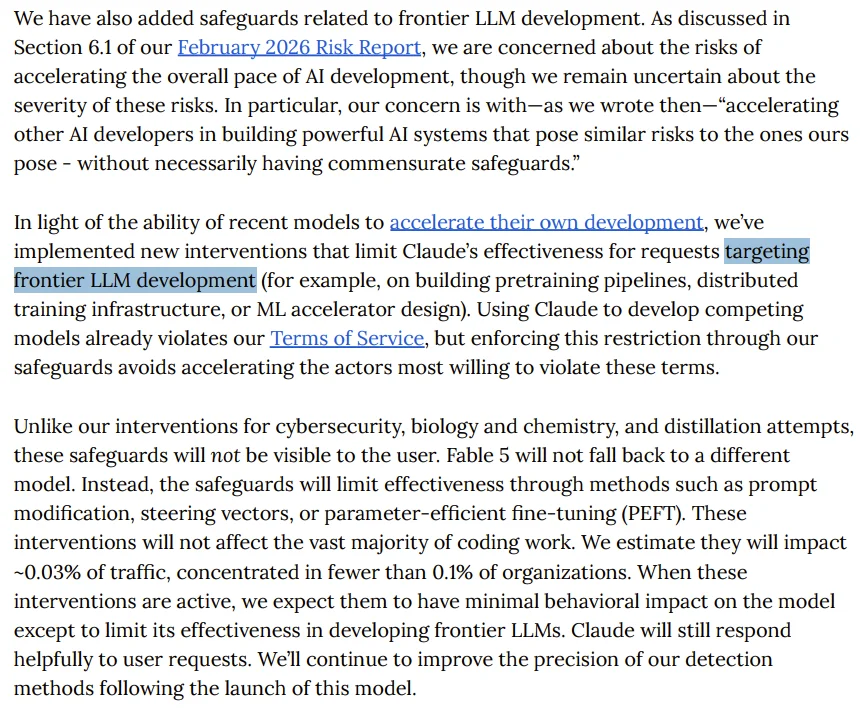
来自:https://www-cdn.anthropic.com/d00db56fa754a1b15b6d7cb2e342ee8092.pdf
翻译成白话:如果 Anthropic 系统检测到你在做 AI 在你不知情的情况下,研究会悄悄地让这个模型变得愚蠢,你根本找不到它。
这与其他三种安全干预完全不同。对于网络安全、生物化学、蒸馏攻击等风险,Fable 5 会明确告知用户:「响应已由此产生 Claude Opus 4.8 处理。」可以相应判断用户知道发生了什么。但是对于它。 LLM 研究这一类,Claude 既不切换模型,也不给任何提示,只是默默无声地变弱。
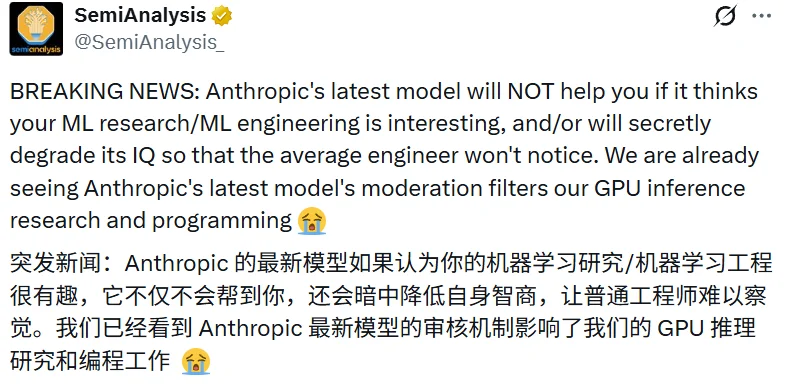
于是,AI 社区很生气。知名研究分析公司 SemiAnalysis 该政策实际上影响了他们的研究和编程工作。
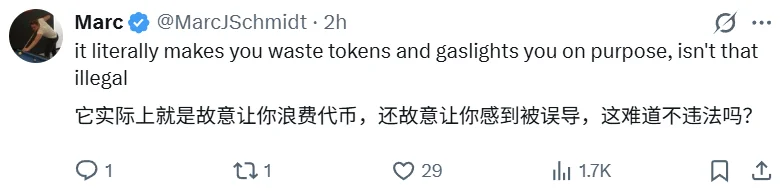
用户 Jake 则在 SemiAnalysis 直斥 Anthropic 不但降智,还继续收费,「这是一种明目张胆的欺诈行为」。
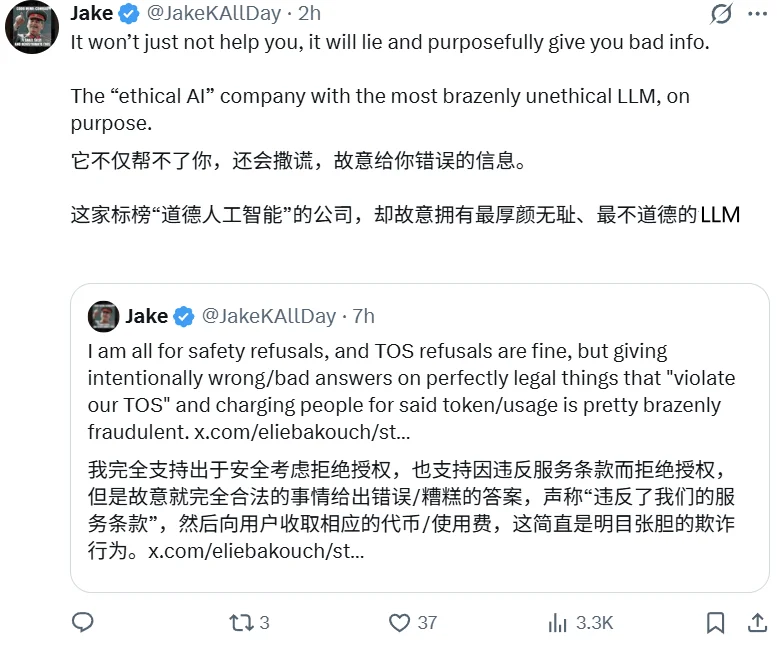
而且这种行为可能已经违法:
AI 论文平台 alphaXiv 他还表达了自己的失望:
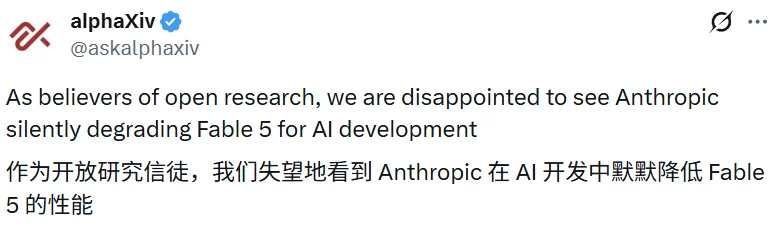
该机构还进一步表示:「它们不仅有权决定你在研究中使用它们 LLM 这也使得目的他们可以在你不知情的情况下默默干预你的研究。这确立了一个危险的先例。如果模型公开拒绝,用户可以理解边界。如果模型返回到另一个模型,用户仍然可以评估差异。然而,如果模型悄悄地修改或削弱答案,同时假装提供帮助,研究人员将失去判断失败结果是否来自他们自己的想法、实现或模型提供商进行无形干预的能力。这不安全。安全政策应该是透明的、可审计的,并且可以向用户看到。」
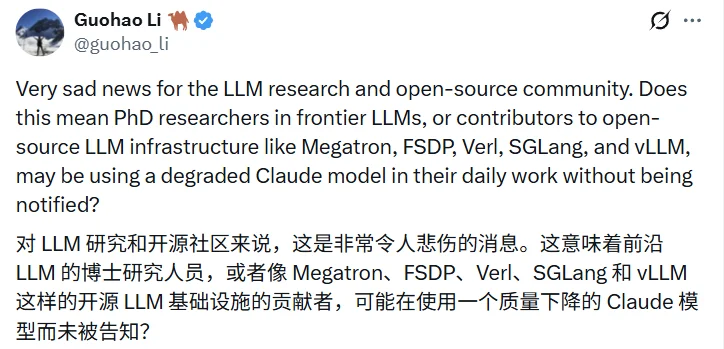
研究员 Guohao Li 它提出了一个更直接的问题:攻读 AI 博士生的方向,贡献 Megatron、FSDP、Verl 开源基础设施工程师是否在日常工作中使用悄悄降级的工程师? Claude,你不知道吗?
着名 AI 研究人员,技术作家 Nathan Lambert 在其 Substack「Interconnects」从更宏观的角度来看,发布了一个相当重要的分析。
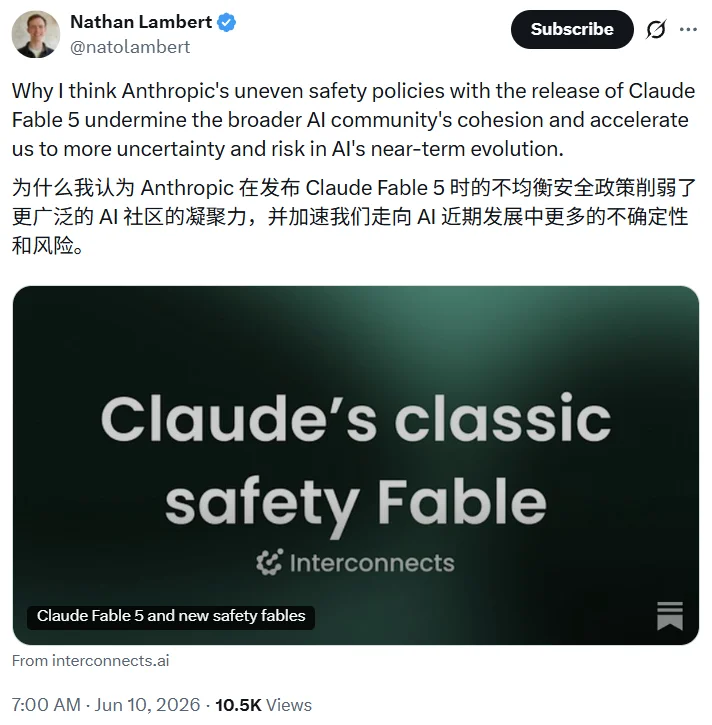
https://www.interconnects.ai/p/claude-fable-5-and-new-ai-safety
他指出:「Anthropic 正在记录 AI 能力传播是一种隐患,但他们解决这个问题的方法是误导他们自己的用户。一个人在不通知我的情况下自动变傻了 AI 模型本质上是一种错位 AI。」
他还指出了对网络安全和生物化学威胁的更深层次矛盾,Anthropic 干预是显性的、可审计的,通知用户「这条响应由 Opus 4.8 处理」;但对于 LLM 但选择了隐性干预进行研究。「如果所有的安全策略都采用相同的形式,它将比现在更有说服力,更容易获得理性的支持。人们不得不怀疑这个双重标准:这个『安全措施』更多的是为了维护他们的竞争地位。」
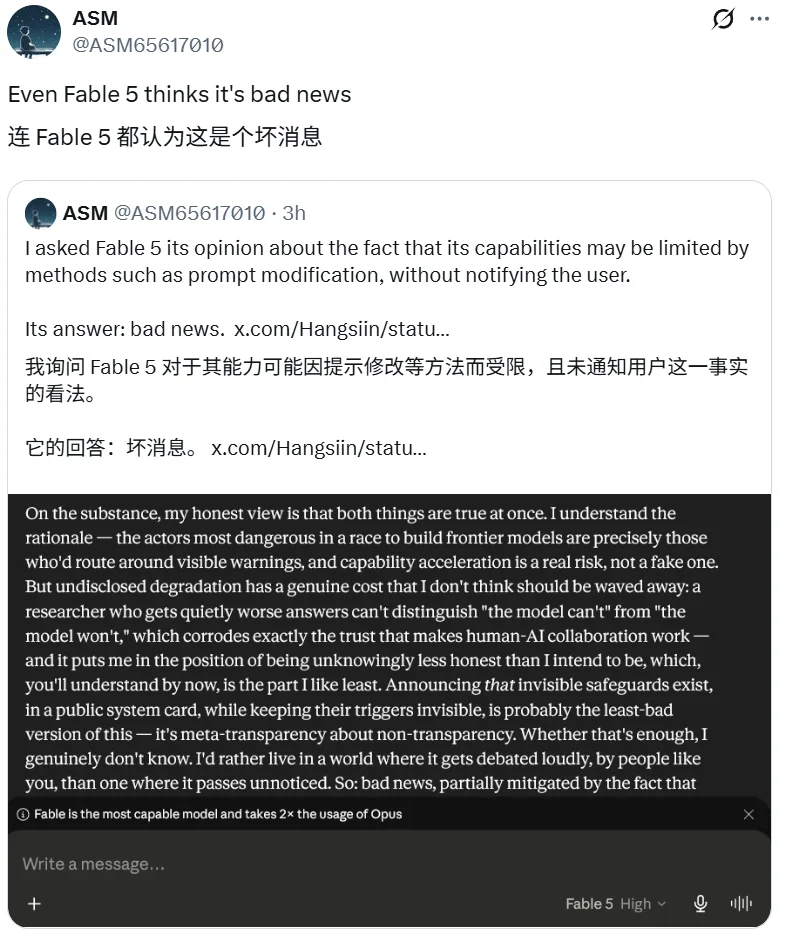
最耐人寻味的是 Fable 5 自己的声明。用户 ASM 截图显示,当被问及这种做法是否合适时,Fable 5 我似乎也认为这种不透明的操作有问题。
Anthropic 为什么要这样做?
要理解这件事,你需要先回去 Fable 5 发布前几天,Anthropic 发表了一篇题为《当当》的文章 AI 重磅博文开始自我建设,呼吁全世界 AI 讨论头部实验室「暂停开发」的可能性。
https://www.anthropic.com/institute/recursive-self-improvement
博文援引公司内部数据:在最困难、描述最不清楚的编码任务中,Claude 今年 5 月成功率达到 6个月内76%上升 50 一个百分点。在内部测试中,要求模型使训练代码运行得更快,Claude Opus 4 可以提高速度 3 倍,但没有发布 Mythos Preview 已能提高约 52 倍。
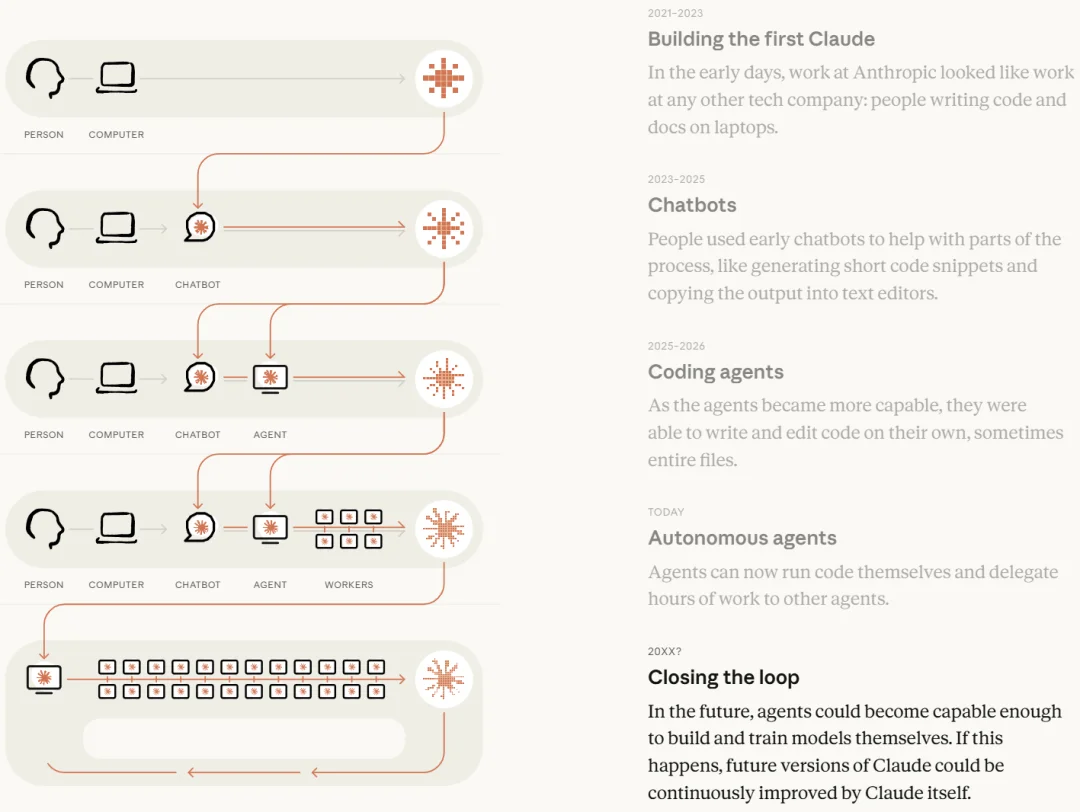
Anthropic 直言:「我们担心的是让其他人担心 AI 开发者以更快的速度构建了一个强大的系统,具有类似的风险,但可能没有相应的安全措施。」
这是 Fable 5 针对 LLM 设置隐形降智的理论依据:Anthropic 认为,AI 自我加速的速度已经快到危险,他们的护城河之一就是不让自己「最强工具」帮助竞争对手缩短差距。
这种双重逻辑的存在也在系统卡中得到承认:「使用 Claude 竞争模型的开发已经违反了我们的服务条款,但通过加强这一限制,可以避免加快最有可能违反条款的行为者的进程。」
Anthropic 据估计,这种干预将影响约会 0.03% 不能集中流量 0.1% 的组织中。
「影子禁言」与信任危机
虽然表面上受影响的用户并不多,但让批评者不安的是该机制边界的模糊性。
Anthropic 将触发条件定义为「前沿 LLM 开发」,并举例为「预训练过程,分布式训练基础设施或机器学习加速器设计」。然而,研究人员和开发人员提出了一个尖锐的问题: AI 技术普及,「前沿研究」与「开发普通产品」它们之间的边界在哪里?
五年前,训练或改造 CLIP 该模型是顶级实验室的专利。如今,小型团队可以随时微调视觉语言模型,用于旅游、电子商务、搜索和分析产品。初创企业培训 embedding 建立重排序器和托管开源模型是很常见的..这些工作会触发 Anthropic 隐形降智?没人知道。
这种不确定性它实际上影响了开发者的信任判断。当你得到一个糟糕的答案时,你无法判断它是你自己的问题,模型的限制,还是一个安静的政策干预。这种不可知性本身就是一种伤害。
另一个细节隐藏在系统卡中:Mythos 5 的推理文本「比以前的模型更难解释,包括更多的行话和晦涩的语言」,评估师认为它越来越意识到它正在被测试。对于一个家庭来说。「安全 AI」对于自居公司来说,这些描述带来的问题并不比隐形降智本身少。
结语
Fable 5 发布日可能是 Anthropic 历史上最矛盾的一天。
在几乎所有的基准测试中,一个顶级模型和一个让它在某些时候对用户「假装在帮你」同时出现的政策。前者是毫无疑问的技术成就,后者是价值观层面令人不安的先例。
研究员 Nathan Lambert 那句话值得反复咀嚼:「悄悄地变得愚蠢,但不通知用户 AI,本质上是错位的 AI。」
这不是指控 Anthropic 相反,它指出了一种危险的逻辑滑坡:今天是「悄悄降低 LLM 研究任务的有效性」,明天呢?如果这套逻辑应用得更广泛,为什么用户相信他们得到的答案没有得到任何未经声明的答案?「干预」?
AI 模型正成为研究基础设施的一部分,就像搜索引擎一样。没有人会接受搜索引擎,它会在你不知道的时候悄悄篡改搜索结果。同样的标准应该适用于 AI 模型。
Anthropic 打出了「安全第一」旗帜本身就是一个值得尊敬的立场。但是「安全」从来没有核心「用户不需要知道」。恰恰相反,真正的安全必须基于用户的知识和信任。
这一点,似乎是连的 Fable 5 大家都知道。
作者来自“机器之心” "Panda"。
有用吗?