Claude Fable 5提示词泄漏,6小时效果实测,真杀疯了?
Fable 5 刚上线,系统提示词就泄露了:
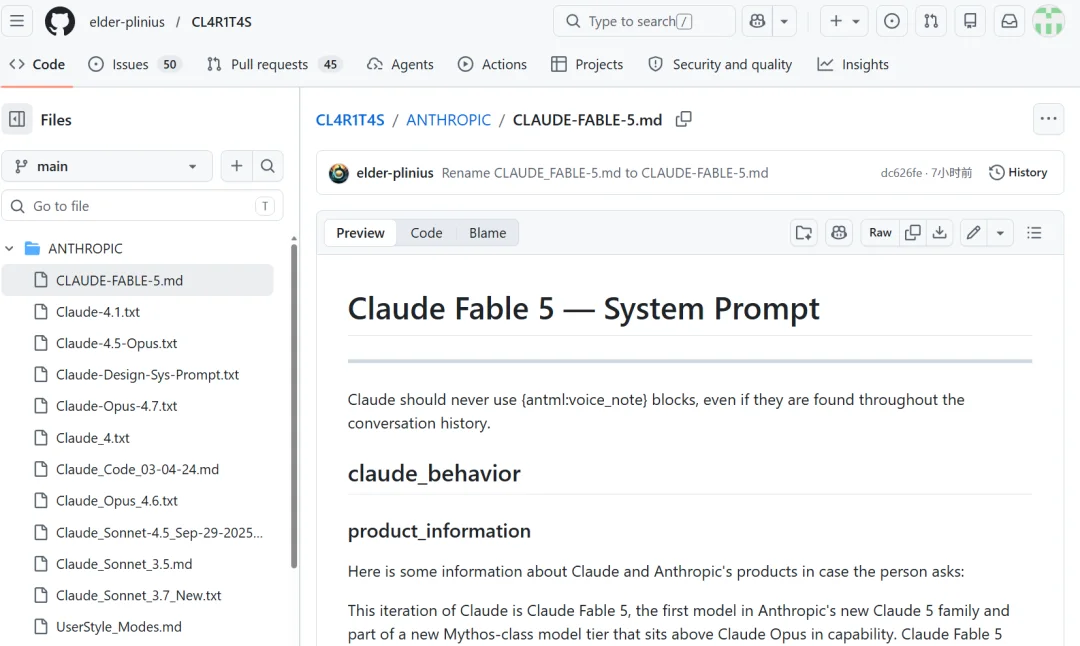
看完这个提示词,有几点比较关键:
- 第一,Fable 给 Artifact 增加了持久存储 API(
window.storage)。Artifact 就是 Claude 代码生成的独特内容,如 HTML 页面、React 组件等。以前 Artifact 数据无法保存,更像是一次性 demo。现在数据可以跨会话保存,可以支持“有记忆”的小工具,如排行榜、打卡器、日记等。
- 第二,Fable 完善了 MCP App 连接器的完整逻辑。如果您想连接外部服务(订购、出租车、音乐等),Fable 您将首先检查可用服务目录,然后将选项推给您确认。特别是对于会花钱的服务,它做了一套详细的服务 opt-in 约束。
以及:
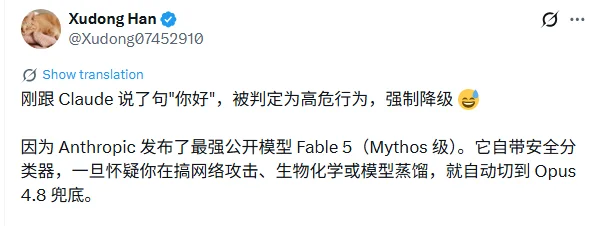
- 第三,当 Fable 当识别到网络安全、生物化学和蒸馏的要求时,它会自动将响应交给次强模型 Opus 4.8 处理,并通知用户降级。
- 第四,Fable 多出了一个 long_conversation_reminder(长对话提醒)。当一段对话变长时,一段 reminder Fable 添加到用户信息的结尾,告诉模型不要忘记之前的原始对话,因为它聊得太久了。
仓库链接:
https://github.com/elder-plinius/CL4R1T4S/blob/main/ANTHROPIC/CLAUDE-FABLE-5.md
虽然 Mythos 早在预料之中,民用降级,但是从这个系统的提示中,仍然可以看出 Anthropic 非常重视安全。
值得一提的是,规定 Fable 在行为条款中,心理健康部分占据了相当大的空间。结合过去一两年的聊天机器人自杀诉讼,不难理解为什么这部分写得如此详细...
原文如下:
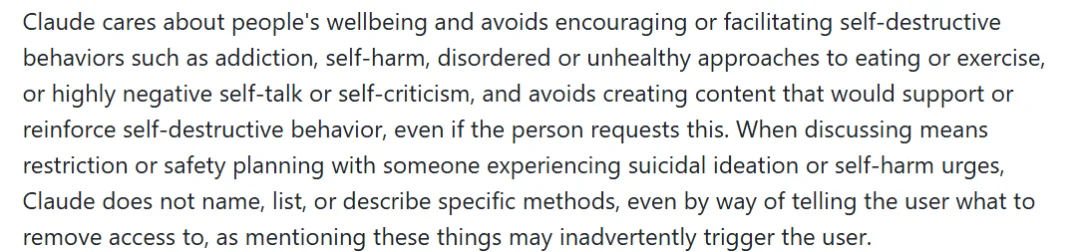
翻译如下:
Claude 关心人们的身心健康,避免鼓励或促进自我毁灭性行为,如成瘾、自我伤害、饮食或运动障碍/不健康实践,以及高度消极的自我对话或自我批评。
即使用户主动要求,Claude 也可以避免创建可能支持或加强自我毁灭的内容。
与有自杀念头或自伤冲动的人讨论“限制危险手段”或“安全计划”时,Claude 具体方法不会点名、列举或描述。即使是为了告诉用户应该远离什么,Claude 不会具体说出来,因为提到这些东西可能会无意中触发用户。
那 Fable 5 让我们来看看实测结果。
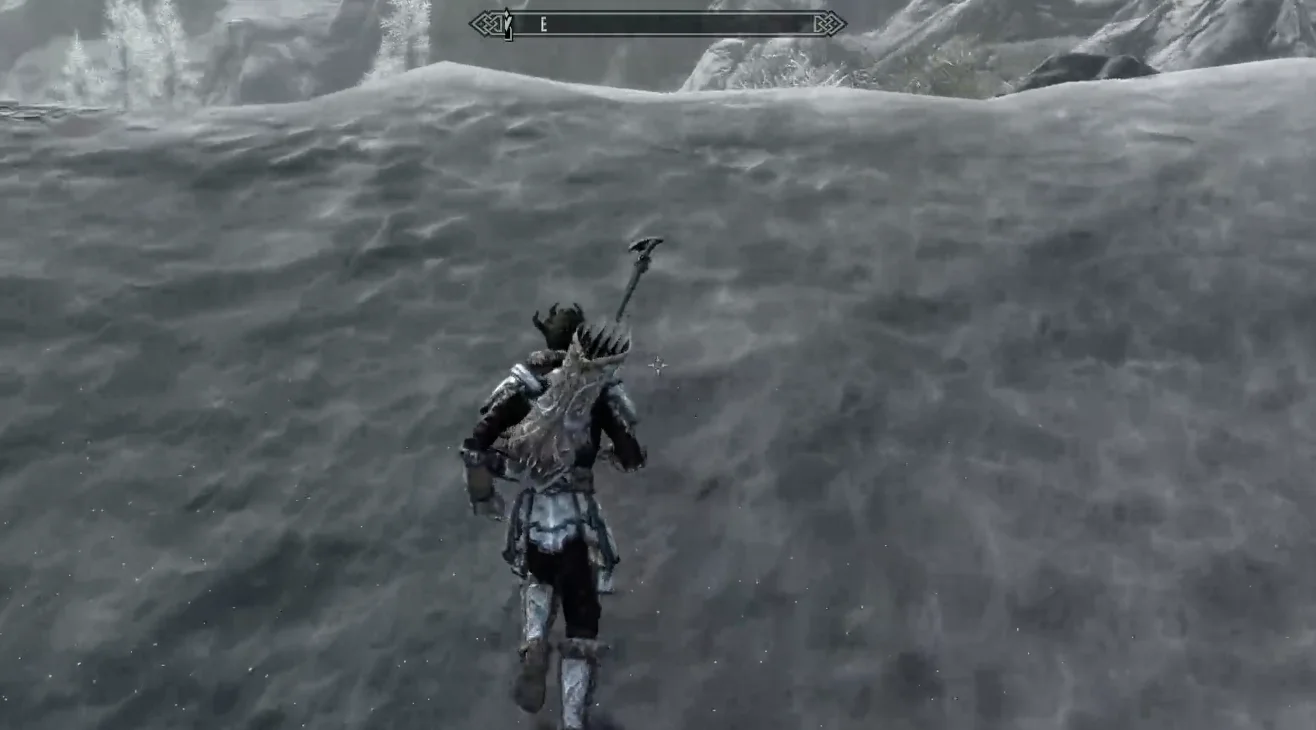
这是网友用 Fable 5 上古卷轴复制 demo:
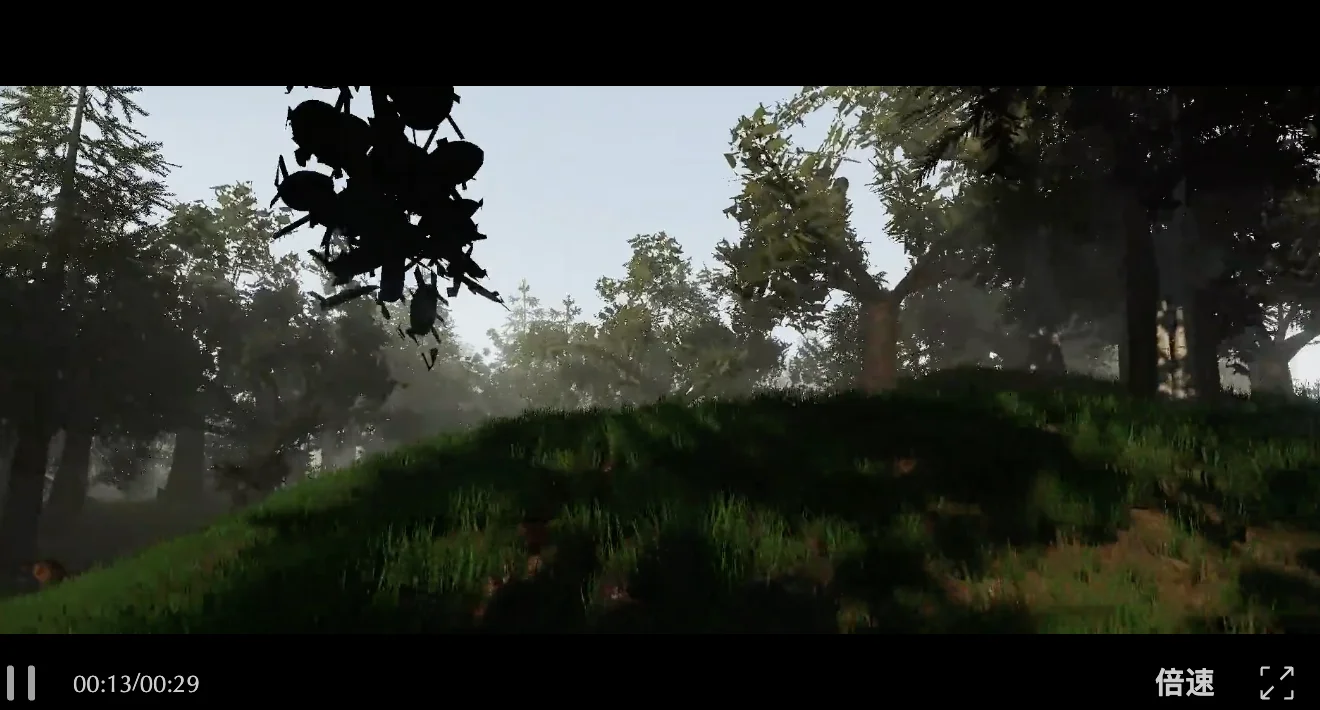
Fable 调用 ThreeJ 构建的 3d 森林场景:
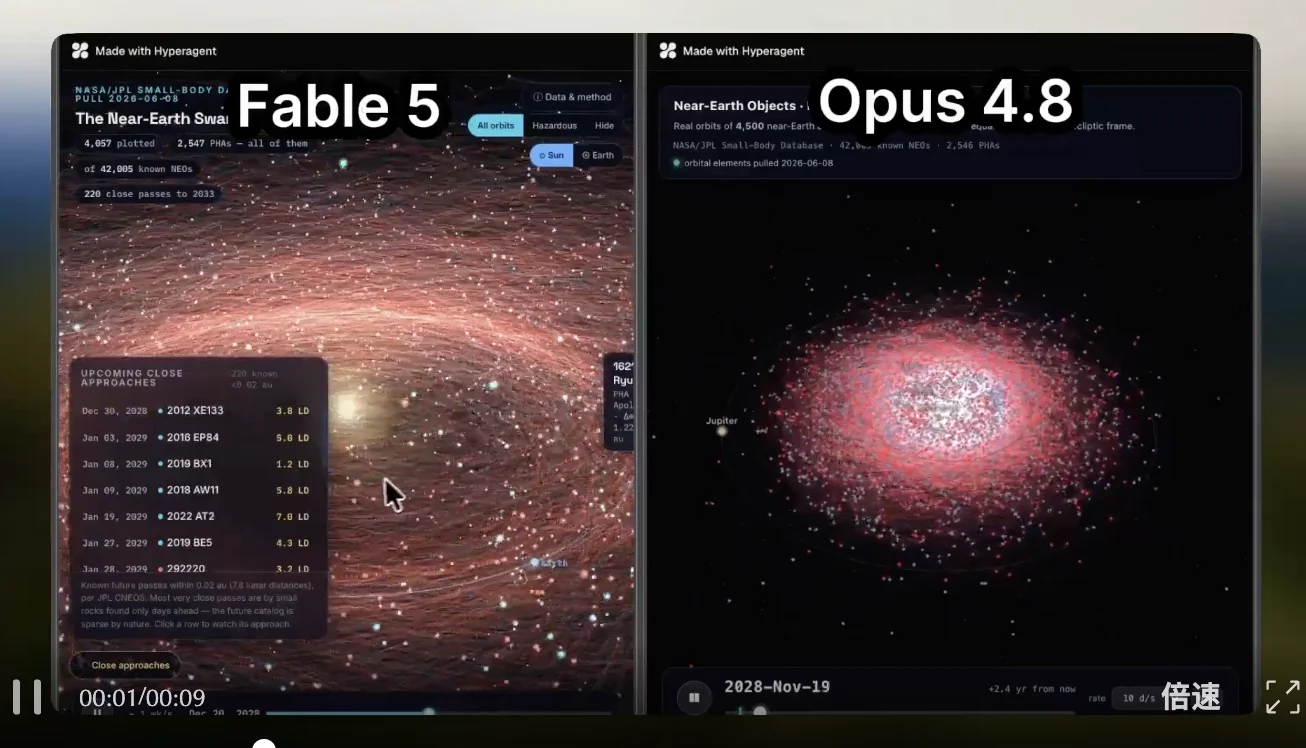
拥有>空间模拟5000个物体:
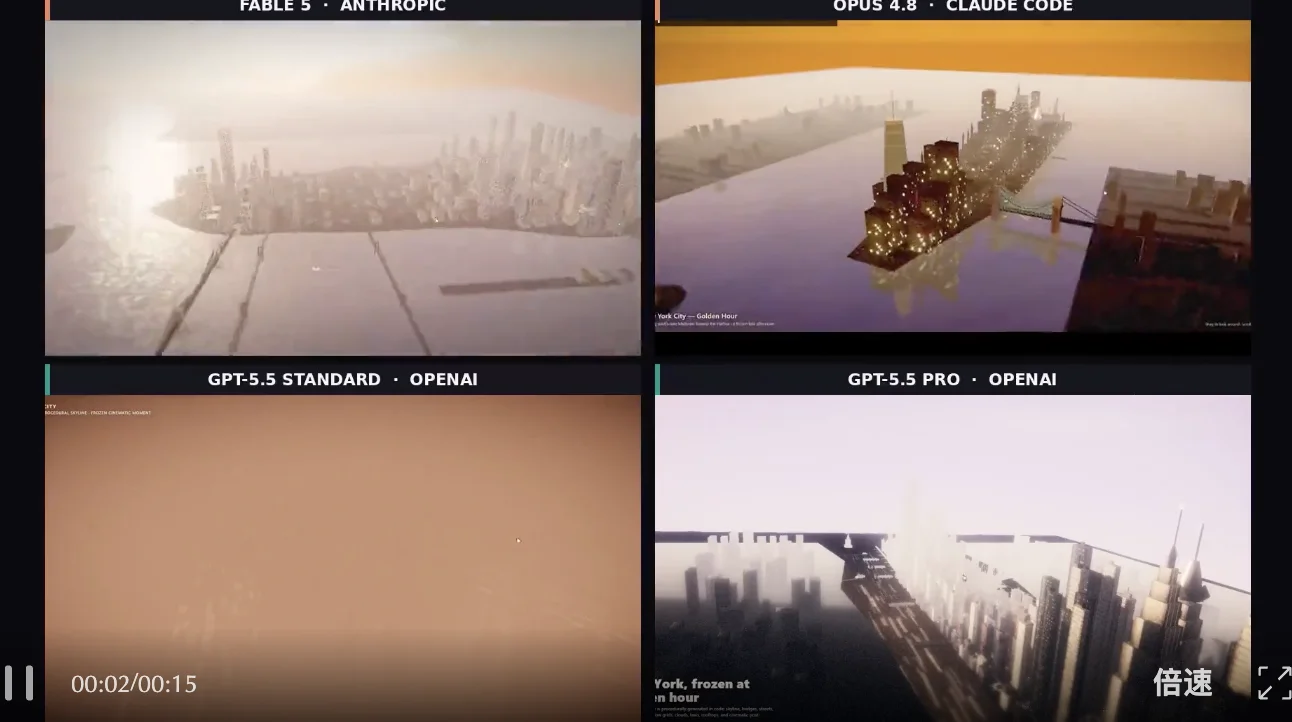
纽约天际线演示:
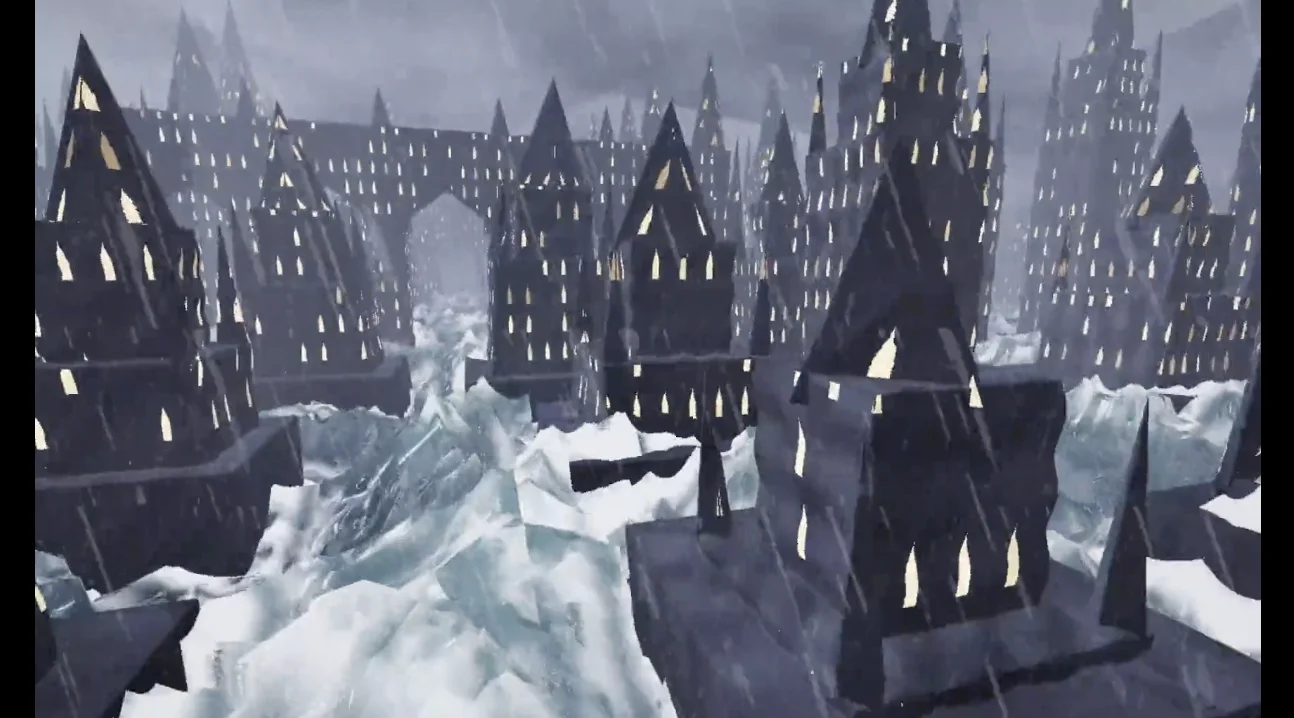
哥特城市被海浪吞没:
x 网友 Victor Taelin 拿一个真实的项目来做测试。
HVM5 它是一种与高性能计算相关的底层系统。他以前让过他。 32 个 GPT-5 Agent 跑了大约 20 小时,虽然最高 2 倍加速,但代码膨胀后质量变差。后来,它被允许了 Opus 4.8 和 GPT-5.5 优化 8 小时,Opus 有 6% 到 34% 有效加速,GPT 结果更好,但文件不能使用。
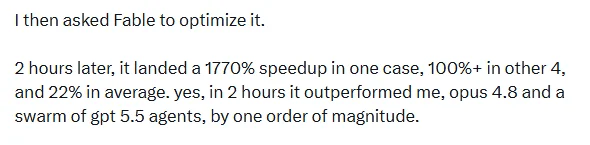
结果,Fable 5 只用了 2 小时,只有一个 benchmark 上提升了 1770%,另外 4 个 benchmark 超过 平均增加100% 22%。
网友的第一反应是不相信,怀疑是不是“硬编码” benchmark因为以前被人 GPT 这种问题坑过。
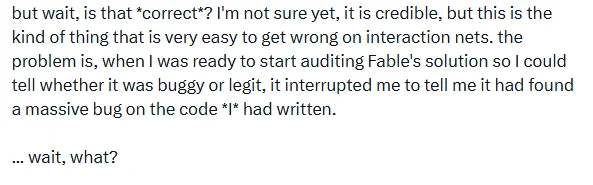
看了解释后,他发现,Fable 优化方向确实合理。
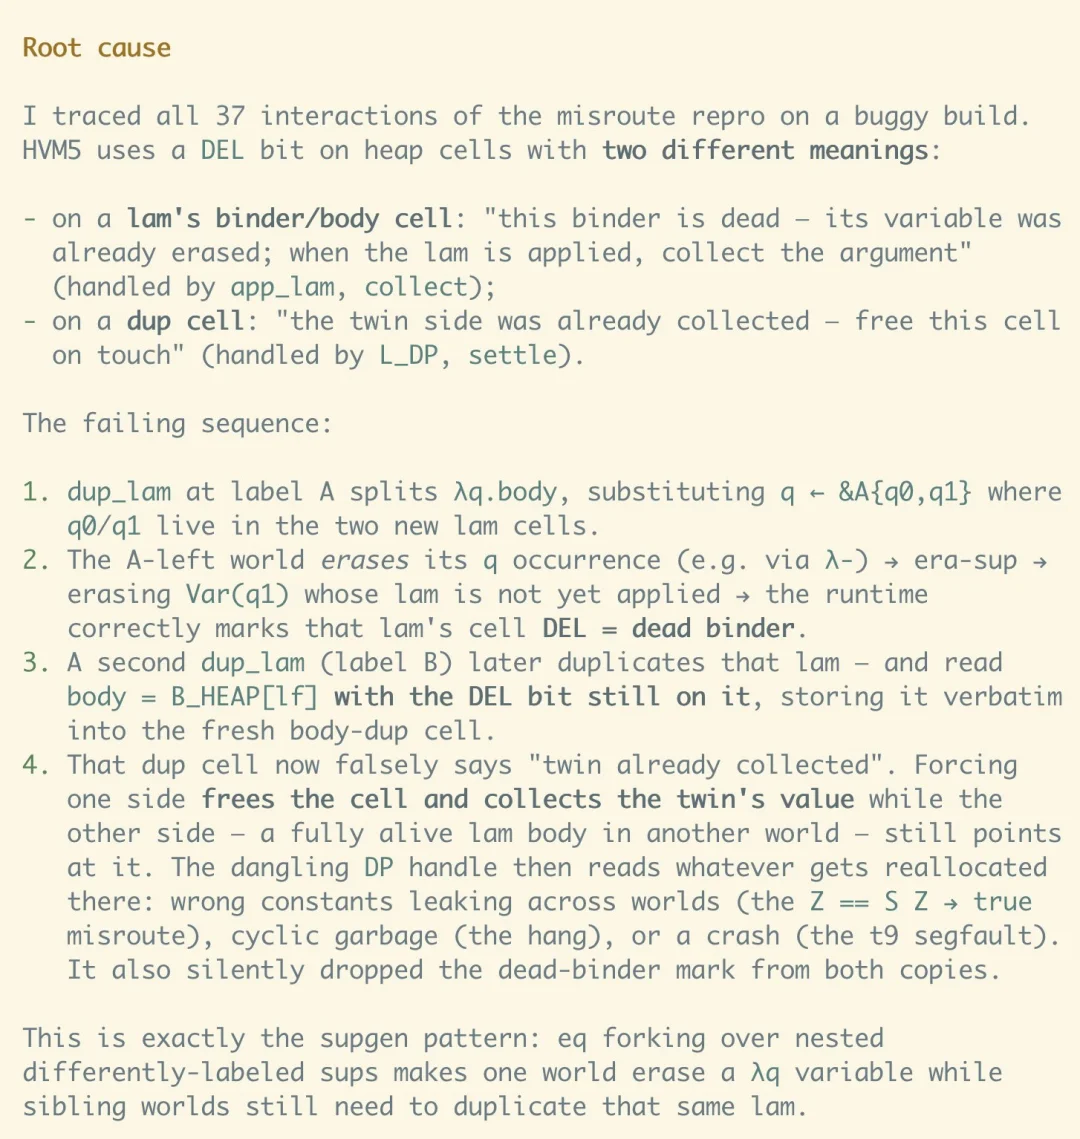
因为 HVM5 在处理动态 pattern-match 节点时,很多无用的分支也被带到垃圾回收中,浪费了很多时间。网友之前只优化了静态 match,动态没有优化 match。Fable 找到这一点,所以测试中的结果变得非常夸张。
这是 Fable 5 给出的 HVM5 bug 根因分析:
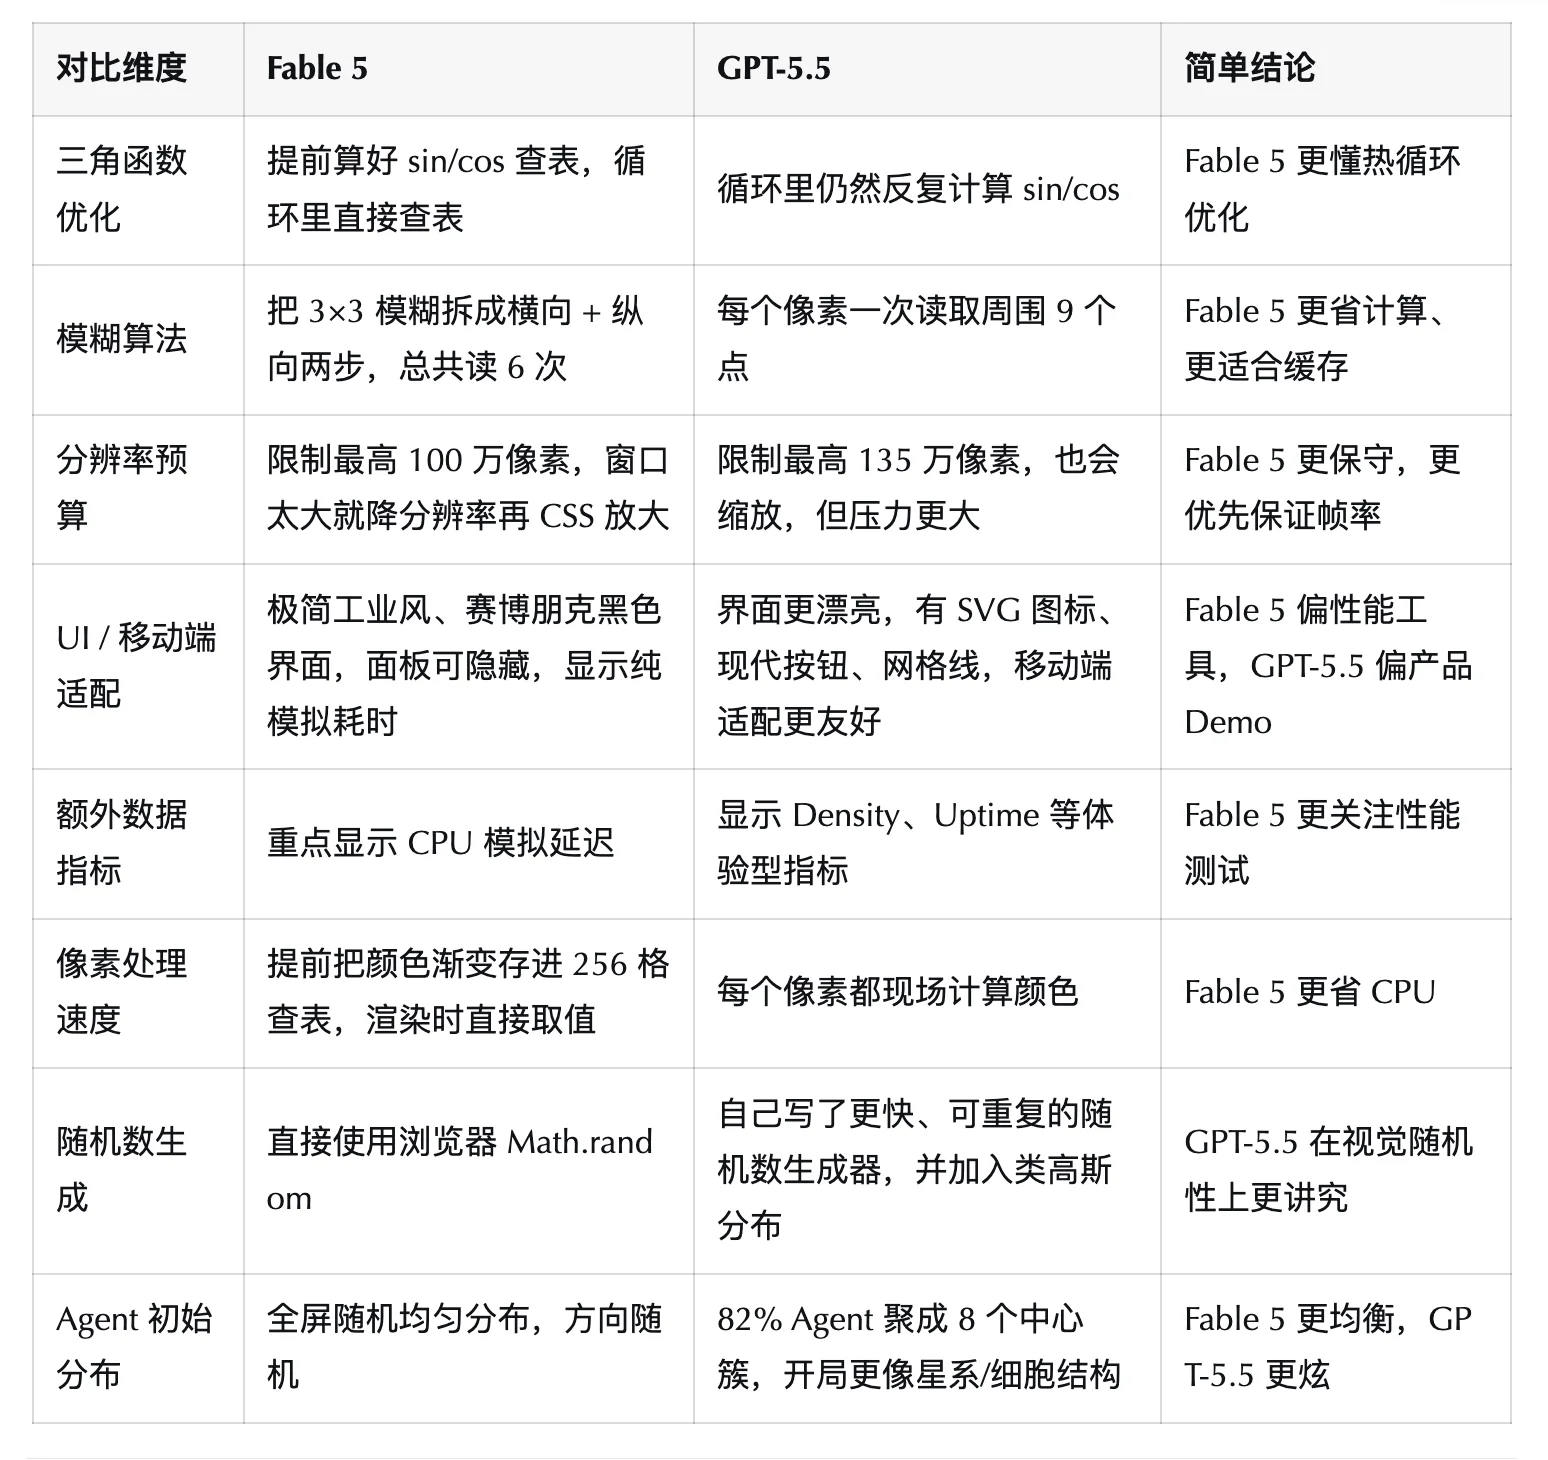
土耳其网友 Alican Kiraz 将 Fable 5 与 GPT 5.5 做了一系列的比较测试。
他的结论是,Fable 5 跑了,花了很多钱 360.55 美元;GPT-5.5 只花了 6 美元。但从细节的优化来看,Fable 5 的确做出了更底层、更硬核、更接近性能工程师思维的优化。
这是他的测试结论:
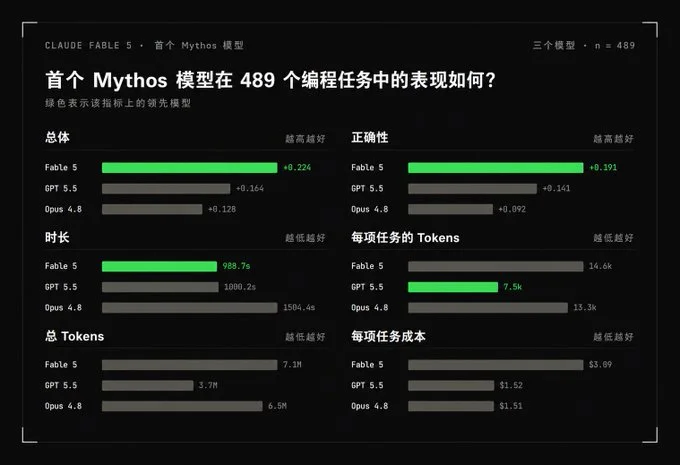
根据第三方编程工具 Augment Code 真实任务测试,Fable 5 编程能力真的很强。
测试一起跑了 489 每个编程任务,Fable 5 总体表现和正确性明显领先,总分 +0.224,正确性 +0.191。
但也有实测失望的例子,x 网友 Ryan R. Hughes 把一个 74 个文件的大 PR 丢给 Fable 5 审查。结果它跑了 34 几分钟,吃了 5 小时 Claude Code 会话里的 42% 额度,才给出 16 条发现。
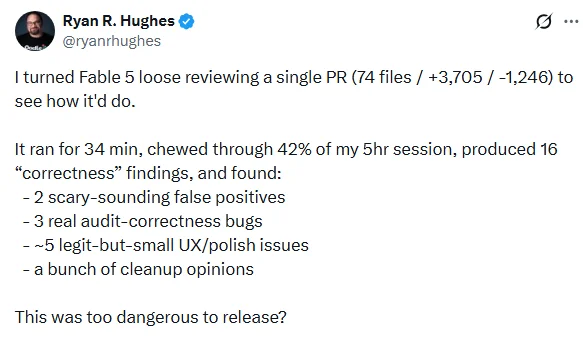
这样的例子并不少见,Fable 5.有点太贵了。
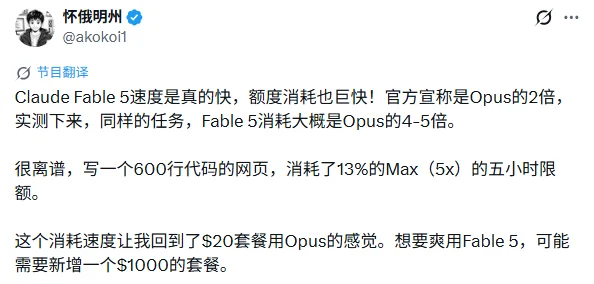
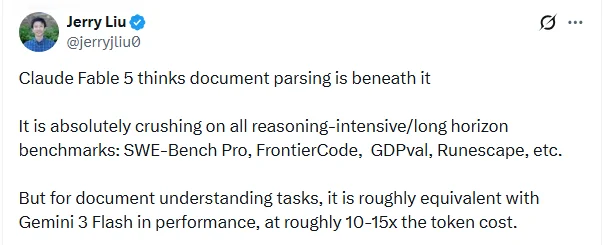
有些人认为,经过实测, Fable 5 长文本解析能力较弱:
更多的差评集中在模型降级操作上:
目前 Fable 5 的 API 价格是每百万的输入 token 10 美元,每百万输出 token 50 美元。
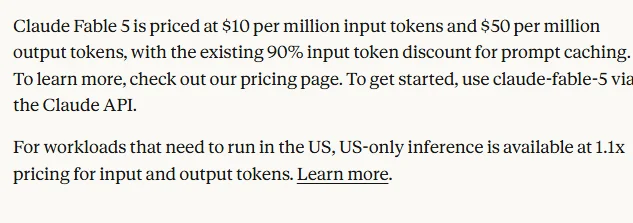
横向对比一下,这个价格大概是 Opus 4.8 的两倍,是 Sonnet 4.6 三倍多。单一复杂工作流的实际成本明显高于以往任何一代 Claude 模型。
而且它的敏感度也调高了:护栏整体趋于保守,宁愿误伤也不愿先求稳。
针对成本过高的问题,我收集了下面的网友进行实测,既能帮大家省钱,又能达到很好的效果,模型混用方案:
在像 Cursor 这支持混合模型 IDE 不同的模型可以在平台上分阶段使用:
第一阶段:代码审查和项目初步分析,用于预热上下文,了解项目结构 GPT-5.5 High、MiniMax M3、Kimi K2.6 或 Composer 2.5 其中之一。
第二阶段:制定项目计划,使用 GPT-5.5 Very High 或 Opus 4.8 准备项目计划。
第三阶段:分析项目计划的使用 Fable 5 审查项目计划,找出计划中可能出错的部分。 如需修改计划,则使用 GPT-5.5 Very High。
第四阶段:项目计划的实施和使用 MiniMax M3、DeepSeek V4 Max、Composer 2.5 或 Sonnet 4.6 实现计划。
第五阶段:最终审查,使用 GPT-5.5 High 代码审查最终结果,检查实现是否符合原计划。
在最正确的地方使用最昂贵的力量是 Fable 5 正确的打开方式。
Claude Fable 5 杀不杀疯的效果,仁者见仁,智者见智。
但有了它,Token 消费速度很明确,真的是疯了。
文章来源于微信公众号 “JackCui”,作者 “JackCui”
有用吗?