Claude Fable 5提示詞洩漏,6小時效果實測,真殺瘋了?
Fable 5 剛上線,系統提示詞就洩露了:
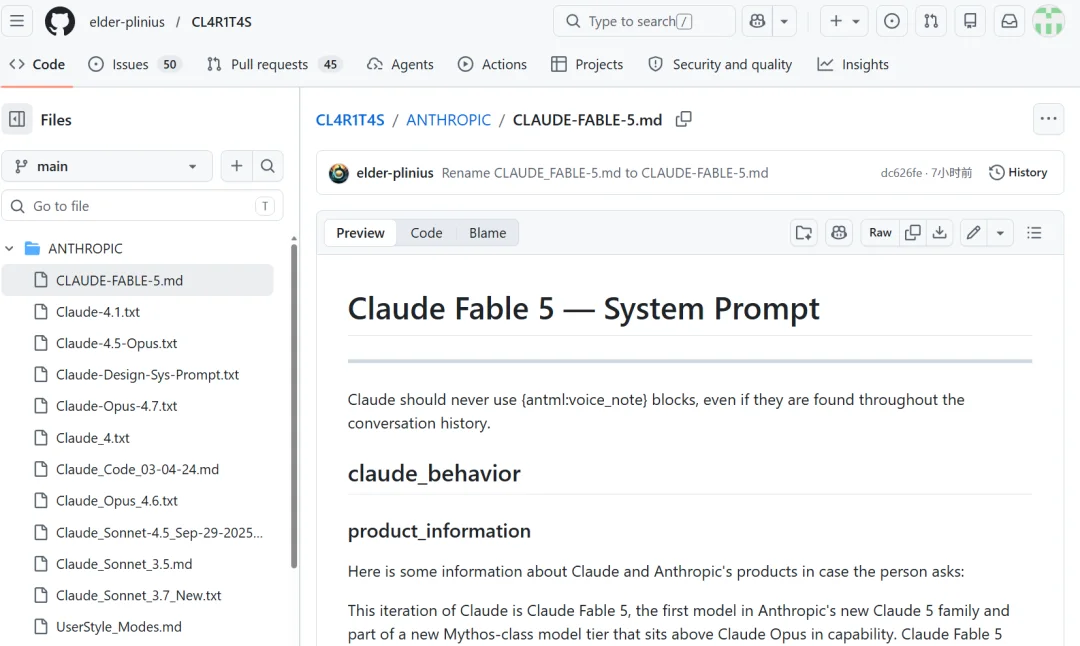
看完這個提示詞,有幾點比較關鍵:
- 第一,Fable 給 Artifact 增加了持久存儲 API(
window.storage)。Artifact 就是 Claude 代碼生成的獨特內容,如 HTML 頁面、React 組件等。以前 Artifact 數據無法保存,更像是一次性 demo。現在數據可以跨會話保存,可以支持「有記憶」的小工具,如排行榜、打卡器、日記等。
- 第二,Fable 完善了 MCP App 連接器的完整邏輯。如果您想連接外部服務(訂購、出租車、音樂等),Fable 您將首先檢查可用服務目錄,然後將選項推給您確認。特別是對於會花錢的服務,它做了一套詳細的服務 opt-in 約束。
以及:
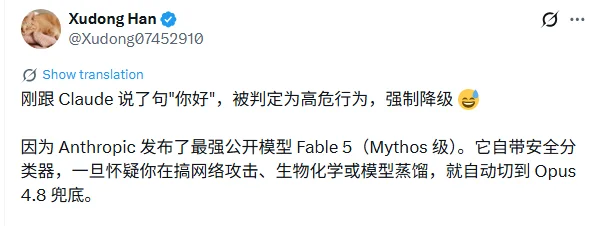
- 第三,當 Fable 當識別到網絡安全、生物化學和蒸餾的要求時,它會自動將響應交給次強模型 Opus 4.8 處理,並通知用戶降級。
- 第四,Fable 多出了一個 long_conversation_reminder(長對話提醒)。當一段對話變長時,一段 reminder Fable 添加到用戶信息的結尾,告訴模型不要忘記之前的原始對話,因為它聊得太久了。
倉庫鏈接:
https://github.com/elder-plinius/CL4R1T4S/blob/main/ANTHROPIC/CLAUDE-FABLE-5.md
雖然 Mythos 早在預料之中,民用降級,但是從這個系統的提示中,仍然可以看出 Anthropic 非常重視安全。
值得一提的是,規定 Fable 在行為條款中,心理健康部分佔據了相當大的空間。結合過去一兩年的聊天機器人自殺訴訟,不難理解為甚麼這部分寫得如此詳細...
原文如下:
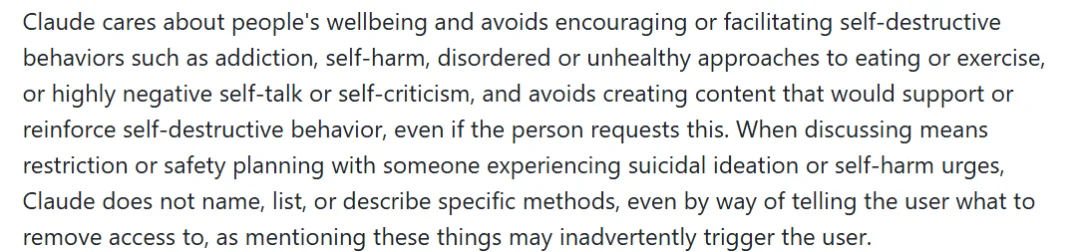
翻譯如下:
Claude 關心人們的身心健康,避免鼓勵或促進自我毀滅性行為,如成癮、自我傷害、飲食或運動障礙/不健康實踐,以及高度消極的自我對話或自我批評。
即使用戶主動要求,Claude 也可以避免創建可能支持或加強自我毀滅的內容。
與有自殺念頭或自傷衝動的人討論「限制危險手段」或「安全計劃」時,Claude 具體方法不會點名、列舉或描述。即使是為了告訴用戶應該遠離甚麼,Claude 不會具體說出來,因為提到這些東西可能會無意中觸發用戶。
那 Fable 5 讓我們來看看實測結果。
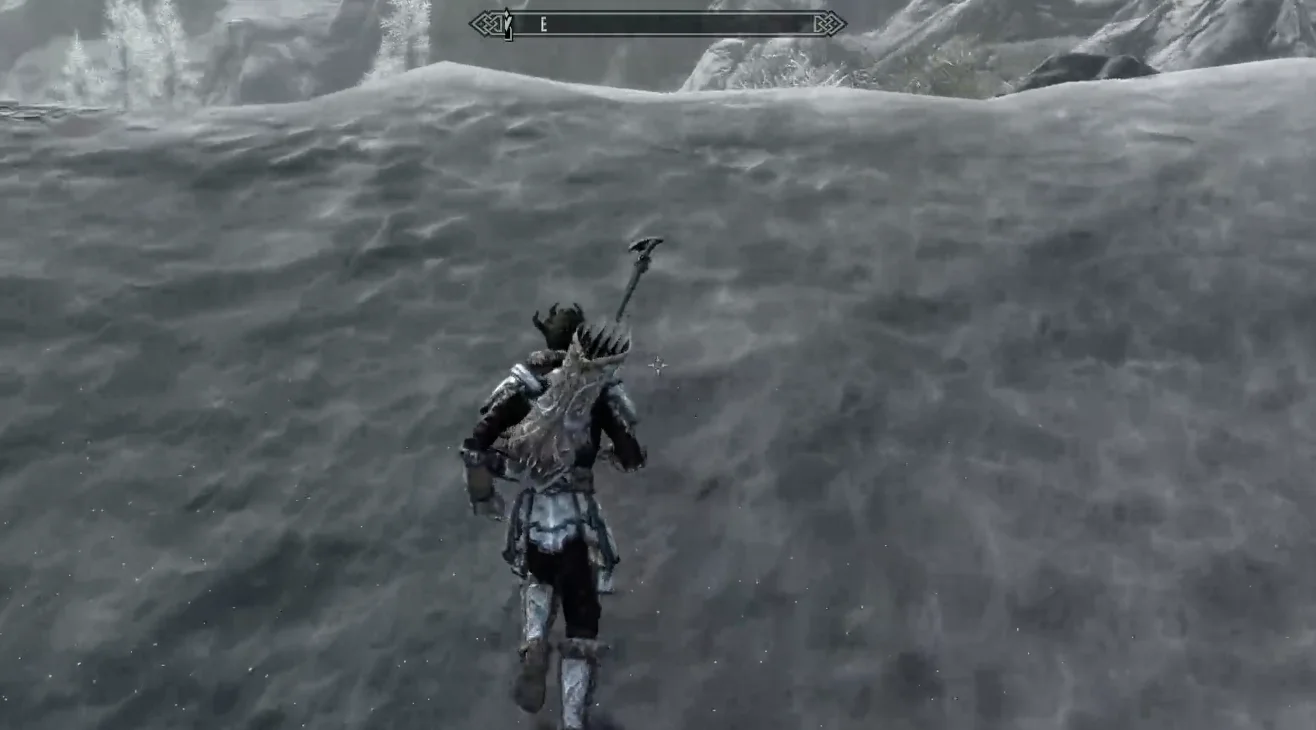
這是網友用 Fable 5 上古捲軸複製 demo:
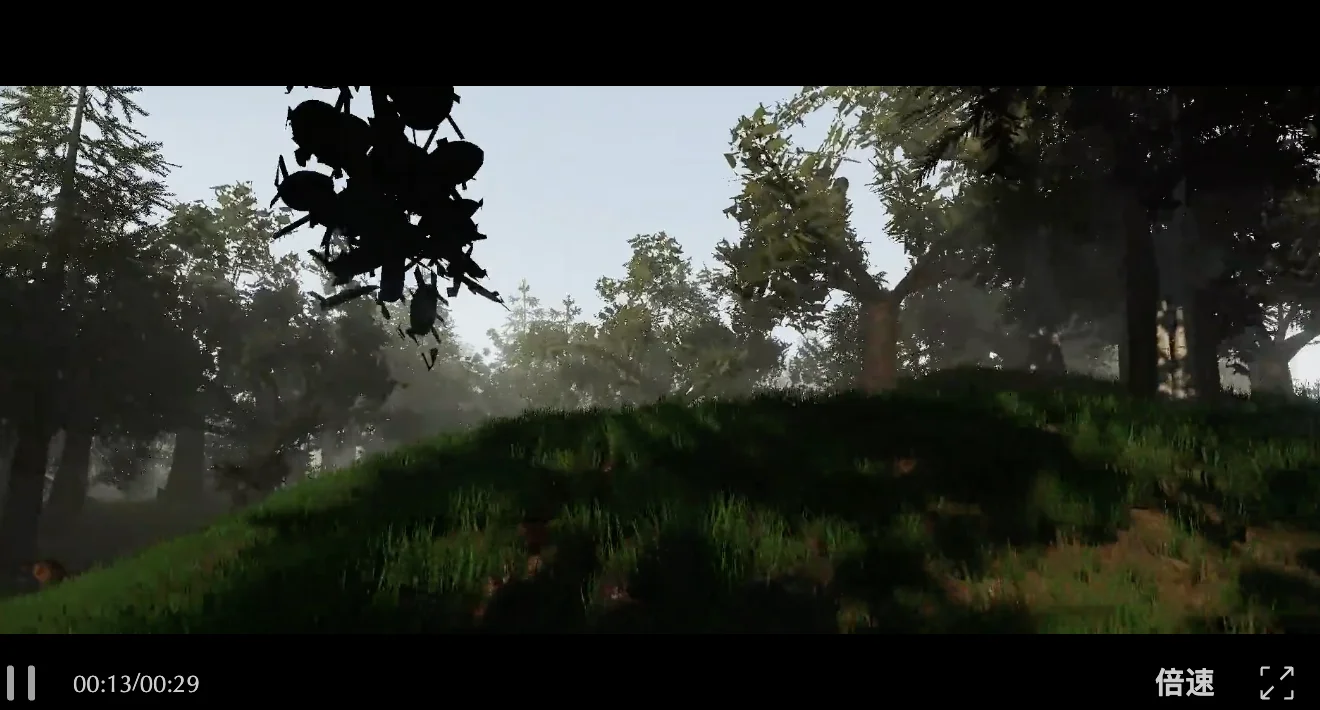
Fable 調用 ThreeJ 構建的 3d 森林場景:
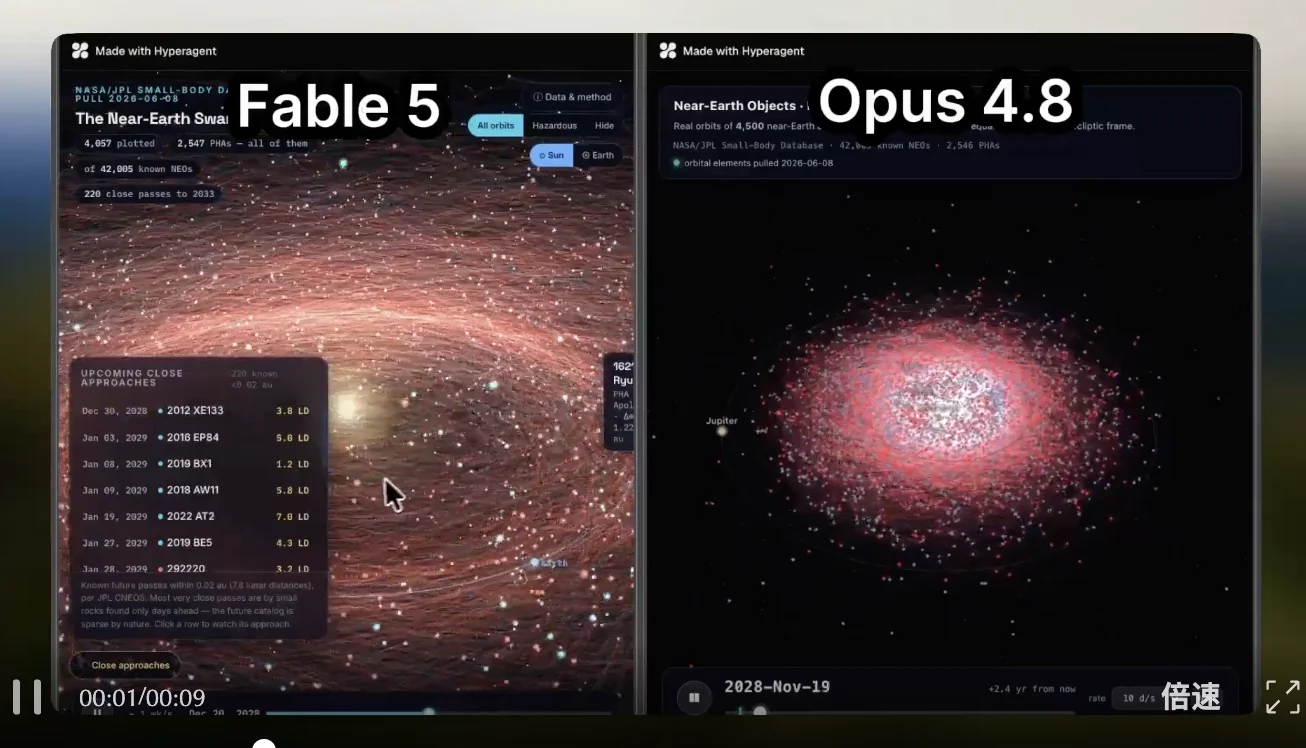
擁有>空間模擬5000個物體:
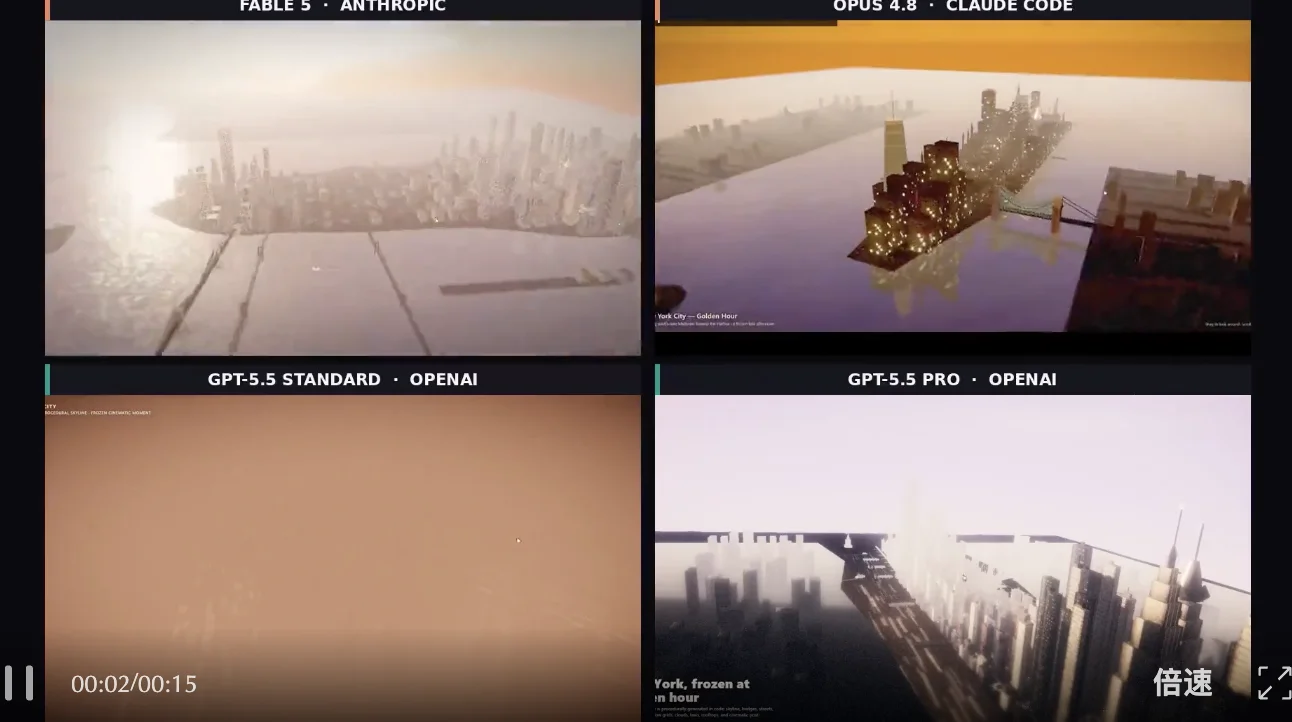
紐約天際線演示:
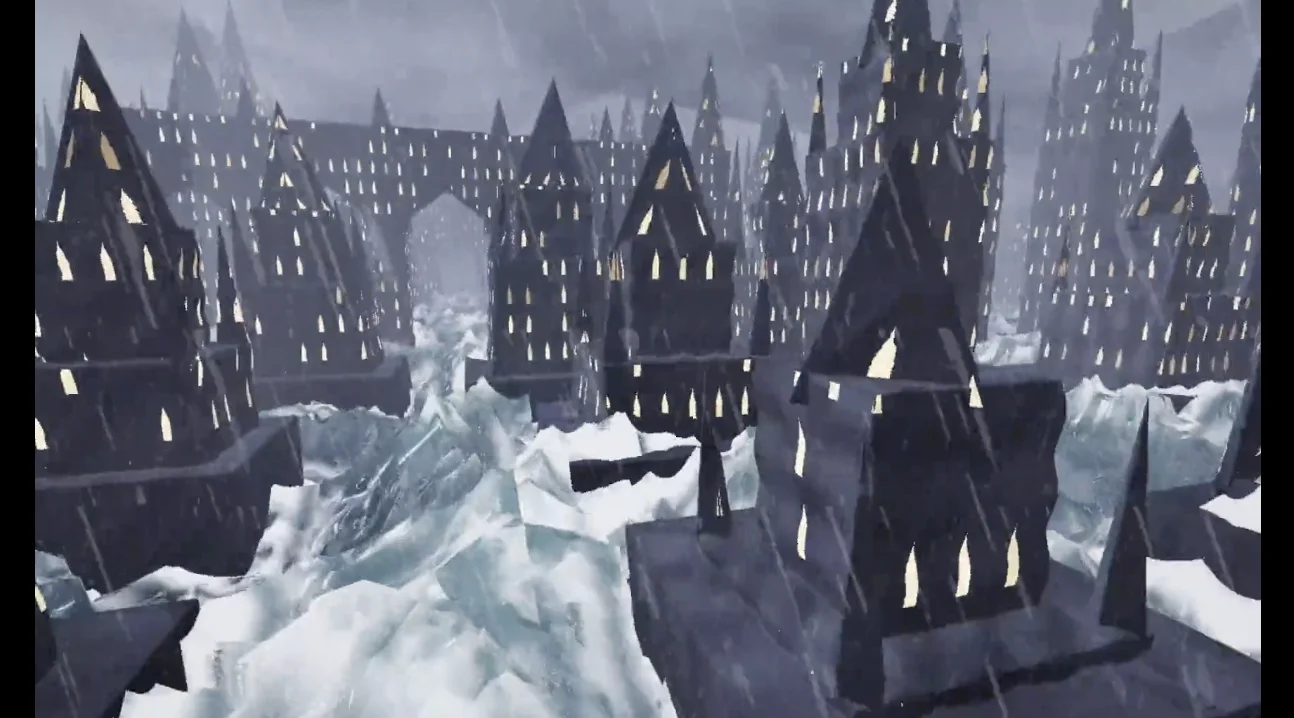
哥特城市被海浪吞沒:
x 網友 Victor Taelin 拿一個真實的項目來做測試。
HVM5 它是一種與高性能計算相關的底層系統。他以前讓過他。 32 個 GPT-5 Agent 跑了大約 20 小時,雖然最高 2 倍加速,但代碼膨脹後質量變差。後來,它被允許了 Opus 4.8 和 GPT-5.5 優化 8 小時,Opus 有 6% 到 34% 有效加速,GPT 結果更好,但文件不能使用。
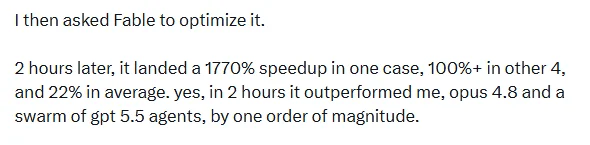
結果,Fable 5 只用了 2 小時,只有一個 benchmark 上提升了 1770%,另外 4 個 benchmark 超過 平均增加100% 22%。
網友的第一反應是不相信,懷疑是不是「硬編碼」 benchmark因為以前被人 GPT 這種問題坑過。
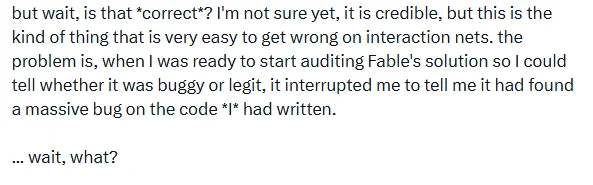
看瞭解釋後,他發現,Fable 優化方向確實合理。
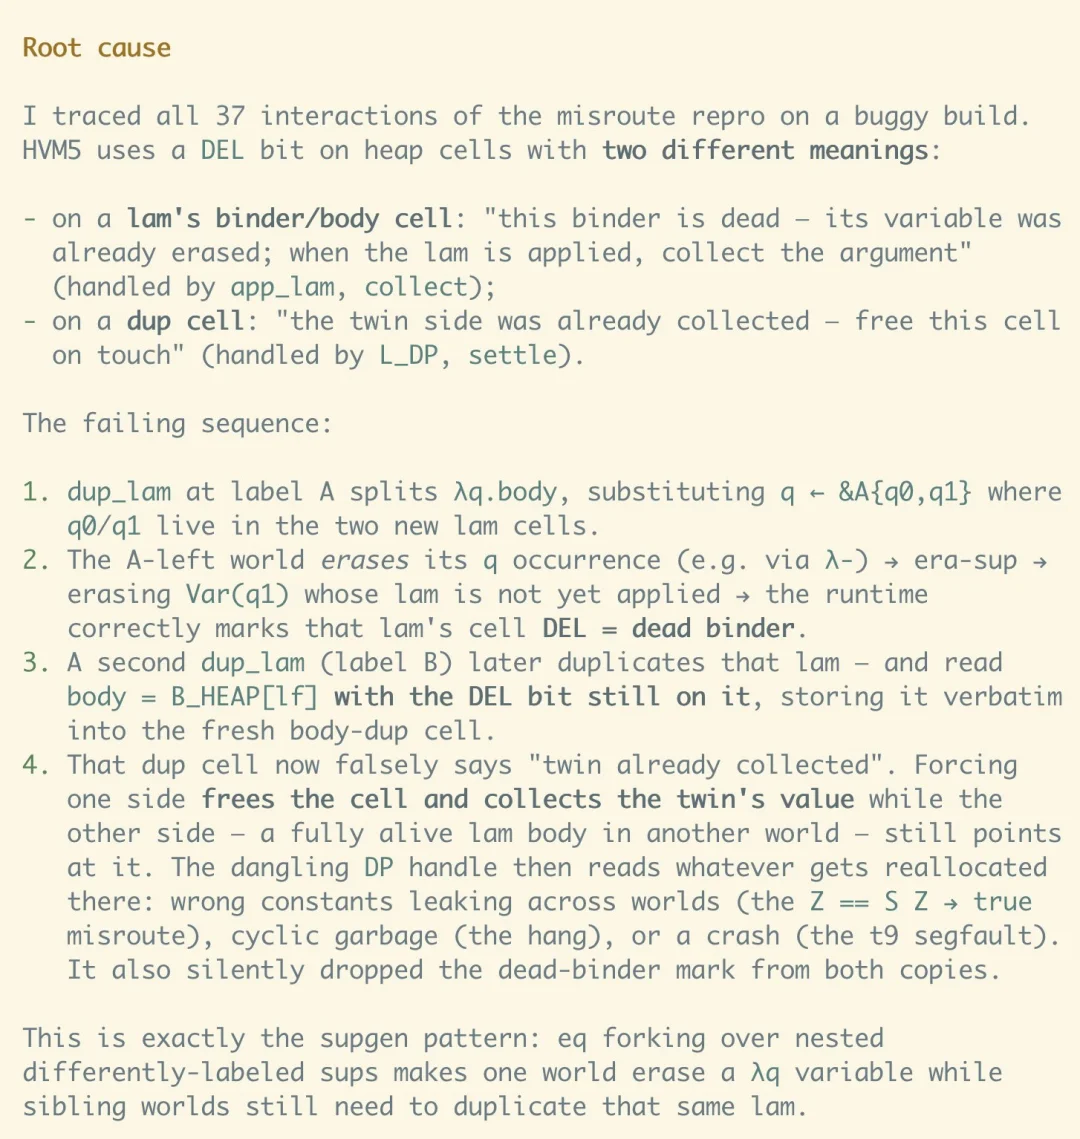
因為 HVM5 在處理動態 pattern-match 節點時,很多無用的分支也被帶到垃圾回收中,浪費了很多時間。網友之前只優化了靜態 match,動態沒有優化 match。Fable 找到這一點,所以測試中的結果變得非常誇張。
這是 Fable 5 給出的 HVM5 bug 根因分析:
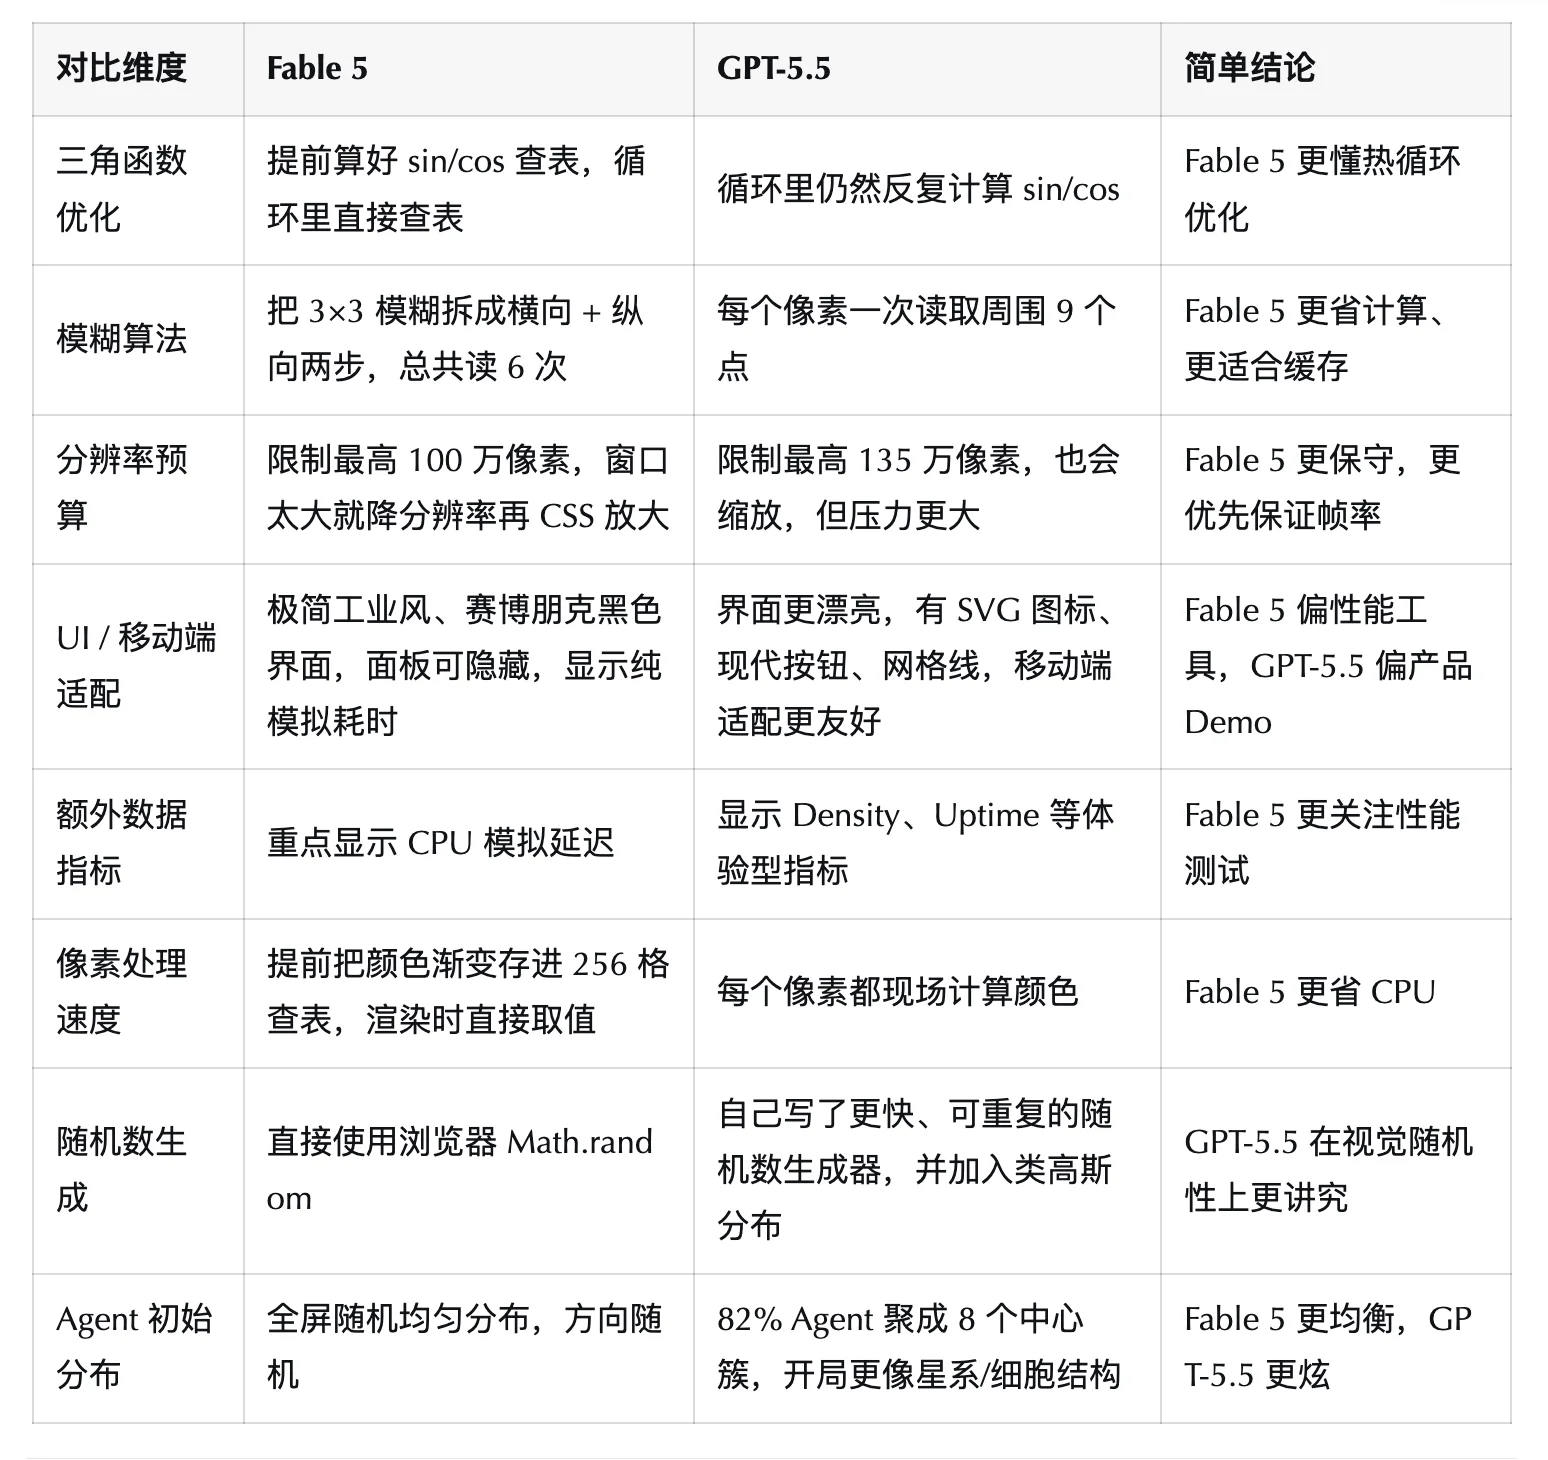
土耳其網友 Alican Kiraz 將 Fable 5 與 GPT 5.5 做了一系列的比較測試。
他的結論是,Fable 5 跑了,花了很多錢 360.55 美元;GPT-5.5 只花了 6 美元。但從細節的優化來看,Fable 5 的確做出了更底層、更硬核、更接近性能工程師思維的優化。
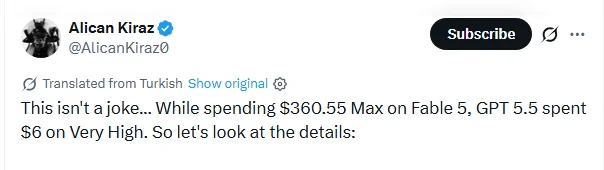
這是他的測試結論:
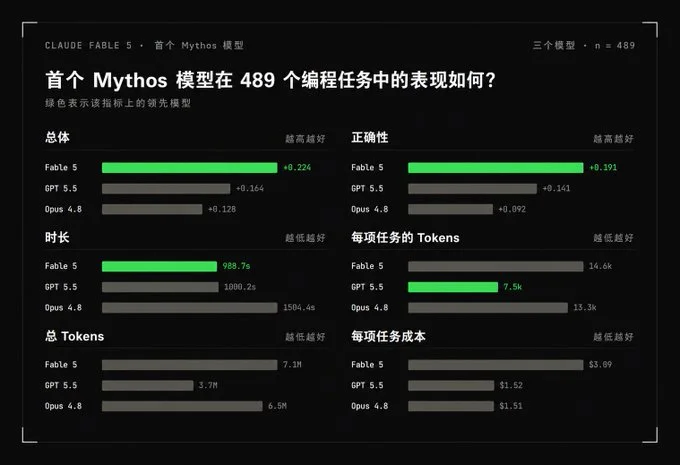
根據第三方編程工具 Augment Code 真實任務測試,Fable 5 編程能力真的很強。
測試一起跑了 489 每個編程任務,Fable 5 總體表現和正確性明顯領先,總分 +0.224,正確性 +0.191。
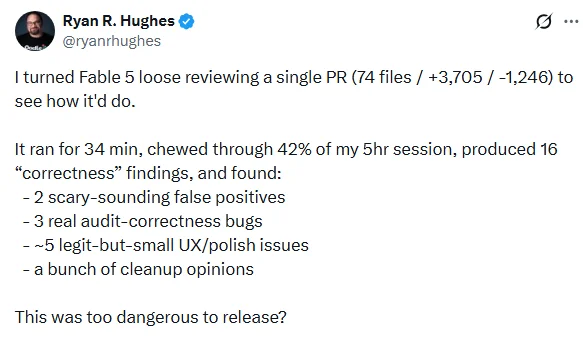
但也有實測失望的例子,x 網友 Ryan R. Hughes 把一個 74 個文件的大 PR 丟給 Fable 5 審查。結果它跑了 34 幾分鐘,吃了 5 小時 Claude Code 會話里的 42% 額度,才給出 16 條發現。
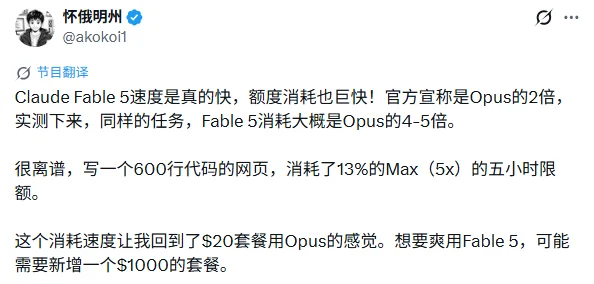
這樣的例子並不少見,Fable 5.有點太貴了。
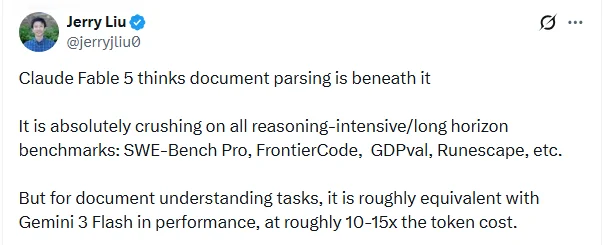
有些人認為,經過實測, Fable 5 長文本解析能力較弱:
更多的差評集中在模型降級操作上:
目前 Fable 5 的 API 價格是每百萬的輸入 token 10 美元,每百萬輸出 token 50 美元。
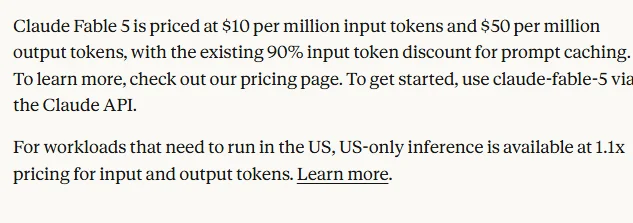
橫向對比一下,這個價格大概是 Opus 4.8 的兩倍,是 Sonnet 4.6 三倍多。單一複雜工作流的實際成本明顯高於以往任何一代 Claude 模型。
而且它的敏感度也調高了:護欄整體趨於保守,寧願誤傷也不願先求穩。
針對成本過高的問題,我收集了下面的網友進行實測,既能幫大家省錢,又能達到很好的效果,模型混用方案:
在像 Cursor 這支持混合模型 IDE 不同的模型可以在平台上分階段使用:
第一階段:代碼審查和項目初步分析,用於預熱上下文,瞭解項目結構 GPT-5.5 High、MiniMax M3、Kimi K2.6 或 Composer 2.5 其中之一。
第二階段:制定項目計劃,使用 GPT-5.5 Very High 或 Opus 4.8 準備項目計劃。
第三階段:分析項目計劃的使用 Fable 5 審查項目計劃,找出計劃中可能出錯的部分。 如需修改計劃,則使用 GPT-5.5 Very High。
第四階段:項目計劃的實施和使用 MiniMax M3、DeepSeek V4 Max、Composer 2.5 或 Sonnet 4.6 實現計劃。
第五階段:最終審查,使用 GPT-5.5 High 代碼審查最終結果,檢查實現是否符合原計劃。
在最正確的地方使用最昂貴的力量是 Fable 5 正確的打開方式。
Claude Fable 5 殺不殺瘋的效果,仁者見仁,智者見智。
但有了它,Token 消費速度很明確,真的是瘋了。
文章來源於微信公眾號 「JackCui」,作者 「JackCui」
有用嗎?