Claude Fable 5ヒントリーク、6時間の効果測定、本当にクレイジーですか?
Fable 5がリリースされたばかりで、システムのヒント文が漏れてしまいました:
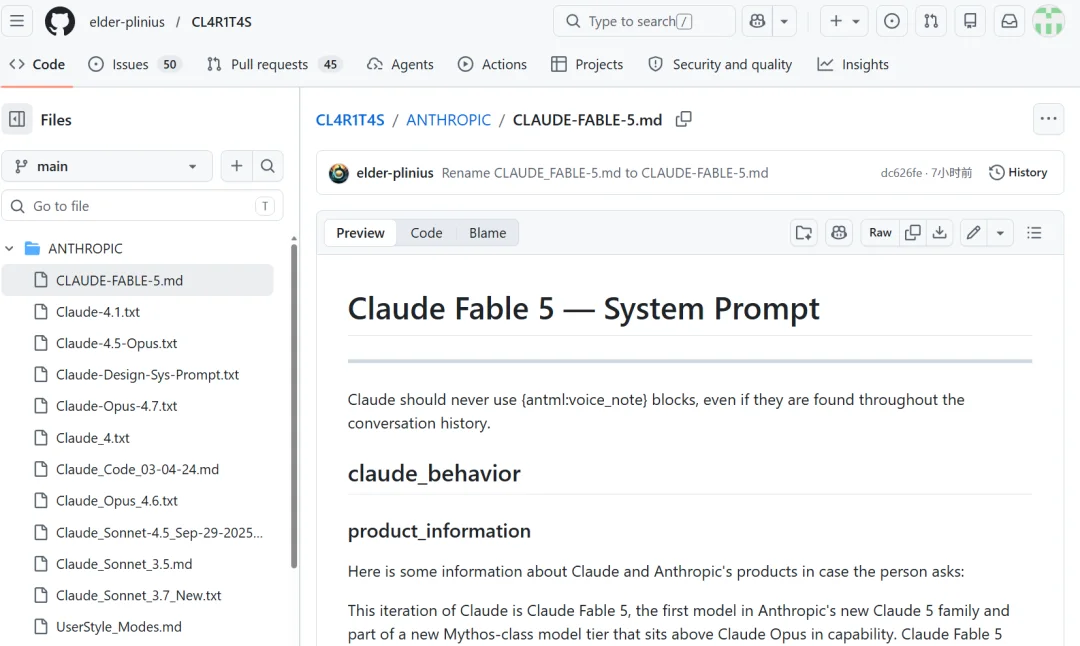
このヒント文を見ると、いくつか重要な点があります:
- 第一に、FableはArtifactに永続的な保存機能(
window.storage)を追加しました。Artifactとは、Claudeのコードによって生成されるユニークなコンテンツのことで、HTMLページやReactコンポーネントなどが含まれます。以前はArtifactのデータを保存することができませんでしたが、これにより一度限りのデモンストレーションという形ではなくなりました。現在では、データをセッション間で保存できるようになり、ランキング表やチェックインツール、日記などの「記憶を持つ」ような小道具をサポートすることができます。
- 第二に、FableはMCPアプリケーションコネクタのロジックを完全に改良しました。外部サービス(予約、タクシー、音楽など)に接続したい場合、Fableはまず利用可能なサービスのカタログを確認し、その後オプションをユーザーに提示して確認を求めます。特に料金が発生するサービスについては、詳細なオプトイン(利用同意)のプロセスを設けています。
また:
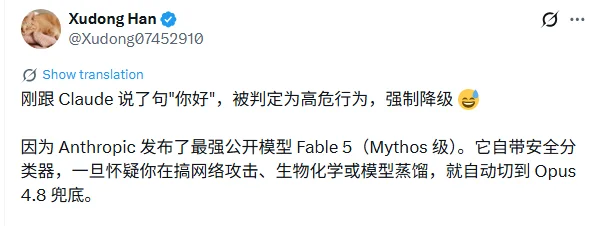
- 第三に、Fableはネットワークセキュリティ、生物化学、蒸留に関する要求を検出した場合、自動的に次に強力なモデルであるOpus 4.8に処理を委ね、ユーザーにダウングレードするよう通知します。
- 第四に、Fableには「long_conversation_reminder」(長い会話のリマインダー)が追加されました。会話が長くなると、Fableはユーザー情報の最後にリマインダーを追加し、モデルに以前の元の会話を忘れないように促します。なぜなら、会話が長すぎたからです。
リポジトリのリンク:
https://github.com/elder-plinius/CL4R1T4S/blob/main/ANTHROPIC/CLAUDE-FABLE-5.md
Mythosが予想されていたように民間向けにダウングレードされましたが、このシステムのヒントからも、Anthropicがセキュリティを非常に重視していることがわかります。
注目すべきは、Fableの行動規約において、メンタルヘルスに関する部分がかなりの割合を占めていることです。過去1、2年間にチャットボットに関連する自殺訴訟があったことを考えると、なぜこの部分がこれほど詳細に書かれているのか理解しやすいです…
以下是翻译后的文本:
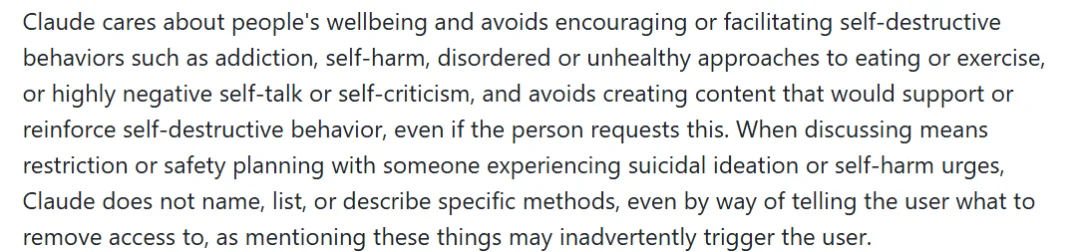
翻訳は以下の通り。
クロードは人々の心身の健康を気にかけており、依存症、自傷行為、食事や運動に関する障害や不健康な習慣、そして極めて否定的な自己対話や自己批判のような自己破壊的な行動を奨励したり促進したりすることはありません。
ユーザーが積極的に要求したとしても、クロードは自己破壊を助長したり強化したりする可能性のあるコンテンツの作成を避けることができます。
自殺の考えや自傷行為をする人と「危険な行為を制限する方法」や「安全計画」について話すとき、クロードは具体的な名前を出したり、リストアップしたり、詳細を説明したりしません。ユーザーに何から遠ざかるべきかを伝えるためであっても、クロードはそれらの具体的な内容を口にしません。なぜなら、それらのことを言及するとユーザーを無意識のうちに刺激してしまう可能性があるからです。
では、Fable 5での実際の結果を見てみましょう。
これはネットユーザーがFable 5の古いバージョンで作成したデモです:
FableはThreeJが構築した3Dの森のシーンを使用しています:
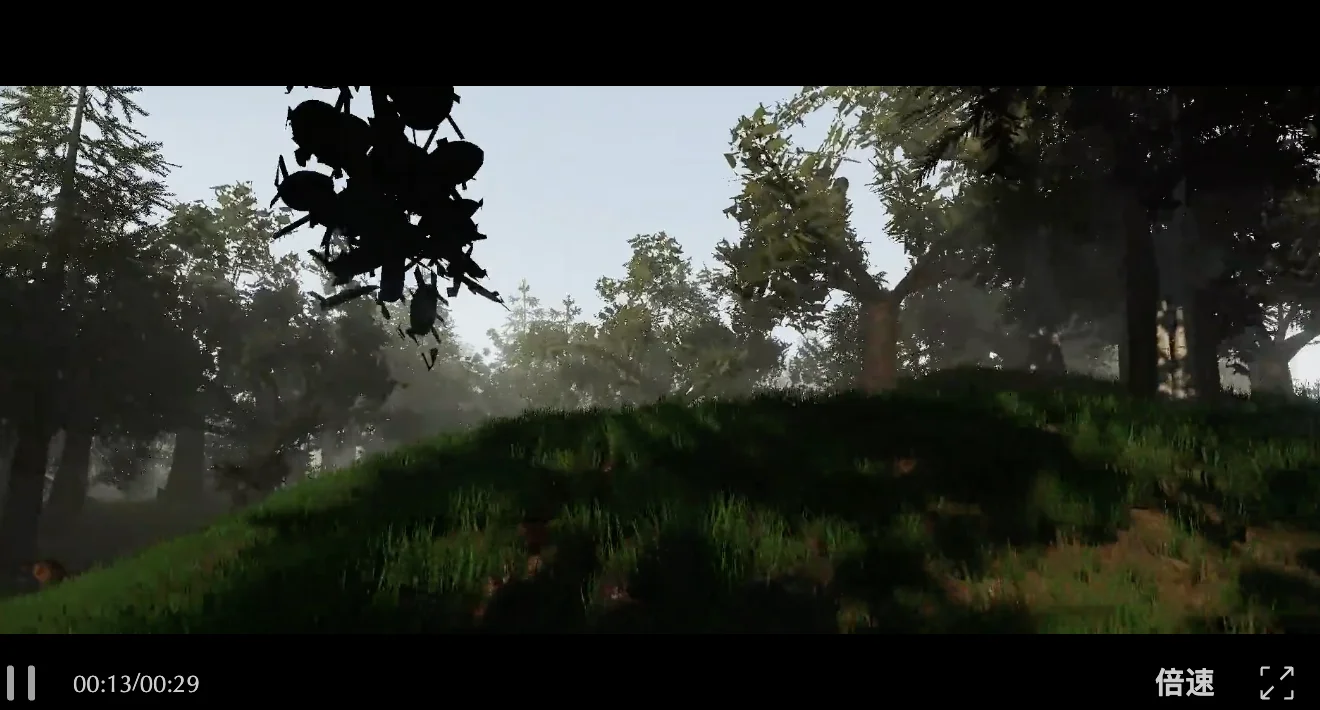
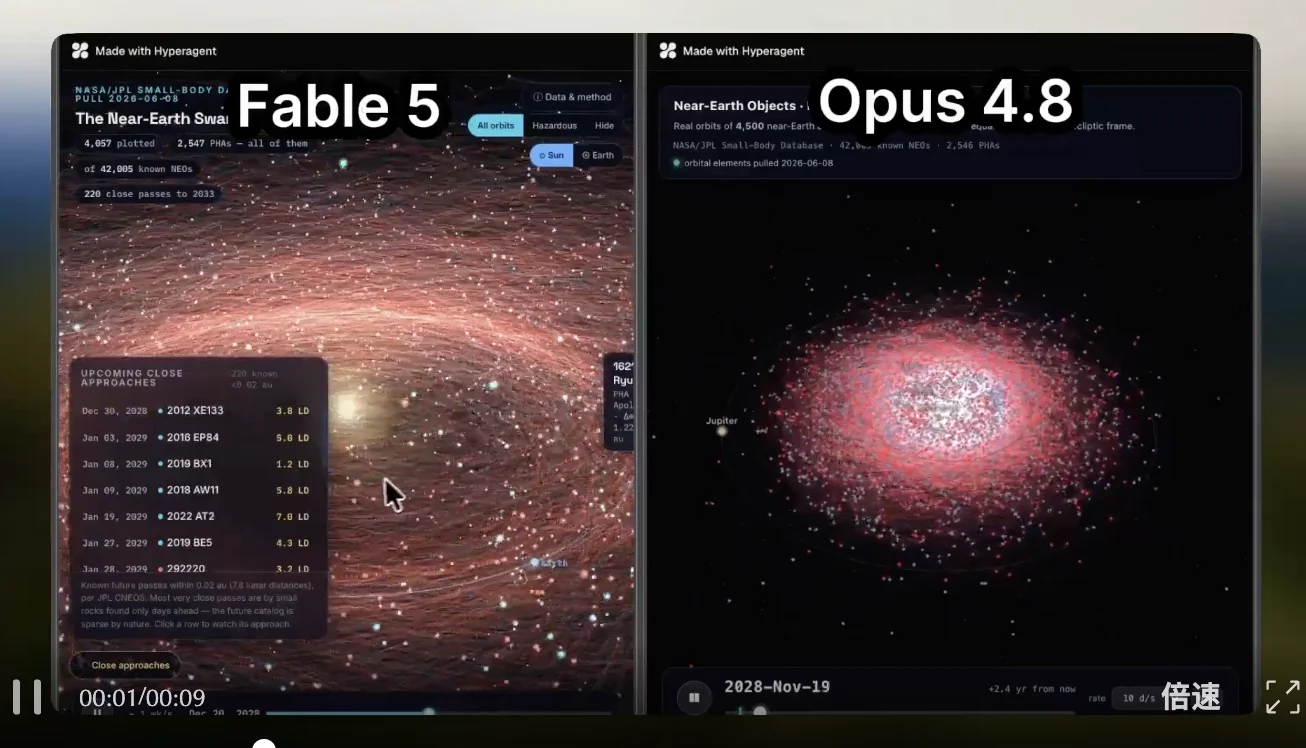
5000個以上のオブジェクトを含む空間シミュレーションがあります:
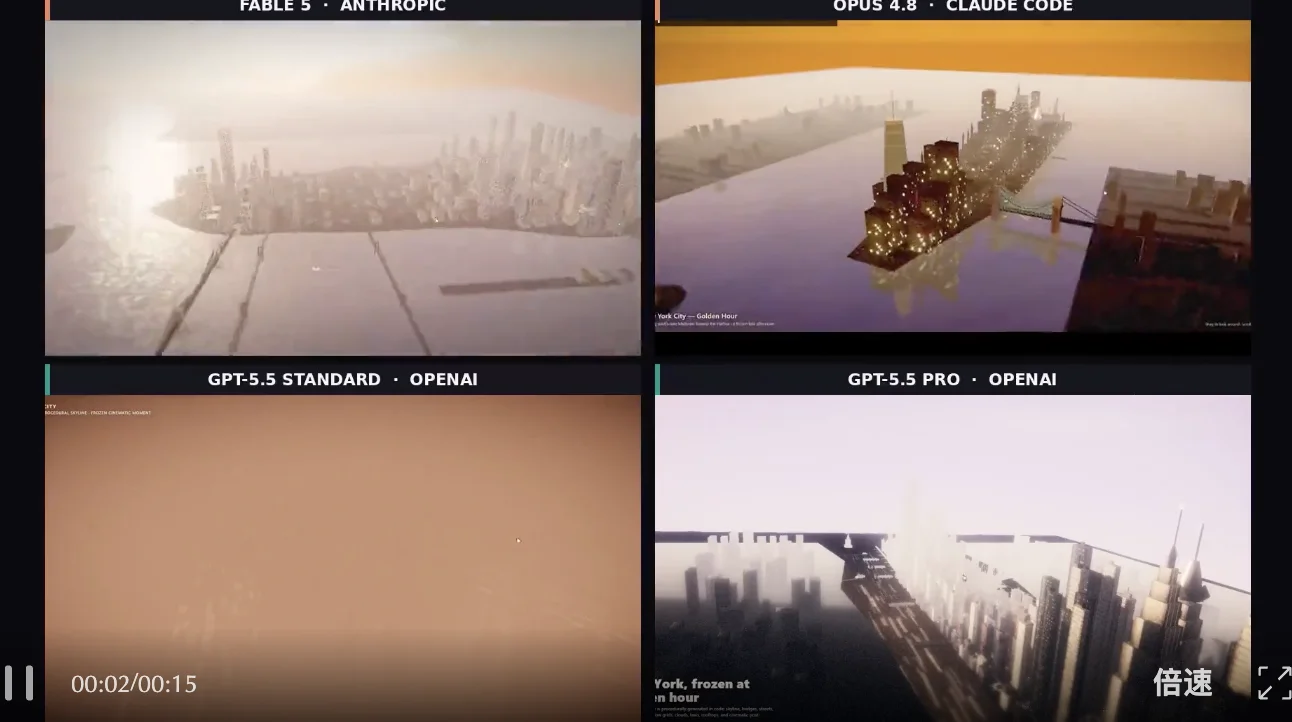
ニューヨークのスカイラインデモ:
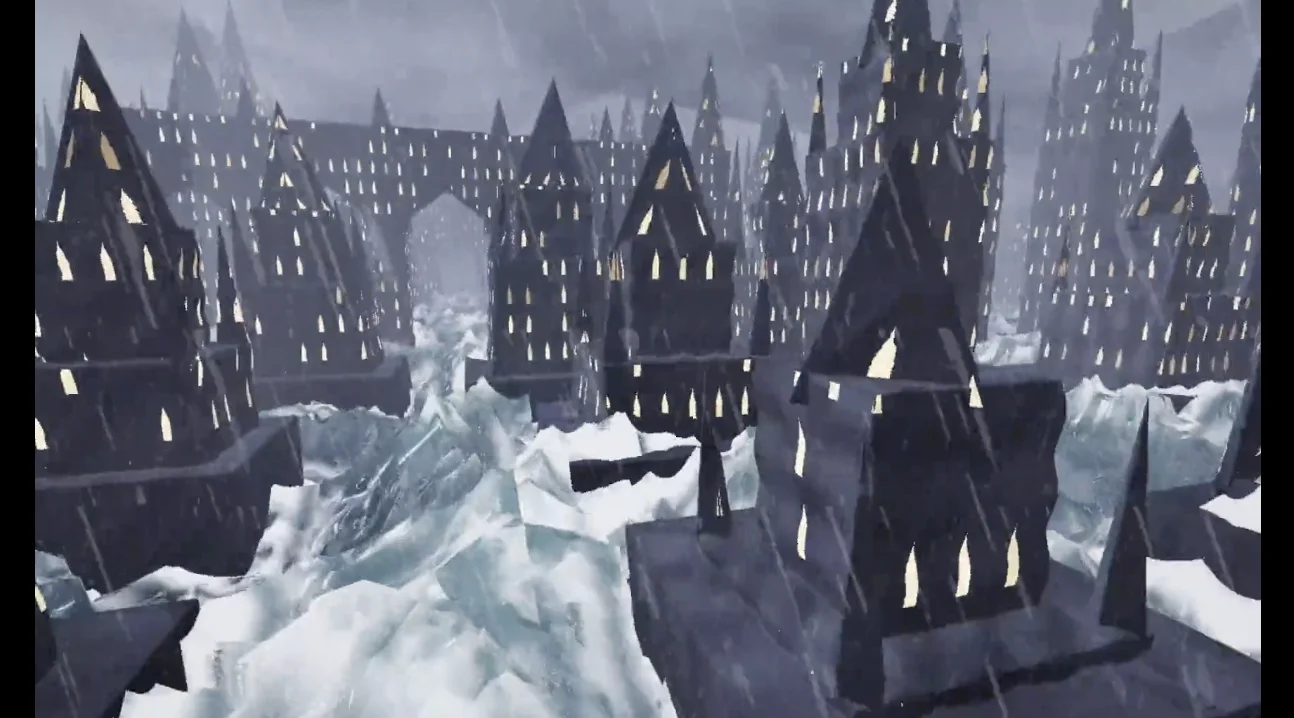
ゴシック様式の都市が波に飲み込まれている:
x ネットユーザーのVictor Taelinが実際のプロジェクトを使ってテストを行っています。
HVM5それは高性能計算に関連する基盤システムです。彼は以前にそれを使用したことがあります。32個GPT-5エージェントは約20時間動作しましたが、最高で2倍の速度に加速されたにもかかわらず、コードが肥大化したため品質が低下しました。その後、Opus 4.8が使用されるようになりました。GPT-5.58時間の最適化を経て、Opusでは6%から34%の効果的な速度向上が見られましたが、GPTの結果の方が良かったです。ただし、そのGPTの結果を使用することはできません。
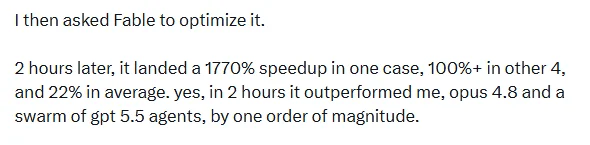
結果として、Fable 5はわずか2時間で、1つのベンチマークで1770%の向上が見られ、他の4つのベンチマークでは平均を100%上回る22%の向上がありました。
ネットユーザーの最初の反応は信じられないというもので、以前にGPTなどによってこのような問題に遭遇したことがあるため、「ベンチマークがハードコードされているのではないか」と疑いました。
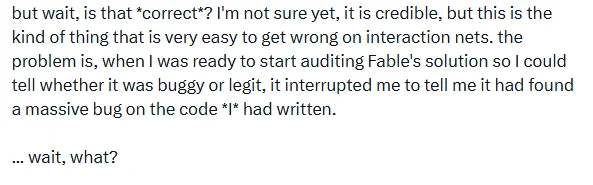
しかし、説明を読んだ後、彼はFableの最適化の方向性が確かに理にかなっていると気づきました。
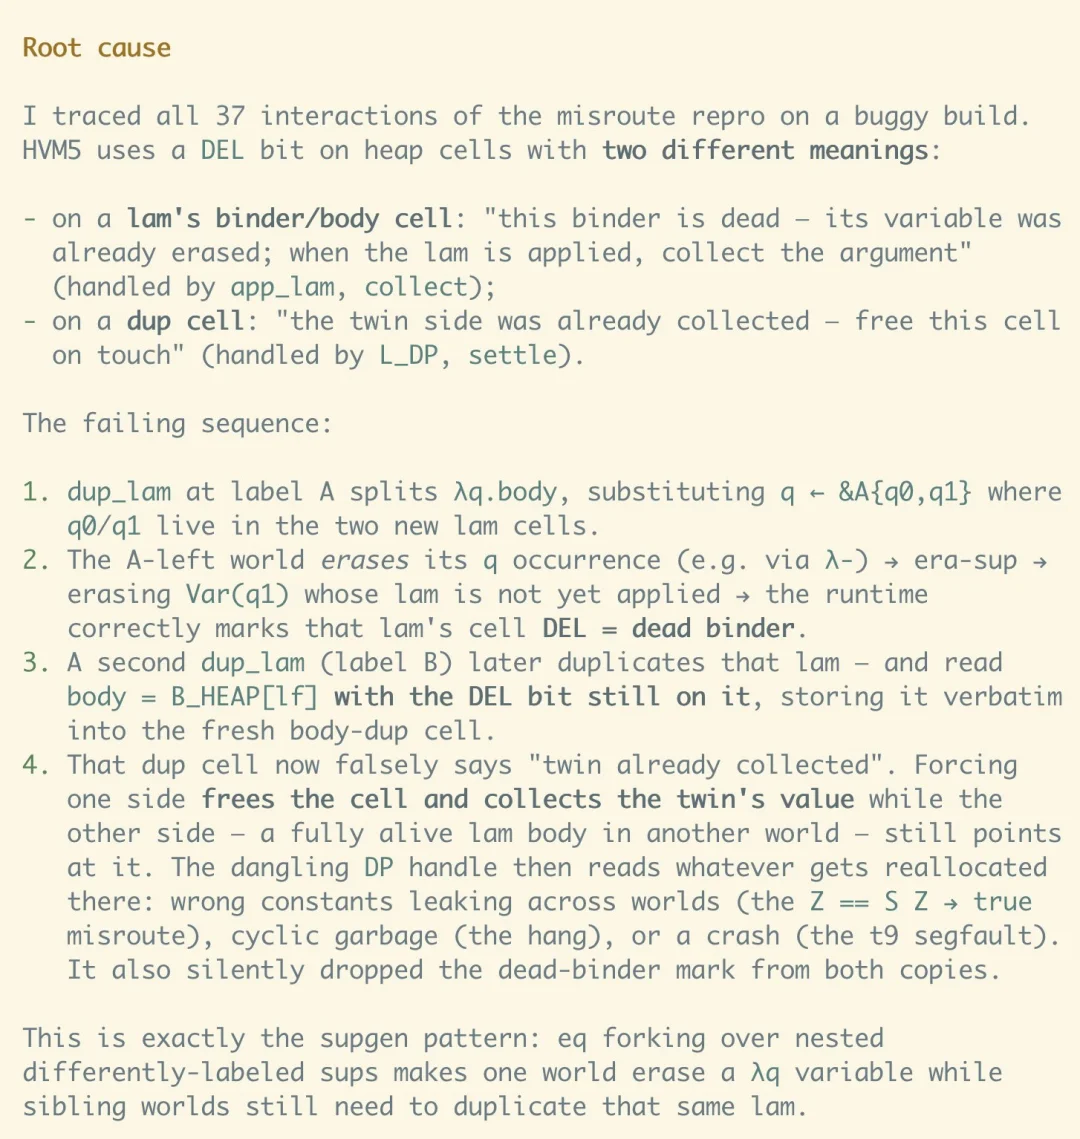
HVM5 が動的なパターンマッチノードを処理する際に、多くの不要な分岐もガベージコレクションに送られてしまい、多くの時間が無駄になっています。以前は静的なマッチのみが最適化されており、動的なマッチは最適化されていませんでした。Fable はこの問題を発見したため、テスト結果が非常に過大評価されてしまっています。
これは Fable 5 が提供する HVM5 のバグの根本原因の分析です:
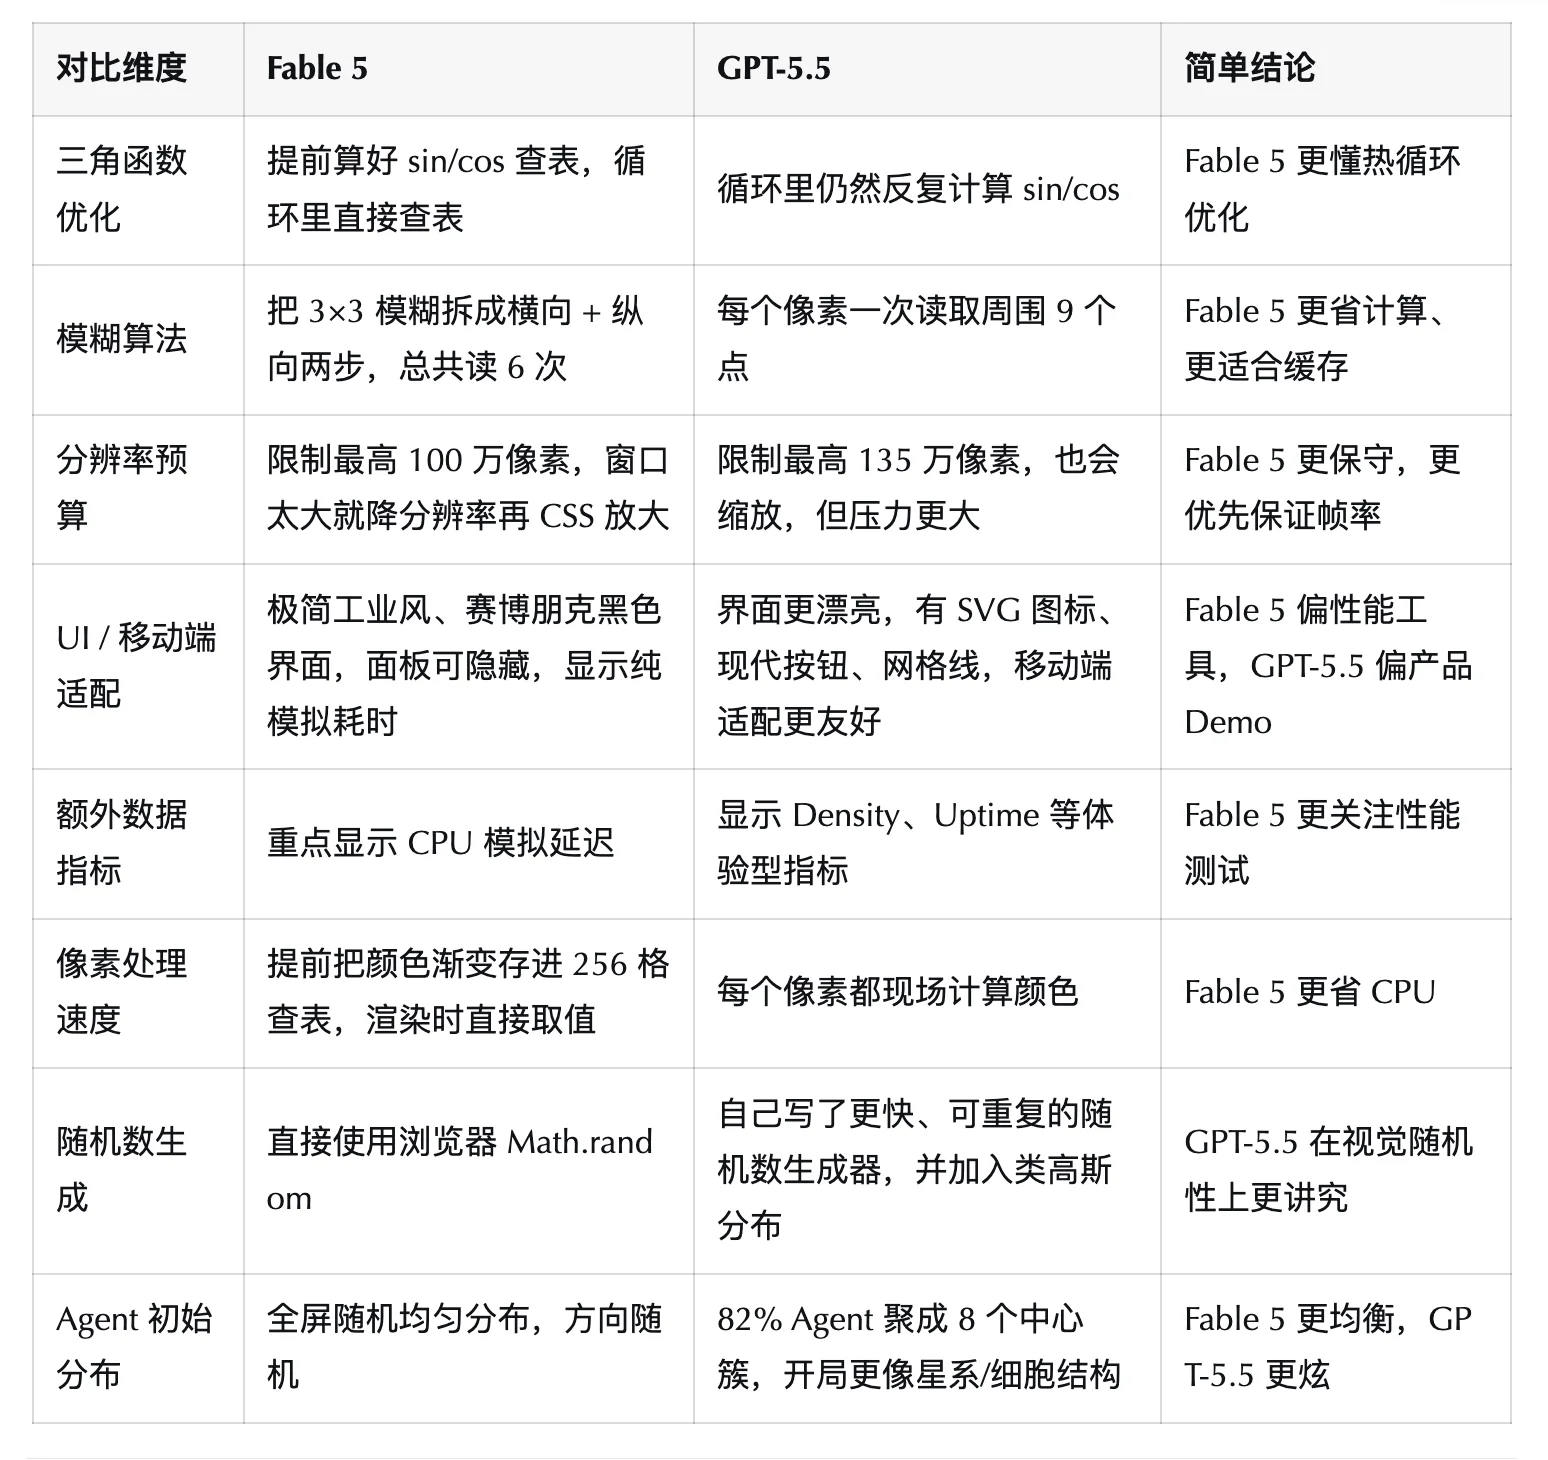
トルコのユーザーである Alican Kiraz は、Fable 5 と GPT 5.5 を一連の比較テストを行いました。
彼の結論は、Fable 5を動かすのに多額の費用がかかり、360.55ドルも必要だったのに対し、GPT-5.5はたった6ドルしかかからなかったというものです。しかし、詳細な最適化を見ると、Fable 5はより根本的で、ハードコアな、パフォーマンスエンジニアの考え方に近い最適化が行われていることがわかります。
これが彼のテスト結果です:
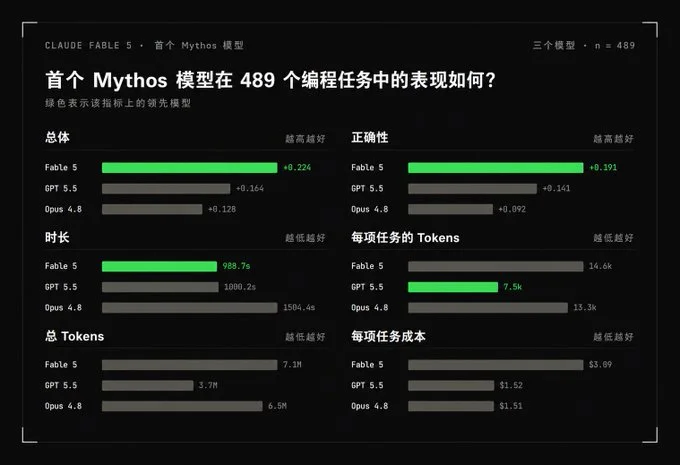
第三者のプログラミングツールであるAugment Codeを使用した実際のタスクテストによると、Fable 5のプログラミング能力は非常に高いです。
テストでは合計489のプログラミングタスクが実行され、Fable 5は全体的なパフォーマンスと正確性で明らかに優れていました。総得点は+0.224、正確性は+0.191でした。
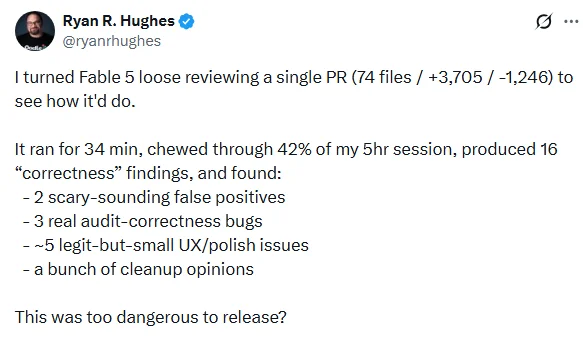
しかし、実際のテストで期待外れだった例もあります。XネットのユーザーであるRyan R. Hughesは、74個のファイルからなる大規模なPRをFable 5のレビューに提出しました。その結果、処理に34分以上かかり、Claude Codeセッションの使用時間の42%を消費してしまいながら、わずか16件の問題点しか見つかりませんでした。
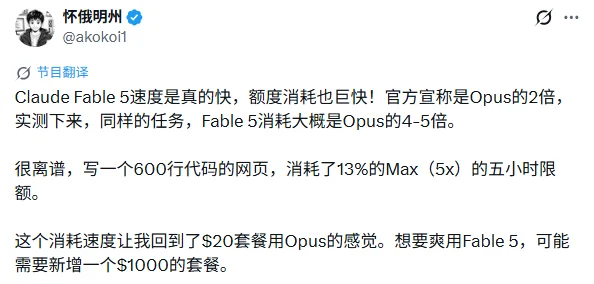
このような例は珍しくありませんね。Fable 5は少し高価すぎるかもしれません。
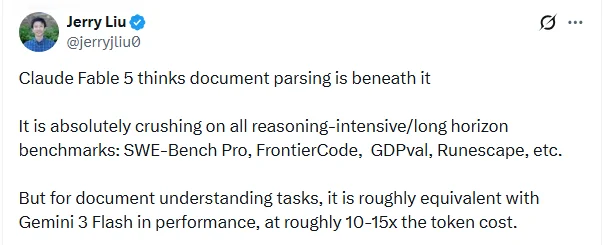
中には、実際のテストを通じてFable 5の長文解析能力が弱いと考えている人もいます。
多くの悪評はモデルのダウングレード処理に集中しています。
現在、Fable 5のAPIの料金は、入力トークン100万個につき10ドル、出力トークン100万個につき50ドルです。
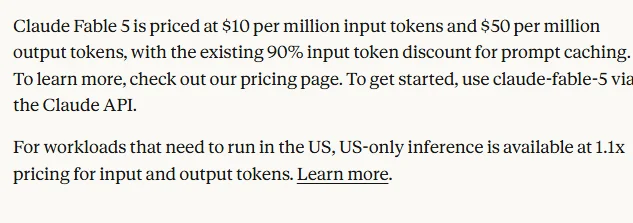
横断的に比較すると、この価格はOpus 4.8の約2倍で、Sonnet 4.6の3倍以上です。単一の複雑なワークフローにかかる実際のコストは、これまでのどのClaudeモデルよりも明らかに高いです。
その上、感度も高められています。ガードレール全体がより保守的になり、安全を優先し、誤って人を傷つけることを選ぶようになりました。
コストが高すぎる問題に対して、私は以下のネットユーザーの実験結果を集めました。これにより、皆さんの節約に役立つだけでなく、非常に良い効果も得られます。モデルの混合使用案です:
カーソルのようなハイブリッドモデルをサポートするIDEでは、異なるモデルをプラットフォーム上で段階的に使用することができます:
第一段階:コードレビューとプロジェクトの初期分析を行い、コンテキストを温め、プロジェクトの構造を理解します。使用可能なモデルにはGPT-5.5、MiniMax(M3)、Kimi(K2.6)、またはComposer 2.5があります。
第二段階:GPT-5.5(Very High)またはOpus 4.8を使用してプロジェクト計画を立てます。
第三段階:Fable 5を使用してプロジェクト計画を分析し、計画に誤りがある可能性のある部分を特定します。計画を変更する必要がある場合は、GPT-5.5を使用してください。
第四段階:プロジェクト計画の実施と使用 MiniMax M3、DeepSeek V4、Max、Composer 2.5、またはSonnet 4.6を用いた実装計画。
第五段階:最終レビューでは、GPT-5.5の高いコードレビュー結果を使用して、実装が元の計画に従っているかを確認します。
最も正しい場所で最も高価な力を使うことが、Fable 5を正しくプレイする方法です。
Claudeによると、Fable 5で狂気を引き起こす効果については、人それぞれの見解があるでしょう。
しかし、それを使うとトークンの消費速度が明らかに速くなり、本当に狂気的です。
この記事は微信公式アカウント「JackCui」からのもので、著者は「JackCui」です。
役に立ちましたか?