Open AI科学者Noam Brown:AIの本当の限界は誰も測定できないかもしれない
大言語モデルが複雑な推論、自動化研究、ネットワークセキュリティなどの困難なタスクに徐々に適用されるにつれて、従来のモデル評価方法は新たな課題に直面しています。長い間、モデルのリリースには、数学、プログラミング、科学の質問応答、ネットワークセキュリティ、知識推論など、さまざまなベンチマークテストの結果が含まれるレポートが伴い、それらが前世代のモデルと比較されてきました。
大言語モデルが複雑な推論、自動化研究、ネットワークセキュリティなどの困難なタスクに徐々に適用されるにつれて、従来のモデル評価方法は新たな課題に直面しています。長い間、モデルのリリースには、数学、プログラミング、科学の質問応答、ネットワークセキュリティ、知識推論など、さまざまなベンチマークテストの結果が含まれるレポートが伴い、それらが前世代のモデルと比較されてきました。
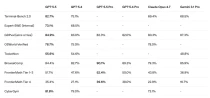
Claude Fable 5は今日、AI分野における中心的な話題であり、この「神話的」なモデルのパフォーマンスは非常に優れており、数多くの注目を集めています。Andrej Karpathy氏は、昨年11 月にClaude 4.5で導入されたものと同じレベルの“大規模なアップグレードに値する飛躍的な進歩”であると述べた。SWE-bench Proプログラミングベンチマークでは、Fable 5は80.3%のスコアを獲得し、Opus 4.8を11ポイント上回った。コードベースに5000 万行のコードを持つRubyは、同じ作業量を人間チームに任せると2 ヶ月以上かかるライブラリ全体の移行を1日で完了しました。
さっき、Anthropicは2ヶ月間隠していた大きな発表をしました——Claude Fable 5そしてMythos 5まるで爆弾を投げ落としたかのようだ。現在、直接OpenAIに圧力をかけましょう。
Fable 5がリリースされたばかりで、システムのヒント文が漏れてしまいました:このヒント文を見ると、いくつか重要な点があります:第一に、FableはArtifactに永続的な保存機能(window.storage)を追加しました。Artifactとは、Claudeのコードによって生成されるユニークなコンテンツのことで、HTMLページやReactコンポーネントなどが含まれます。以前はArtifactのデータを保存することができませんでしたが、これにより一度限りのデモンストレーションという形ではなくなりました。現在では、データをセッション間で保存できるようになり、ランキング表やチェックインツール、日記などの「記憶を持つ」ような小道具をサポートすることができます。
Voice AIは、汎用大モデルとは別の物語の流れです。 皆が汎用大モデルに注目している中で、比較的静かなVoice AIの分野でも、注目に値する新しいモデルが登場し始めています。 キーボードはその「支配的地位」を失いつつあります。 過去2年間で、OpenAIはRealtime APIを発表し、GoogleはGemini Liveをリリースしました。国内の大規模モデル企業もほとんどがVoice AIに注力し始めています。ますます多くの人々が、エージェントが実際にワークフローに組み込まれるようになると、音声がキーボードよりも自然なコンテキストの入り口になると信じるようになりました。 エージェントが本当にワークフローに組み込まれるためには、まずこれらの音声を理解することを学ばなければなりません。そして、そのための最初の能力がASR(自動音声認識)です。 ASRのレベルを測るために、業界ではHugging FaceのOpen ASR Leaderboardがよく引用されます。重要な指標はWER(単語誤り率)で、数値が低いほど認識精度が高いことを意味します。
これ以上ありません