Noam Brown, cientista do OpenAI: o verdadeiro limite superior da IA pode não ser medido por ninguém
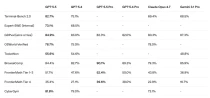
Conforme os grandes modelos de linguagem começam a ser utilizados em tarefas complexas, como raciocínio lógico, pesquisa automatizada e segurança cibernética, os métodos tradicionais de avaliação de modelos enfrentam novos desafios.Por um longo tempo, o lançamento de modelos foi frequentemente acompanhado por tabelas de resultados compostas por vários tipos de testes de benchmark, incluindo matemática, programação, perguntas e respostas científicas, segurança cibernética, raciocínio de conhecimento, etc., e esses resultados eram comparados horizontalmente com o modelo anterior.