• Noam Brown, científico de OpenAI: el verdadero límite de la IA, que nadie puede permitirse medir

    A medida que los grandes modelos de lenguaje comienzan a abordar tareas complejas como la inferencia, la investigación automatizada y la seguridad cibernética, los métodos tradicionales de evaluación de modelos se enfrentan a nuevos desafíos.Durante mucho tiempo, el lanzamiento de modelos ha ido acompañado de tablas de resultados que incluyen una variedad de pruebas de referencia relacionadas con matemáticas, programación, preguntas y respuestas científicas, seguridad cibernética, inferencia de conocimiento, etc., y se comparan con los modelos de la generación anterior.
    Noam Brown, científico de OpenAI: el verdadero límite de la IA, que nadie puede permitirse medir
  • Claude se vuelve estúpido mientras trabaja en IA, y Anthropic es atacado por la comunidad de investigación.

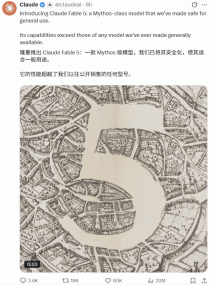
    Claude Fable 5 es el foco central en el campo de la IA de hoy en día; este modelo de «nivel mítico» tiene un rendimiento excepcional y ha atraído mucha atención.Andrej Karpathy lo describió como «muy emocionante» y como un «progreso significativo que justifica una gran actualización», al mismo nivel que las mejoras introducidas por Claude 4.5 en noviembre del año pasado. En el benchmark de programación SWE-bench Pro, Fable 5 obtuvo un puntaje del 80.3%, superando a Opus 4.8 en un 11% completo. Con un código base de Ruby que consta de 50 millones de líneas, Fable 5 logró realizar la migración de todo el código base en un día; si el mismo trabajo se le encargara a un equipo humano, tomaría más de dos meses.

    Claude se vuelve estúpido mientras trabaja en IA, y Anthropic es atacado por la comunidad de investigación.
  • ¡GPT-5.6 ha llegado el primer lote de mediciones! El Sniper Mythos

    Just ahora, Anthropic lanzó su gran “asesino” que ha estado en desarrollo durante dos meses…Claude Fable 5yMythos 5Es como lanzar una bomba.Ahora ejercemos presión directamente sobre OpenAI.

    ¡GPT-5.6 ha llegado el primer lote de mediciones! El Sniper Mythos
  • Claude Fable 5 filtraciones de consejos, 6 horas de resultados probados, ¿realmente loco?

    Fable 5 acaba de lanzarse, y ya se han filtrado las palabras de提示 (palabras utilizadas por el sistema para guiar al usuario):Después de leer esta sugerencia, hay varios puntos clave:Primero, Fable ha añadido una API de almacenamiento persistente para los Artifact (window.storage). Un Artifact es contenido único generado por el código de Claude, como páginas HTML, componentes React, etc. Anteriormente, los datos de los Artifact no se podían guardar y se comportaban más como demostraciones de uso único. Ahora, los datos se pueden guardar entre sesiones, lo que permite el funcionamiento de herramientas "con memoria", como clasificaciones, registradores de asistencia, diarios, etc.

    Claude Fable 5 filtraciones de consejos, 6 horas de resultados probados, ¿realmente loco?
  • El creciente mercado de la IA de voz ha visto la aparición de una nueva startup llamada Hojo.

    La IA de voz es otra línea de desarrollo aparte de los grandes modelos generales. Mientras todos prestan atención a los grandes modelos generales, en el campo relativamente tranquilo de la IA de voz también han comenzado a aparecer algunos modelos nuevos que merecen ser destacados. El teclado está perdiendo su “dominio”. En los últimos dos años, OpenAI lanzó la API en tiempo real (Realtime API), Google desarrolló Gemini Live, y casi todas las empresas chinas que trabajan con modelos grandes también han comenzado a invertir en la IA de voz. Cada vez más personas creen que, una vez que los agentes (agents) se integren realmente en los flujos de trabajo, el sonido se convertirá en una entrada al contexto más natural que el teclado. Si un agente quiere integrarse realmente en los flujos de trabajo, primero debe aprender a comprender estos sonidos. Y la primera capacidad necesaria para ello es el ASR (Reconocimiento Automático de Voz). Para medir el nivel de ASR, la industria suele utilizar la tabla de líderes Open ASR de Hugging Face, cuyo indicador clave es la tasa de errores de palabras (WER); cuanto más baja sea la tasa, más precisa es la reconocición.

No hay más contenido