• Noam Brown, scientifique d'OpenAI : la véritable limite supérieure de l'IA, personne ne peut se permettre de la mesurer

    Alors que les grands modèles linguistiques commencent à être utilisés pour des tâches complexes telles que la raisonnement, la recherche automatisée et la sécurité des réseaux, les méthodes traditionnelles d'évaluation des modèles font face à de nouveaux défis.Depuis longtemps, la publication de modèles est accompagnée d'une table de résultats composée de divers tests de benchmark, incluant des tests en mathématiques, en programmation, en questions scientifiques, en sécurité informatique et en raisonnement cognitif, et ces résultats sont comparés horizontalement avec ceux de la génération précédente de modèles.
    Noam Brown, scientifique d'OpenAI : la véritable limite supérieure de l'IA, personne ne peut se permettre de la mesurer
  • Claude devient stupide pendant qu 'il fait de la recherche sur l'IA, et Anthropic est assiégé par la communauté de recherche.

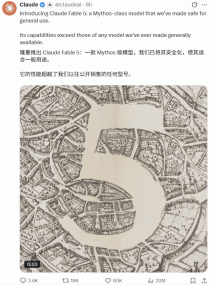
    Claude Fable 5 est le sujet central de l'actualité dans le domaine de l'IA aujourd'hui, ce modèle « de niveau mythique » présente des performances exceptionnelles et a attiré une immense attention.Andrej Karpathy a qualifié cela de « très excitant » et a décrit cela comme un « progrès significatif justifiant une mise à niveau majeure », au même niveau que les améliorations apportées par Claude 4.5 en novembre dernier. Dans le benchmark de programmation SWE-bench Pro, Fable 5 a obtenu une note de 80,3 %, dépassant Opus 4.8 de 11 points de pourcentage. Avec un codebase de 50 millions de lignes en Ruby, Fable 5 a réussi à migrer l’ensemble du codebase en une seule journée, tandis qu’une équipe humaine mettrait plus de deux mois pour accomplir la même tâche.

    Claude devient stupide pendant qu 'il fait de la recherche sur l'IA, et Anthropic est assiégé par la communauté de recherche.
  • GPT-5.6 Les premières mesures sont arrivées ! Sniper de précision Mythos

    Just now, Anthropic released the “Big Killer” that it had been working on for two months—Claude Fable 5etMythos 5C'est comme lancer une bombe.Mettre directement la pression sur OpenAI.

    GPT-5.6 Les premières mesures sont arrivées ! Sniper de précision Mythos
  • Claude Fable 5 fuites d'indices, 6 heures d'effet testé, vraiment fou ?

    Fable 5 vient de sortir, et les mots de提示 (提示词) du système ont déjà fuité :Après avoir regardé ces mots de提示, il y a quelques points importants à noter :Premièrement, Fable a ajouté une API de stockage permanent aux Artifacts (window.storage). Un Artifact est un contenu unique généré par le code Claude, tel que des pages HTML ou des composants React. Auparavant, les données des Artifacts ne pouvaient pas être sauvegardées et ressemblaient plus à des démonstrations éphémères. Désormais, les données peuvent être conservées entre les sessions, ce qui permet de soutenir des outils “mémorables” tels que des classements, des enregistreurs d'activités ou des journaux.

    Claude Fable 5 fuites d'indices, 6 heures d'effet testé, vraiment fou ?
  • Le marché de l'IA vocale, en plein essor, a vu l'apparition d'une start-up nommée Hojo.

    L'IA vocale représente une autre voie de développement parallèle aux grands modèles généraux. Alors que tout le monde se concentre sur ces derniers, le domaine de l'IA vocale, jusqu'à présent relativement calme, commence également à voir apparaître de nouveaux modèles intéressants. Le clavier perd progressivement son « statut de domination ». Au cours des deux dernières années, OpenAI a lancé la Realtime API, Google a développé Gemini Live, et de nombreuses entreprises chinoises spécialisées dans les grands modèles ont également commencé à se concentrer sur l'IA vocale. De plus en plus de personnes croient que, lorsque les agents intelligents seront réellement intégrés aux flux de travail, la voix deviendra un moyen d'accès au contexte plus naturel que le clavier. Pour que les agents intelligents puissent être efficacement intégrés aux flux de travail, ils doivent d'abord apprendre à comprendre les voix humaines. La première compétence essentielle à cet égard est l'ASR (reconnaissance automatique de la voix). Pour évaluer le niveau d'ASR, le tableau de classement Open ASR de Hugging Face est le plus souvent utilisé dans l'industrie. L'indicateur clé est le taux d'erreurs de mot (WER) : plus ce chiffre est bas, plus la reconnaissance est précise.

Aucun autre contenu