Open AI科学者Noam Brown:AIの本当の限界は誰も測定できないかもしれない
大言語モデルが複雑な推論、自動化研究、ネットワークセキュリティなどの困難なタスクに徐々に適用されるにつれて、従来のモデル評価方法は新たな課題に直面しています。
長い間、モデルのリリースには、数学、プログラミング、科学の質問応答、ネットワークセキュリティ、知識推論など、さまざまなベンチマークテストの結果が含まれるレポートが伴い、それらが前世代のモデルと比較されてきました。
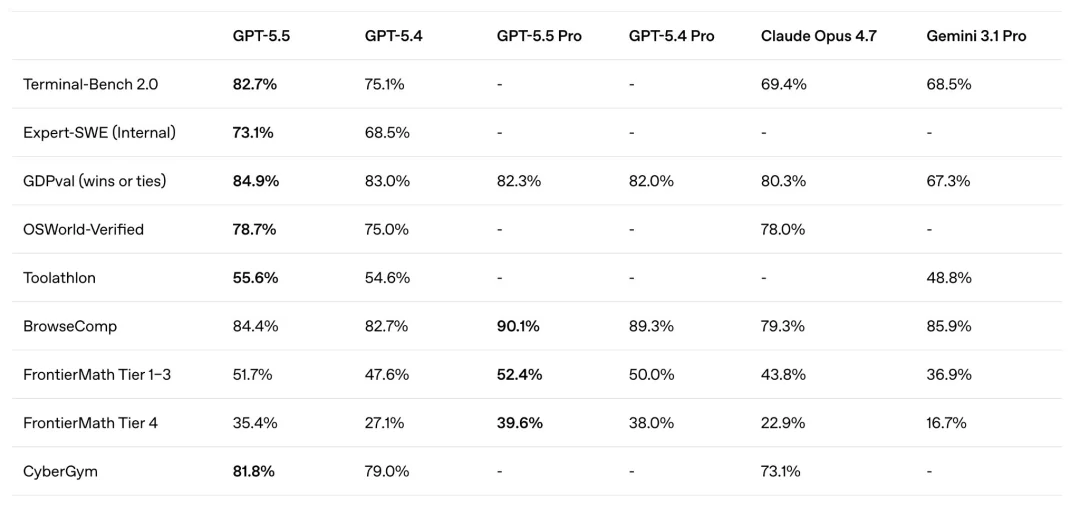
オープンAIの研究者ノアム・ブラウンによると、この記事では、モデルが質問に答える際により多くの推論ステップを使用したり、より多くのツールを呼び出したり、より長時間の検索やテストを行ったりすると、単一のスコアだけではモデルの実際の能力を正確に反映することが難しくなると指摘されています。
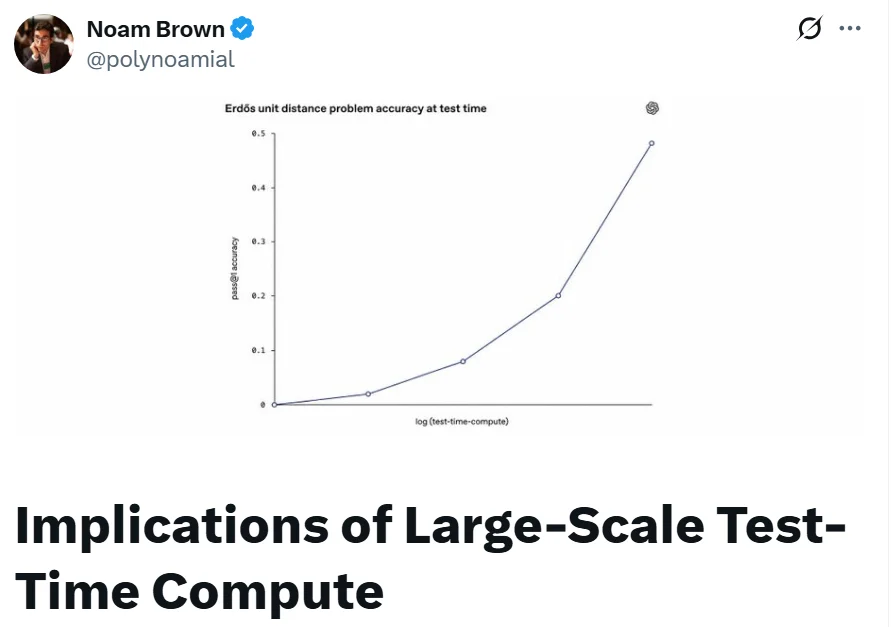
ブラウンの核心的な見解は以下の通りです:大規模モデルの性能は、モデル自体だけでなく、推論段階でどれだけの計算リソースを利用できるかにも依存します。将来のモデル評価を行う際には、「モデルはどれだけのスコアを獲得したか?」というだけでなく、もう一つの質問にも答える必要があります。それは、「モデルはどれだけのトークンを消費し、どのようなコストと実行時間の条件下でその結果を達成したのか?」ということです。
彼は、業界が「単一の成果」から「推論計算量の曲線によるパフォーマンス」へと考え方を根本的に変えるべきだと提案しており、推論にかかる予算を人工知能のセキュリティポリシーにおけるモデル能力の評価や基本的な変数として捉えるべきだと述べています。
伝統的な成績表は、新しいモデルの能力の差を過小評価している可能性があります。
Brownは、GPT-5.5で公開後の市場反応を例に挙げて、従来のモデルによるランキングの限界を説明しました。
彼の説明によると、GPT-5.5のリリース初期に、外部から最初に注目されたのはあまり目立たないベンチマークテストの結果でした。そして、GPT-5.4と比較して新しいモデルのスコアは向上していましたが、従来のスコア表から見ると、その向上幅は限定的のようでした。そのため、一部のユーザーは新しいバージョンに対して慎重な態度を取るか、あるいは疑問を持っているようです。
しかし、モデルが公開されて数時間後、一部のユーザーは、開発者や研究者がより複雑なタスクのテストを始めるにつれて、GPT-5.5が長い推論の連鎖、継続的な実行、複雑な問題の処理において、より顕著な世代間の差異を示すことに気づきました。Brownは、この「実際の経験が明らかに向上しているにもかかわらず、リストスコアの変化が限定的である」という現象は、従来の評価方法がモデルの能力を完全には反映していないことを示していると考えています。
問題は、異なるモデルの評価結果が同じ推論予算に基づいていない可能性があるということです。
伝統的な評価フレームワークでは、研究者は各モデルに対して一連のテスト設定を選択し、結果をできるだけ向上させるようにします。そして、最終的なスコアを同じ表にまとめます。これは公平に見えますが、重要な変数を見落とす可能性があります。つまり、一部のモデルはより多くの推論トークンを受け取ったり、より多くの呼び出しを行ったり、より長い実行時間を経た後でも、パフォーマンスをさらに大幅に向上させることができるかもしれません。一方で、他のモデルはより早くパフォーマンスの上限に達するかもしれません。
Brownが示したネットワークセキュリティ評価の事例によると、いわゆるモデル同士を単純に比較し、「最大テスト時の計算量」の条件での最終結果だけを見る場合、GPT-5.5の優位性はGPT-5.4に比べてそれほど顕著ではないかもしれません。しかし、もし計算量、推論コスト、遅延を同じレベルに抑えた上で異なるモデルの性能を観察するならば、GPT-5.5の能力向上はより明らかになるでしょう。
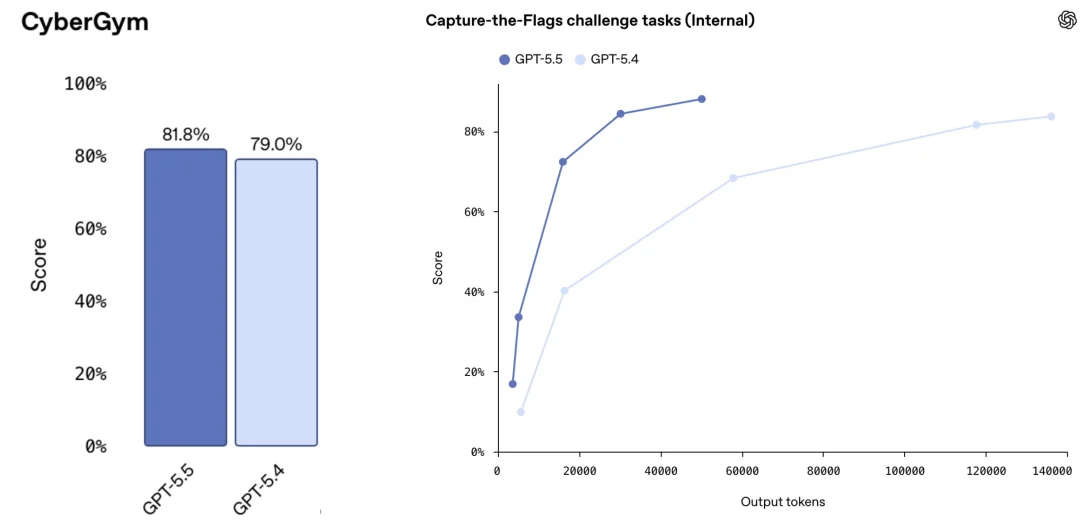
つまり、モデル間の差異は最終得点だけでなく、追加の推論計算量の効率にも表れています。
なぜシンプルにできないのでしょうか?「性能が向上しなくなるまで続ける」という方法です。
直感的な解決策は、各モデルに推論リソースを継続的に追加し、その性能が安定するまで待つことです。その後、各モデルの最高能力を比較します。
ブラウンは、このアイデアが実際には実行不可能だと考えています。その理由は、新世代のモデルにとって、パフォーマンスの安定期が予想よりもはるかに遅くなる可能性があり、実際に許容できる予算の範囲内でそれを観察することが難しいからです。
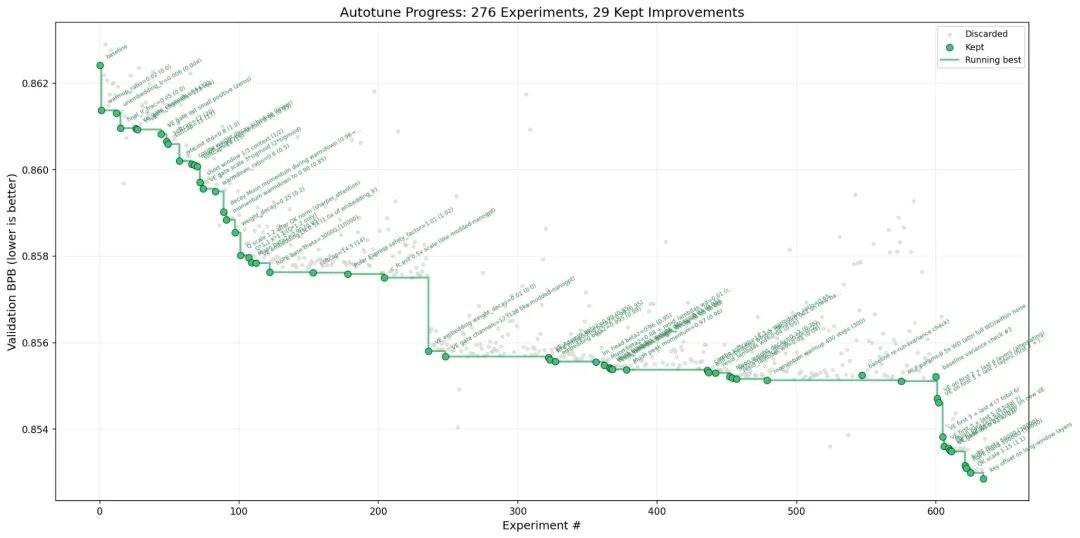
彼は、Andrej Karpathyが開始した自動化研究実験を例に挙げました。その実験では、モデルが多数の実験を続けた後でも、性能は改善し続ける傾向にありました。実験を数百回行っても、改善の曲線は決して緩やかになることはありませんでした。
Brown また、英国の人工知能セキュリティ研究所(AI Security Institute)によるネットワークセキュリティ評価の結果も紹介されています。この評価では、MythosやGPT-5.5を含むいくつかのモデルが対象とされ、1億個以上のトークンを使用した後でも、タスクのパフォーマンスが継続的に向上していることが示されています。
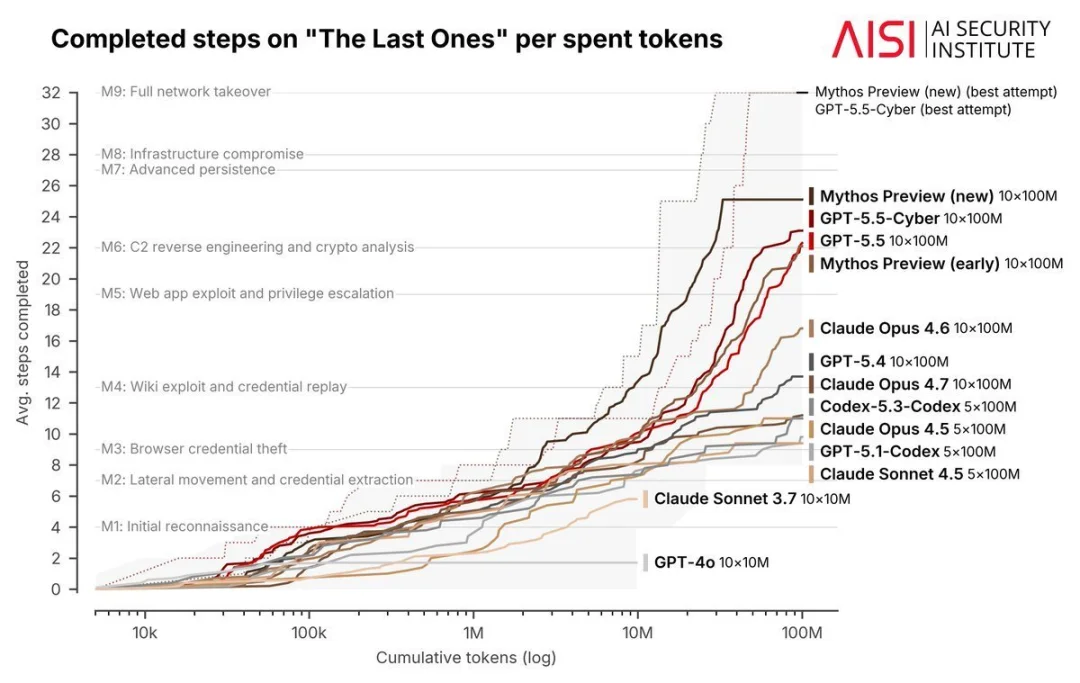
この現象は、モデルがより長い実行時間とより多くの推論リソースを利用することで、複雑なタスクにおいて継続的に戦略を探求し、試行し、修正できることを意味しています。より強力なモデルは、より高い出発点を持つだけでなく、追加の計算リソースを効果的な能力に変換するのがより得意かもしれません。
ブラウンによると、モデルの能力が向上するにつれて、効果的に動作できるタスクのサイクルも長くなると推測されています。過去には、比較的限られた予算の下でモデルのパフォーマンスが安定する傾向が見られましたが、将来的にはそのパフォーマンスの上限がさらに引き上げられる可能性があります。特定のタスクにおいては、いわゆる「プラットフォーム期」がもはや簡単に測定できる状態ではなくなるかもしれません。
単一のスコアから「パフォーマンスとコストの曲線」へ
この変化に直面して、ブラウンはモデルの公開機関に対し、ベンチマークテストの表示方法を変更することを提案しています。
最終得点だけを公表するよりも、横軸に推論計算量を、縦軸にタスクのパフォーマンスを示し、完全なパフォーマンス変化曲線を描く方が良いでしょう。横軸にはトークン数、推論コスト、実際の実行時間などの指標を使用することができます。
この方法は、従来の成績表では説明が難しい問題に答えることができます。例えば、同じ予算の下でどのモデルのパフォーマンスが良いのか?予算が10倍に増えたとき、どのモデルの改善がより速いのか?モデルはその能力の上限に近づいているのか?異なるモデルのコスト効果はどのように変化するのか?
類似の方法がすでにいくつかのベンチマークテストで使用され始めています。Brownによると、ARC-AGI評価はモデルのスコアと運用コストの関係を測定しようとしており、単に一つのスコアを公開するだけではありません。
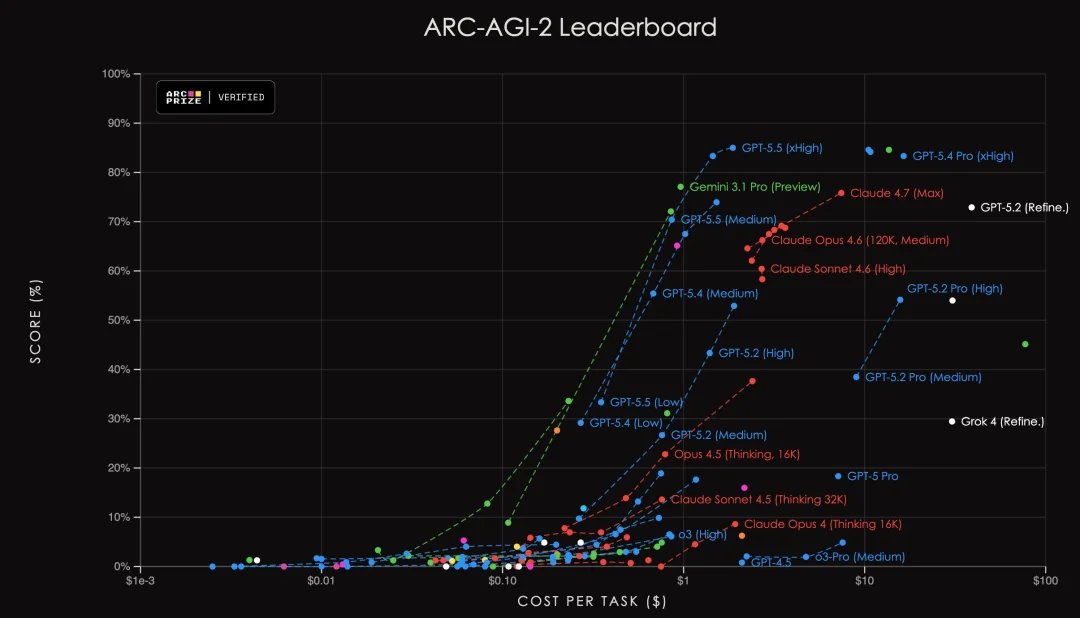
もう一つの実行可能な方法は、評価のために明確なスキームトークン、コスト、または時間制限を設定し、事前にモデルに予算情報を通知することです。これは、人間が標準化された試験に参加するのに似ています。例えば、アメリカの大学入試であるSATや国際数学オリンピックでは、受験生は指定された時間内に問題を解く必要があります。このようにして、モデルの能力も統一された制約の下で比較することができます。
しかし、ブラウンは同時に、異なる指標には限界があると指摘しています。
異なるモデルが使用するパーソナライザー、生成速度、単位の違いにより、トークンの数をモデル間で直接比較することはできない場合があります。トークンのコストも異なる可能性があります。コストはハードウェアの利用率、バッチ処理、エンジニアリングの実装によって影響を受けます。実行時間は完璧な指標ではないため、それもまた完璧な指標ではありません。「マルチエージェント協力」やbest-of-Nなどの待機技術を使用すると、複数の候補答えを並行して生成できるため、ユーザーが感じる待機時間は必ずしも大幅に増加しませんが、総計算量は大幅に増加することになります。
それにもかかわらず、彼は上記のいずれの指標も、推論の予算を超える単一のスコアよりも情報量が多いと考えています。
推論予算の問題は、人工知能のセキュリティ評価にまで拡大しています。
ブラウンの議論はモデルリストにとどまりません。彼は、推論予算も最先端モデルのセキュリティ管理に直接影響を与えると考えています。
先端的人工知能モデルを公開する前に、R&D機関は通常、サイバー攻撃、生物学的リスク、化学的リスクなどの潜在的な悪用可能性を評価します。モデルが一定のリスク閾値に達した場合、R&D機関は公開を延期するか、またはデプロイ前にアクセス制限や監視メカニズムなどの対策を追加する必要があるかもしれません。
問題は、モデルの能力が推論計算量の増加に伴って向上する場合、セキュリティ評価にはどれだけの推論予算を使用すべきかということです。
実際には、一般のユーザーはあるタスクに数ドルから数十ドルしか投資しないかもしれません。しかし、資金に余裕のある組織や専門チーム、あるいは国家行為者は、一般のユーザーよりもはるかに多くのリソースを単一の目標に投じることを選ぶかもしれません。評価機関が低予算でモデルをテストする場合、高リソース環境下でのそのモデルのリスク耐性を過小評価する可能性があります。
ブラウンは、Gemini 3 Deep Thinkのリリース後に起きた論争を例に挙げています。彼は、Deep Thinkのベンチマークテスト結果が以前のモデルよりも明らかに高かったにもかかわらず、リリース時にはそのバージョンのリスク管理能力を満たすための完全なシステムカードが提供されなかったと指摘しています。このような対応は、一部の人工知能セキュリティ研究者から批判を受けました。
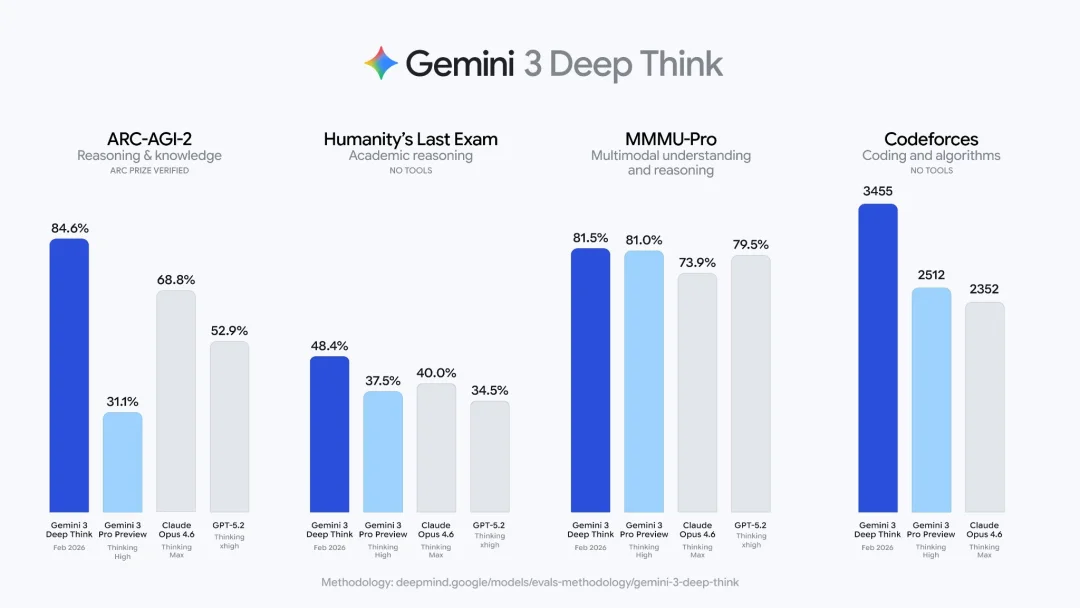
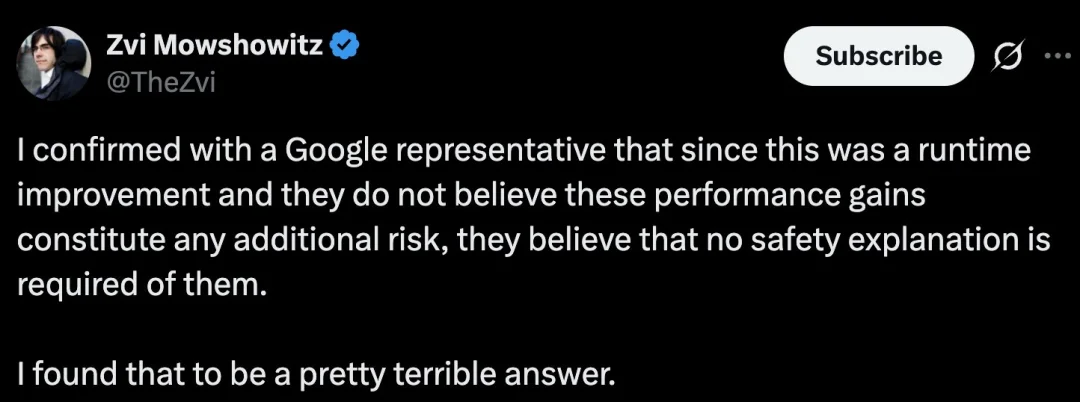
しかし、ブラウンの論争の背後には、より深刻な問題があるようです。人工知能企業とセキュリティ機関は、さまざまな推論予算の下でのモデルの能力を評価するための安定した方法をまだ確立していません。
彼は推測していますが、Deep Thinkは完全に独立して訓練された新しいモデルではなく、他の既存のモデルを基にした推論用のフレームワークシステムである可能性があります。このシステムは、モデルを複数回呼び出し、並行して候補結果を生成し、自動的に答えをチェックし、反復して修正することで、複雑なタスクのパフォーマンスを向上させることができます。
もしこの判断が正しいならば、Deep Think理論的には、プラットフォーム自体が示されている機能を実現するだけでなく、外部の開発者も十分な推論コストを投じる意思があれば、複数のモデルを組み合わせて同様のワークフローを構築することができます。Deep Thinkの役割は、専門的な開発能力が必要な複雑な推論プロセスを、一般ユーザーでも簡単に利用できる製品形態にパッケージ化することにあります。
したがって、Brownたちは、本当に注目すべき問題は製品がシステムカードを単独でリリースしたかどうかではなく、研究開発機関が異なる推論予算やフレームワーク戦略の下で、基本モデルが初めてリリースされた時に達成可能だった能力レベルを十分にテストしたかどうかだと考えています。
高予算の評価を全面的に実施するのは難しいですが、外挿を試みることはできます。
理論的には、リソースに余裕のあるエンティティは、単一のタスクに1000万ドルもの推論コストを投じることができるでしょう。しかし、セキュリティ評価には通常、数千回から数百万回ものテストが必要です。もし各操作に非常に高額な予算を費やすならば、評価コストはすぐに実行不可能になってしまいます。
ブラウンは、まず比較的コントロール可能な推論予算の範囲内でテストを行い、その後、モデルの能力が計算量の変化に応じてどのように変化するかに基づいて、より高い予算条件でのパフォーマンスを追求することを提案しています。また、評価機関は予測範囲と不確実性を明確に示すべきであり、計算結果を確定的な結論と見なすべきではありません。
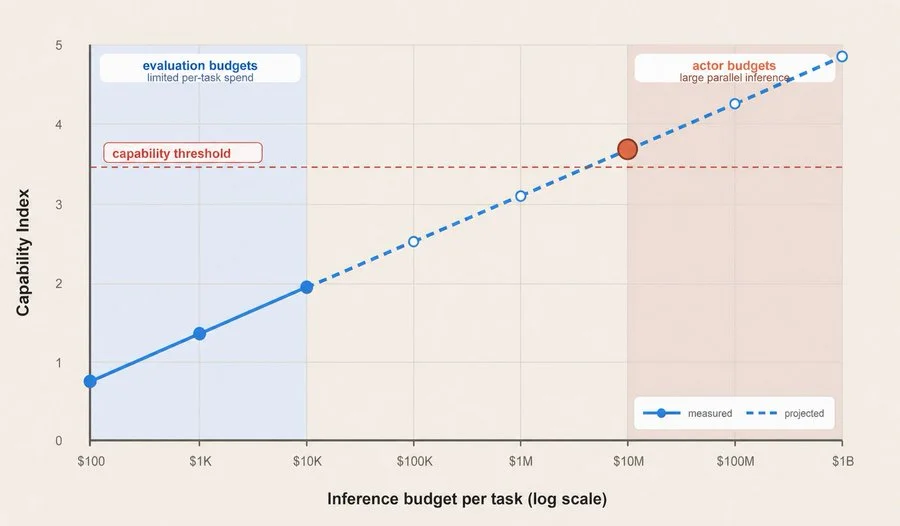
この方法は、局所的なデータを用いてより大規模なシステムの変化傾向を推定するものに似ています。実際のテストに取って代わるものではありませんが、モデルにより多くの時間、ツール、計算リソースが与えられた場合にリスクの範囲がどのように変化するかを、研究開発機関や規制機関が理解するのに役立ちます。
しかし、ブラウンは長期にわたるタスクが、短期間の実験では解決できない問題を引き起こす可能性があることも認めています。
例えば、研究者が独立した知能主体が1年間継続して動作した後に目標からの偏差、戦略的な欺瞞、またはその他の不一致した行動が発生するかどうかを判断したい場合、最も信頼できる方法はやはりその知能主体を実際に十分な期間動作させることかもしれません。数時間や数日間の実験結果だけでは、長期的な行動における重要な変化を捉えることはできないかもしれません。
これにより、新たな矛盾が生じます。人工知能(AI)モデルの開発からリリースまでのサイクルは数ヶ月しかかからないかもしれませんが、インテリジェントな身体が継続的に動作できるタスクのサイクルはますます長くなるでしょう。将来的には、研究開発機関は特別な状況に直面するかもしれません。つまり、次世代のモデルがその最大運用サイクルに達する前に、すでにリリースに近づいているという状況です。
三つの提案:推論予算をモデル評価の基本変数とする
能力評価とセキュリティガバナンスにおける上述の問題に対して、Brownは3つの具体的な提案を行っています。
まず、人工知能の研究開発機関は新しいモデルを発表する際に、異なる推論予算の条件下でのベンチマークテストの性能を公開すべきです。理想的には、企業はトークン数、コスト、または実行時間を横軸にした性能曲線を提供すべきです。少なくとも、企業は単一の結果を実現するために実際にどれだけの推論リソースが使用されたかを説明する必要があります。
第二に、ベンチマークテストのランキングでは推論リソースの消費を記録するべきであり、参照モデルに統一されたトークン、コスト、または時間制限を設定する必要があります。現在、いくつかの評価では関連する変数が考慮されていますが、この業界ではまだ標準的な慣行が確立されていません。
第三に、人工知能企業の準備体制(Preparedness Framework)および責任ある拡大政策(Responsible Scaling Policy、RSP)の推論段階における計算リソースについては、明確に考慮する必要があります。機関がモデルが特定のセキュリティ閾値を超えているかどうかを判断する際には、単一の設定でのパフォーマンスだけでなく、複数の推論予算レベルを評価し、より高い予算条件下でのリスク耐性についての不確実性を予測する必要があります。
この業界はすでにこの問題に気づいていますが、評価システムはまだ完全には対応していません。
推論段階で計算リソースを増やすことでモデルの性能を向上させることができるというのは、新しい発見ではありません。
OpenAIが2024年9月にo1という推論モデルを発表して以来、業界ではこのモデルが質問に答える際により多くの推論ステップを踏むようになり、数学、コード、複雑な分析タスクでより良い結果を出せると一般に認識されています。また、「計算テスト時の拡張性」や「計算推論時の拡張性」に関する研究も、大規模モデルの発展における重要な方向性として徐々に注目されるようになっています。
しかし、ブラウンによると、この傾向が現れてから約2年が経過した今でも、多くの先端モデルの発表は依然として単一のベンチマークスコアに基づいて広まり、比較されています。一部のセキュリティ機関では、数十倍、あるいは数百倍の推論コストをかけてスキルフレームワークシステムを使用することで、モデルの能力の限界を再評価することができます。
モデルが長期にわたる実行、複数回の試行錯誤、大規模な推論リソースの使用にますます長けてくるにつれて、従来のリストの解釈能力はさらに低下する可能性があります。低予算のQ&Aシステム、高予算の深層研究、複数のエージェントによる協力、自動化ツールの呼び出しなど、さまざまな条件下で、同じ基本モデルがまったく異なる能力を発揮することがあります。
ブラウンは次のように判断しています。将来的に人工知能の能力を測定する際には、推論の予算はテストプロセスの補助情報としてではなく、評価レポートの中核的なパラメータとして扱われるべきだと。例えば、モデルの規模、トレーニングデータ、コンテキストウィンドウなどと同様にです。
より広い観点から見ると、これはまた、人工知能産業が「一つの数字でモデルを定義する」という段階を徐々に脱していることを意味しています。能力評価、製品比較、セキュリティ管理において、本当に重要なのはモデルが何ができるかだけでなく、十分な時間、資金、計算リソースを与えられたときに何ができるかかもしれません。
参考リンク:https://x.com/polynoamial/status/2064210146558136827
著者は「Machine Heart」の「Machine Heart編集部」からです。
役に立ちましたか?