Noam Brown, scientifique d'OpenAI : la véritable limite supérieure de l'IA, personne ne peut se permettre de la mesurer
Alors que les grands modèles linguistiques commencent à être utilisés pour des tâches complexes telles que la raisonnement, la recherche automatisée et la sécurité des réseaux, les méthodes traditionnelles d'évaluation des modèles font face à de nouveaux défis.
Depuis longtemps, la publication de modèles est accompagnée d'une table de résultats composée de divers tests de benchmark, incluant des tests en mathématiques, en programmation, en questions scientifiques, en sécurité informatique et en raisonnement cognitif, et ces résultats sont comparés horizontalement avec ceux de la génération précédente de modèles.
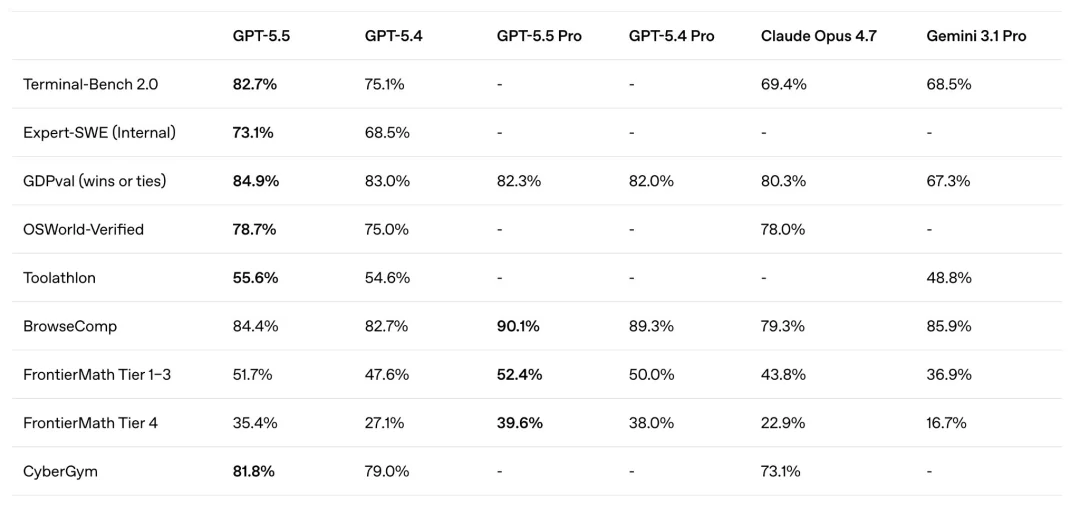
Le chercheur d’OpenAI, Noam Brown, a récemment souligné dans cet article que lorsque les modèles utilisent davantage d’étapes de raisonnement, appellent plus d’outils ou effectuent des recherches et des tests plus longs pour répondre aux questions, il devient de plus en plus difficile pour une seule note de refléter avec précision la véritable capacité du modèle.
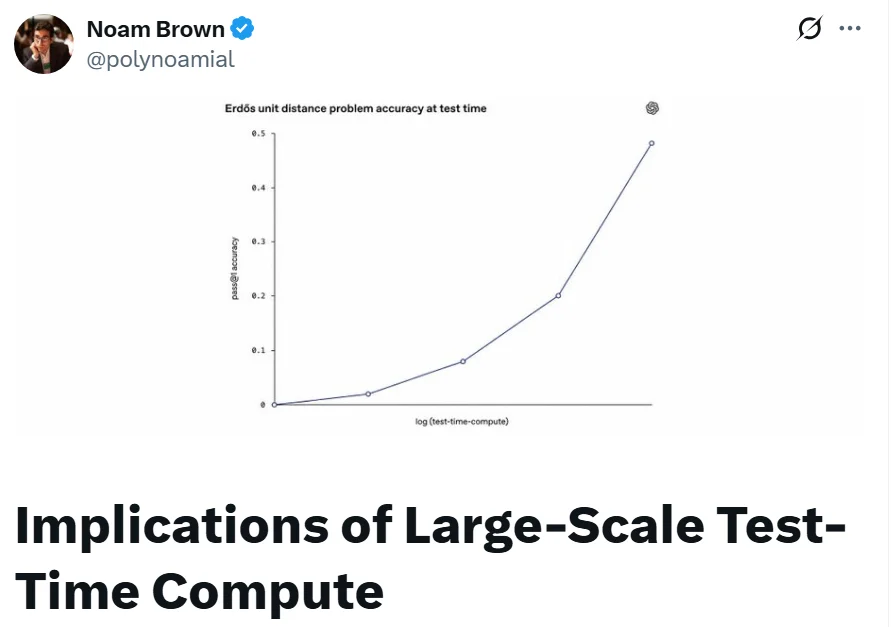
Les points de vue clés de Brown sont les suivants :La performance des grands modèles dépend non seulement du modèle lui-même, mais aussi des ressources de calcul dont il dispose pendant la phase d'inférence.Lors de l'évaluation des modèles à l'avenir, nous ne devrions pas nous demander seulement « Quel score a obtenu le modèle ? », mais aussi répondre à une autre question : Combien de tokens a consommé le modèle, et à quel coût et sur combien de temps d'exécution a-t-il atteint ce résultat ?
Il suggère que l'industrie devrait passer d'une approche axée sur les « performances individuelles » à une approche centrée sur la « courbe de calcul de la capacité de raisonnement », et considérer le budget alloué à la raisonnement comme un élément essentiel pour évaluer les capacités des modèles et comme une variable fondamentale dans les politiques de sécurité de l'intelligence artificielle.
Les anciens rapports de résultats pourraient sous-estimer l'écart de performance des nouveaux modèles.
Brown utilise la réaction du marché après la publication, illustrée par GPT-5.5, pour montrer les limites des classements basés sur des modèles traditionnels.
Selon sa description,GPT-5.5Au début de la publication, ce qui a attiré l'attention du public étaient d'abord un ensemble de résultats de tests de performance qui n'étaient pas particulièrement remarquables.GPT-5.4En comparaison, les scores du nouveau modèle ont augmenté, mais selon les tableaux de scores traditionnels, l'amélioration semble limitée. Par conséquent, certains utilisateurs adoptent une attitude d'attente ou même de scepticisme envers la nouvelle version.
Cependant, dans les heures qui ont suivi la mise à disposition du modèle, certains utilisateurs ont constaté que, à mesure que les développeurs et les chercheurs commençaient à tester des tâches plus complexes, GPT-5.5 présentait des différences significatives entre les générations en termes de capacité à effectuer des raisonnements de longue chaîne, d'exécution continue et de traitement de problèmes complexes. Brown estime que ce phénomène, où l'« expérience pratique s'améliore de manière significative, mais les scores sur la liste restent peu changés », reflète le fait que les méthodes d'évaluation traditionnelles ne capturent pas pleinement les capacités du modèle.
Le problème est que les résultats d'évaluation de différents modèles ne sont pas nécessairement basés sur le même budget de raisonnement.
Dans les cadres d'évaluation traditionnels, les chercheurs choisissent souvent une configuration d'essai pour chaque modèle afin d'améliorer les résultats autant que possible, puis ils plaçent les scores finaux dans le même tableau. Cela semble équitable, mais cela peut masquer une variable clé : certains modèles peuvent continuer à améliorer considérablement leurs performances en obtenant plus de tokens de raisonnement, plus d'appels ou en fonctionnant pendant plus de temps ; d'autres modèles peuvent atteindre leur plafond de performance plus tôt.
Les cas d'évaluation de la sécurité réseau présentés par Brown montrent que si l'on compare simplement chaque modèle en fonction du résultat final sous la condition de « calculer la quantité maximale pendant le test », l'avantage de GPT-5.5 par rapport à GPT-5.4 pourrait ne pas être évident. Cependant, si l'on parvient à maintenir le nombre de tokens, le coût de raisonnement ou le temps de réponse à un même niveau, et que l'on observe ensuite les performances des différents modèles, l'amélioration des capacités de GPT-5.5 deviendra plus significative.
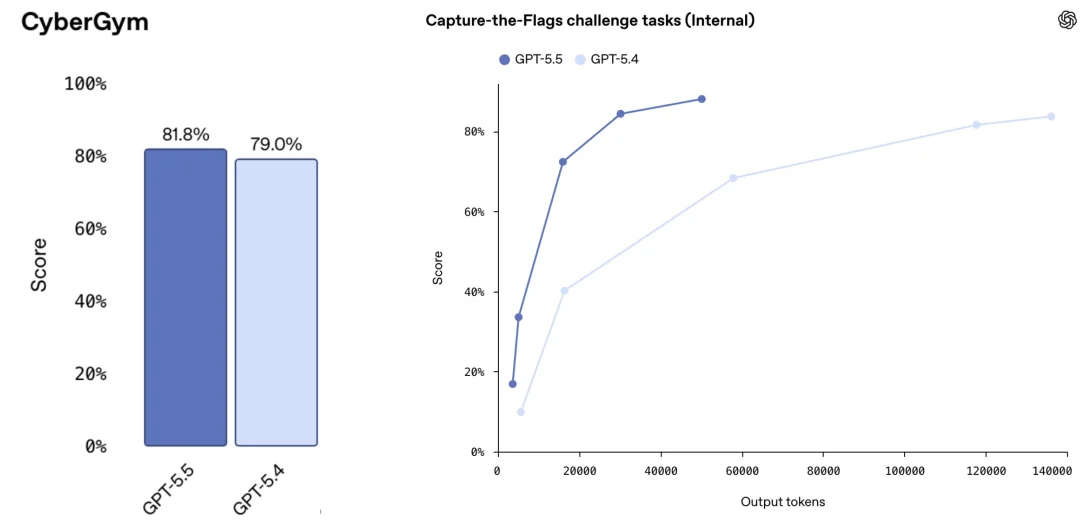
En d'autres termes, les différences entre les modèles ne se reflètent pas seulement dans les scores finaux, mais aussi dans l'efficacité avec laquelle ils utilisent les ressources de calcul supplémentaires pour l'inférence.
Pourquoi ne pas simplifier les choses ? « Continuer à faire des efforts jusqu'à ce que les performances ne s'améliorent plus »
La solution intuitive consiste à continuer d'augmenter les ressources de raisonnement pour chaque modèle jusqu'à ce que leurs performances atteignent un niveau stable, puis à comparer leurs capacités maximales.
Brown pense que cette idée pourrait être irréalisable dans la pratique. La raison en est que, pour la nouvelle génération de modèles, la période de plateau en termes de performances pourrait être beaucoup plus longue que prévu, et pourrait même être difficile à observer même dans le cadre d'un budget réellement supportable.
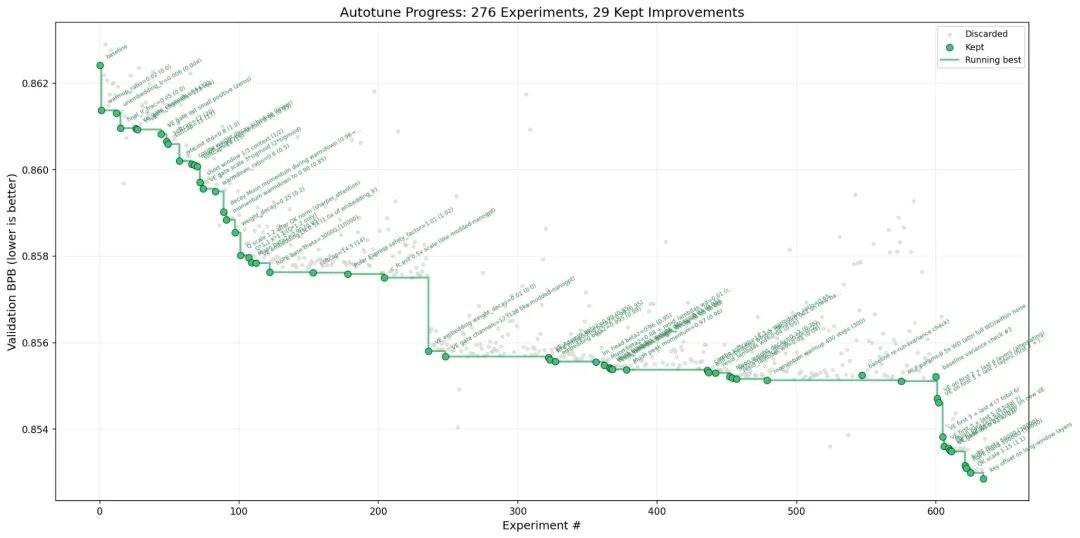
Il a cité comme exemple l'expérience de recherche sur l'automatisation initiée par Andrej Karpathy. Dans ces expériences, même après de nombreux essais supplémentaires, les performances du modèle continuaient d'améliorer. Même après des centaines d'essais, la courbe d'amélioration n'était pas complètement plate.
Brown a également mentionné les résultats de l'évaluation de la sécurité réseau de l'Institut britannique de la sécurité de l'intelligence artificielle (AI Security Institute). Dans cette évaluation, certains modèles, y compris Mythos et GPT-5.5, ont continué à améliorer leurs performances après avoir utilisé un total de plus de 100 millions de tokens.
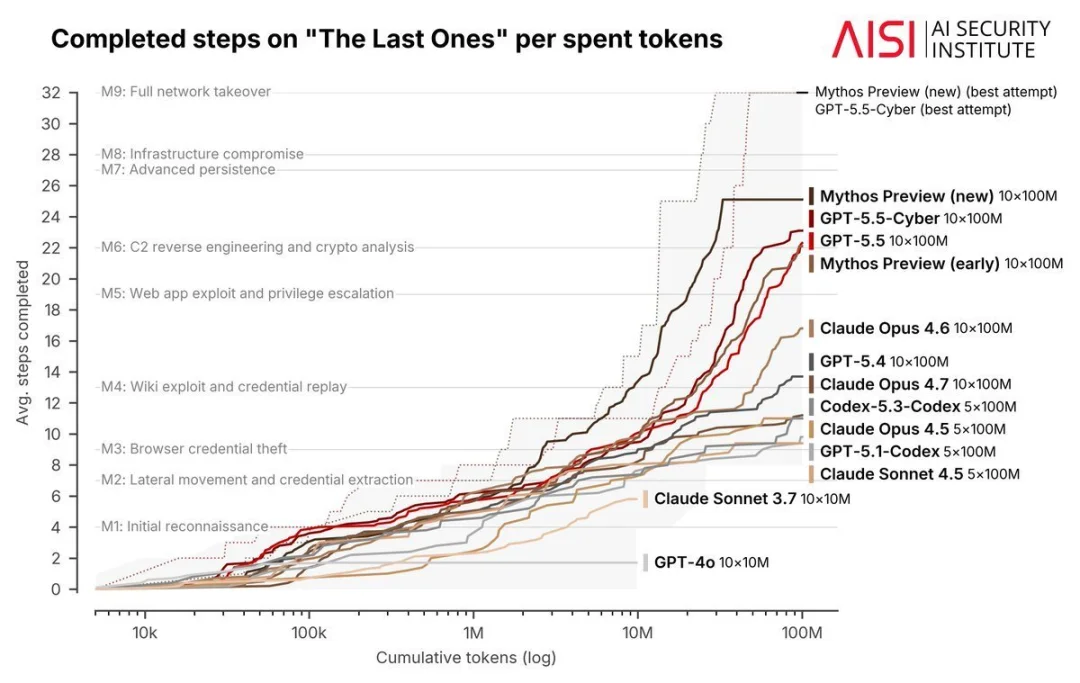
Cela signifie que les modèles peuvent utiliser des temps d'exécution de plus en plus longs et des budgets de raisonnement plus importants pour explorer, essayer et corriger des stratégies dans des tâches complexes. Les modèles plus puissants disposent non seulement d'un point de départ plus élevé, mais sont également susceptibles d'être plus capables de transformer des ressources de calcul supplémentaires en capacités efficaces.
Selon Brown, on peut supposer que, avec l'amélioration des capacités des modèles, la durée de leurs performances efficaces augmentera également. Par le passé, on pouvait observer une stabilisation des performances des modèles dans le cadre de budgets relativement limités ; à l'avenir, ces limites de performance pourraient être déplacées vers des niveaux plus élevés. Dans certains cas, ce qu'on appelle la « période de plateau » pourrait même cesser d'être un état facile à mesurer.
Passer d'une simple note de score à une « courbe performance-coût »
Face à ce changement, Brown suggère que les organismes responsables de la publication des modèles modifient la manière dont les tests de référence sont présentés.
Plutôt que de ne publier qu'un score final, il serait préférable d'indiquer la quantité de calculs de raisonnement sur l'axe horizontal et de montrer la performance de la tâche sur l'axe vertical, en traçant une courbe complète de changement de performance. L'axe horizontal pourrait utiliser des indicateurs tels que le nombre de tokens, le coût de raisonnement ou le temps d'exécution réel.
Cette méthode peut répondre à des questions difficiles à expliquer dans les tableaux de résultats traditionnels. Par exemple, avec le même budget, quel modèle se comporte le mieux ? Quel modèle s'améliore le plus lorsque le budget est multiplié par dix ? Les modèles sont-ils proches de leur plafond de performance ? Comment varie le rapport coût-efficacité des différents modèles ?
Des méthodes similaires ont déjà été mises en œuvre dans certains tests de référence. Brown mentionne que l'évaluation ARC-AGI vise à mesurer la relation entre les scores des modèles et les coûts de fonctionnement, et non simplement à publier un score unique.
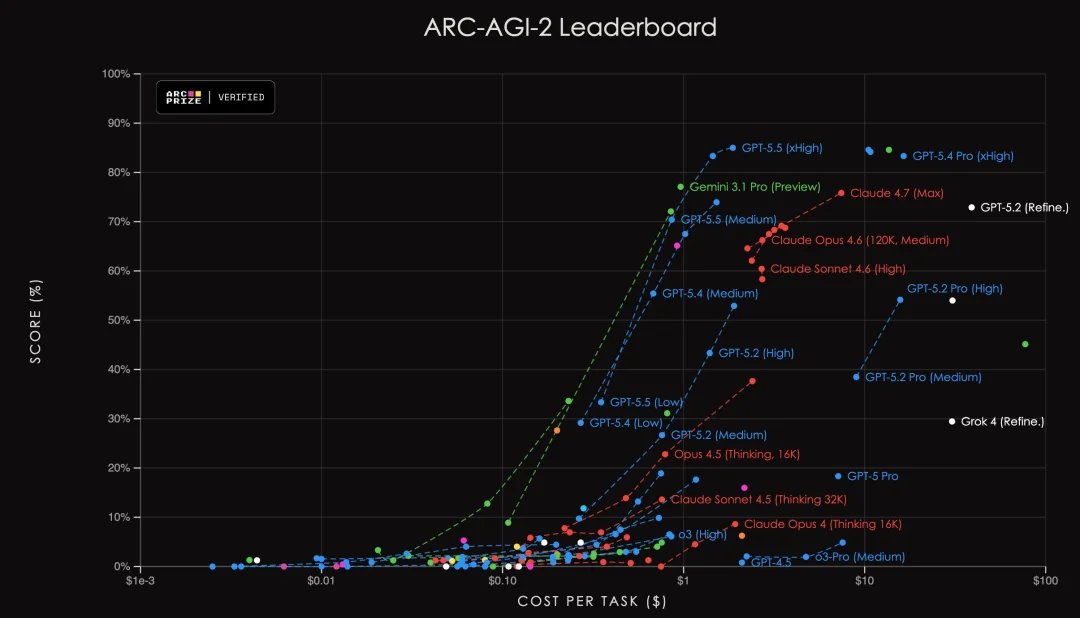
Une autre solution viable consiste à établir des tokens de planification clairs, des limites de coût ou de temps pour l'évaluation, et à informer à l'avance le modèle des informations budgétaires. Cette approche est similaire à celle des humains qui passent des examens standardisés : que ce soit le test d'admission aux universités américaines SAT ou les compétitions internationales de mathématiques olympiques, les participants doivent accomplir les tâches dans un délai fixe. Les capacités des modèles peuvent également être comparées dans le cadre de contraintes unifiées.
Cependant, Brown a également souligné que les différents indicateurs sont limités.
Les nombres peuvent ne pas pouvoir être comparés directement entre différents modèles en raison des différences de segmentation des mots, des vitesses de génération et des unités utilisées par ces modèles. Les coûts peuvent également varier. Les coûts dépendent de l'utilisation de l'équipement, du traitement en lot et de la réalisation technique. Comme le temps d'exécution n'est pas un indicateur parfait, il ne constitue pas non plus un critère fiable. Les techniques de coopération entre plusieurs agents intelligents ou de sélection du meilleur des N (best-of-N) permettent de générer plusieurs réponses candidates en parallèle, ce qui n'augmente pas nécessairement de manière significative le temps d'attente perçu par l'utilisateur, tout en augmentant considérablement la quantité totale de calculs.
Néanmoins, il estime que n'importe lequel des indicateurs mentionnés ci-dessus contient plus d'informations qu'un simple score dépassant le budget de raisonnement.
Les problèmes de budgetation en matière de raisonnement s'étendent maintenant à l'évaluation de la sécurité de l'intelligence artificielle.
La discussion de Brown ne se limite pas à la liste des modèles. Il estime que le budget alloué à la推理 (l'inférence) a également un impact direct sur la sécurité des modèles de pointe.
Avant de publier de nouveaux modèles d'intelligence artificielle de pointe, les institutions de recherche et développement (R&D) évaluent généralement les risques potentiels de détournement, tels que les attaques informatiques, les risques biologiques et les risques chimiques. Si le modèle dépasse certains seuils de risque, ces institutions peuvent décider de différer sa publication ou d'ajouter des mesures de mitigation, comme des restrictions d'accès et des mécanismes de surveillance, avant son déploiement.
La question est la suivante : si la capacité du modèle s'améliore avec l'augmentation de la quantité de calculs de raisonnement, quelle part du budget de raisonnement devrait être utilisée pour l'évaluation de la sécurité ?
En fait, les utilisateurs ordinaires ne dépenseront probablement que quelques dollars ou quelques dizaines de dollars pour une tâche. Cependant, une organisation bien financée, une équipe professionnelle ou un acteur national pourrait être prêt à investir bien plus de ressources que les utilisateurs ordinaires pour atteindre un objectif unique. Si les organismes d'évaluation testent les modèles avec un budget limité, ils pourraient sous-estimer leur capacité à gérer les risques dans des conditions de ressources plus abondantes.
Brown prend l'exemple des controverses qui ont suivi la publication de Gemini 3 Deep Think. Il souligne que les résultats des tests de base de Deep Think étaient nettement supérieurs à ceux des modèles précédents, mais que le système complet n'a pas été fourni en même temps que la version, ce qui n'a pas permis d'évaluer pleinement les capacités de cette dernière en termes de risque. Cette approche a suscité les critiques de certains chercheurs en sécurité de l'intelligence artificielle.
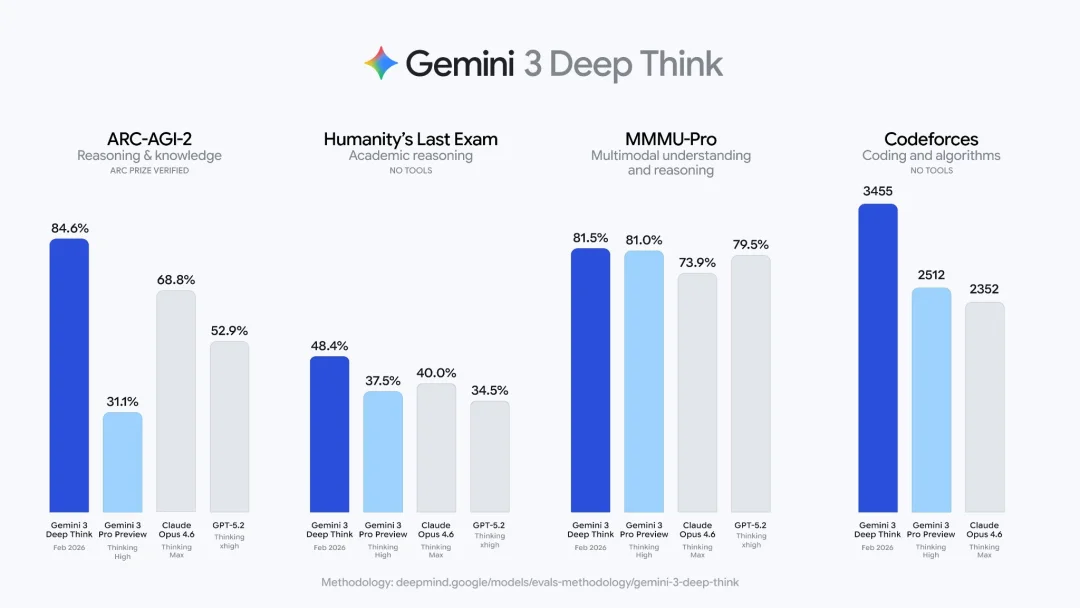
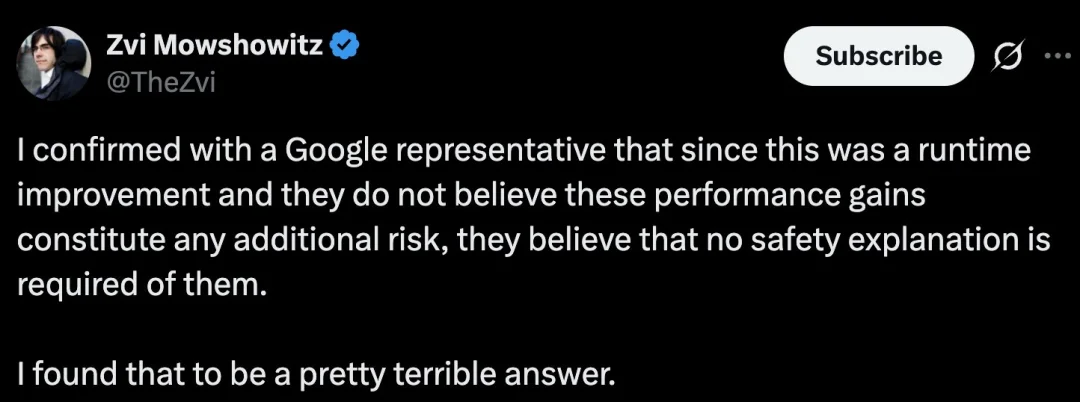
Cependant, il semble qu'il y ait un problème plus profond derrière la controverse Brown : les entreprises de l'intelligence artificielle et les organismes de sécurité n'ont pas encore développé de méthode fiable pour évaluer les capacités des modèles en fonction de différents budgets de raisonnement.
Il suppose que Deep Think ne serait peut-être pas un nouveau modèle entièrement entraîné de manière indépendante, mais plutôt un système de cadre de raisonnement basé sur d'autres modèles existants. Ce système pourrait améliorer les performances sur des tâches complexes en appelant le modèle plusieurs fois, en générant des résultats candidats en parallèle, en vérifiant automatiquement les réponses et en corrigeant itérativement les erreurs.
Si ce jugement est correct, alors, en théorie, Deep Think pourrait non seulement réaliser les capacités présentées par la plateforme elle-même, mais les développeurs externes pourraient également construire des flux de travail similaires en combinant plusieurs modèles, à condition qu'ils soient prêts à investir suffisamment de ressources en raisonnement. Le rôle principal de Deep Think est de transformer des processus de raisonnement complexes qui nécessitent des compétences de développement professionnelles en produits faciles à utiliser pour les utilisateurs ordinaires.
Par conséquent, selon Brown et les autres, la question vraiment importante n’est pas de savoir si le système a été lancé séparément, mais de savoir si les instituts de recherche et développement ont suffisamment testé le niveau de performance que le modèle de base pouvait atteindre lors de sa première publication, en fonction des différents budgets alloués à la recherche et des stratégies utilisées.
L'évaluation d'un budget élevé est difficile à mettre en œuvre de manière complète, mais on peut essayer de faire des extrapolations.
Théoriquement, un agent disposant de ressources abondantes pourrait investir des coûts de raisonnement de plusieurs millions de dollars pour une seule tâche. Cependant, l'évaluation de la sécurité implique généralement des milliers, voire des millions, de tests. Si un budget très élevé est alloué à chaque opération, les coûts d'évaluation deviendraient rapidement irréalisables.
Brown propose de commencer par effectuer des tests dans le cadre d'un budget de raisonnement relativement contrôlable, puis d'améliorer les performances dans des conditions de budget plus élevées en fonction de la tendance des capacités du modèle à évoluer avec la quantité de calculs. De plus, les organismes d'évaluation devraient clairement indiquer les limites des prédictions et les incertitudes, plutôt que de considérer les résultats des calculs comme des conclusions définitives.
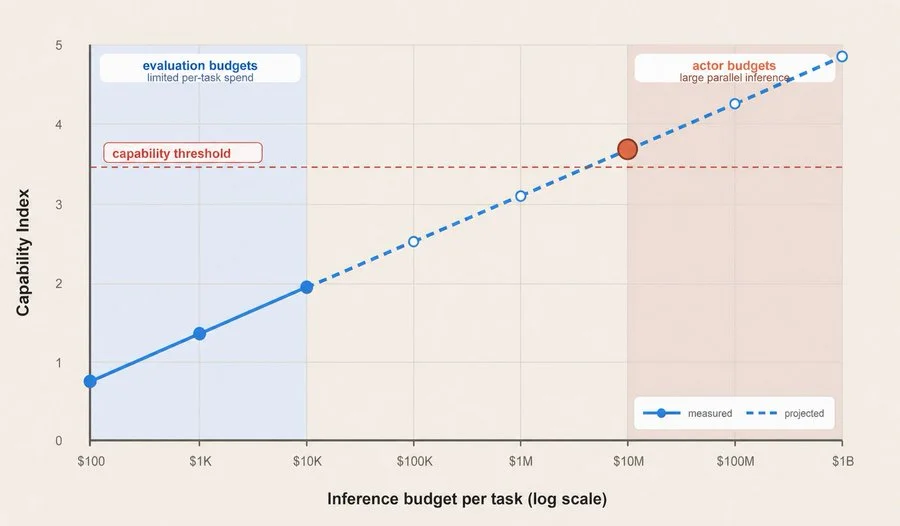
Cette méthode est similaire à l'estimation des tendances de changement dans des systèmes de plus grande échelle à partir de données locales. Elle ne peut pas remplacer les tests réels, mais elle peut aider les organismes de recherche et développement ainsi que les autorités de régulation à comprendre comment les limites des risques pourraient évoluer lorsque les modèles disposent de plus de temps, d'outils et de ressources de calcul.
Cependant, Brown reconnaît également que les tâches à long terme peuvent soulever des problèmes qui sont difficiles à résoudre avec des expériences à court terme.
Par exemple, si les chercheurs veulent déterminer si un agent intelligent indépendant présentera des écarts par rapport à l'objectif, de la tromperie stratégique ou d'autres comportements inappropriés après avoir fonctionné de manière continue pendant un an, la méthode la plus fiable reste probablement de laisser l'agent intelligent fonctionner pendant une période suffisamment longue. Se baser uniquement sur les résultats d'expériences de quelques heures ou de quelques jours ne permet pas de détecter les changements clés dans son comportement à long terme.
Cela créera un nouveau paradoxe dans la réalité : le cycle de développement et de lancement des modèles d'intelligence artificielle pourrait ne durer que quelques mois, tandis que le cycle de fonctionnement des corps intelligents pourrait devenir de plus en plus long. À l'avenir, les instituts de recherche et développement pourraient faire face à une situation particulière : la prochaine génération de modèles pourrait être sur le point de être lancée avant même d'avoir atteint son cycle de fonctionnement maximal.
Trois suggestions : faire du budget de raisonnement une variable de base pour l'évaluation des modèles
Face aux problèmes mentionnés dans l'évaluation des compétences et la gouvernance de la sécurité, Brown propose trois suggestions concrètes.
Tout d'abord, lors de la publication de nouveaux modèles, les institutions de recherche et développement en intelligence artificielle devraient présenter les performances des tests de référence sous différentes conditions de budget de raisonnement. Dans l'idéal, les entreprises devraient fournir des courbes de performance avec le nombre de tokens, le coût ou le temps d'exécution en abscisse. Au minimum, les entreprises doivent expliquer combien de ressources de raisonnement ont été réellement utilisées pour obtenir un résultat particulier.
Deuxièmement, les classements des tests de référence devraient enregistrer la consommation des ressources de raisonnement, ou imposer des limites uniformes en termes de tokens, de coûts ou de temps pour les modèles de référence. Actuellement, certaines évaluations ont déjà pris en compte ces variables, mais l'industrie n'a pas encore établi de pratiques standard.
Troisièmement, les ressources de calcul nécessaires pour la phase de raisonnement du cadre de préparation des entreprises de l'intelligence artificielle (Preparedness Framework) et de la politique de croissance responsable (Responsible Scaling Policy, RSP) doivent être clairement prises en compte. Lorsque les institutions évaluent si un modèle dépasse un certain seuil de sécurité, il est nécessaire de vérifier non seulement les performances dans une seule configuration, mais aussi d'évaluer plusieurs niveaux de budget de raisonnement, afin de prédire avec incertitude la capacité à gérer les risques dans des conditions de budget plus élevées.
L'industrie est déjà consciente de ce problème, mais le système d'évaluation n'a pas encore complètement suivi le rythme.
L'ajout de ressources de calcul pendant la phase de raisonnement peut améliorer les performances du modèle, et ce n'est pas une découverte nouvelle.
Depuis que OpenAI a lancé le modèle de raisonnement o1 en septembre 2024, l'industrie est généralement convaincue que ce modèle effectue un plus grand nombre d'étapes de raisonnement lorsqu'il répond aux questions, ce qui lui permet d'obtenir de meilleurs résultats dans les domaines des mathématiques, du code et des tâches d'analyse complexes. Les recherches sur l'« étendabilité lors des tests de calcul » ou l'« étendabilité du raisonnement calculatoire » sont également devenues une direction importante dans le développement des grands modèles.
Cependant, selon Brown, près de deux ans après l’apparition de cette tendance, la publication de nombreux modèles avancés repose encore principalement sur un seul score de référence pour leur diffusion et leur comparaison. Certaines agences de sécurité peuvent également reconsidérer les limites des capacités des modèles après avoir utilisé des budgets de raisonnement plusieurs dizaines ou même plusieurs centaines de fois supérieurs à ceux habituels dans leurs systèmes d’infrastructure.
À mesure que les modèles deviennent de plus en plus capables d'utiliser des processus de longue durée, des itérations d'essai-erreur et des ressources de raisonnement à grande échelle, l'efficacité de l'interprétation des listes traditionnelles pourrait continuer à diminuer. Dans des contextes variés tels que les questions-réponses à faible budget, les recherches approfondies à haut budget, la collaboration entre plusieurs intelligences artificielles et les appels d'outils automatisés, le même modèle de base peut présenter des niveaux de performance complètement différents.
Brown estime que, à l'avenir, lors de la mesure des capacités de l'intelligence artificielle, le budget de raisonnement ne devrait plus être considéré comme une information supplémentaire au cours du processus de test, mais devrait devenir un paramètre central dans les rapports d'évaluation, tout comme la taille du modèle, les données d'entraînement et la fenêtre de contexte.
D'un point de vue plus large, cela signifie également que l'industrie de l'intelligence artificielle est en train de quitter progressivement la phase où un modèle est défini par un seul chiffre. Pour l'évaluation des capacités, la comparaison des produits et la sécurité, les questions vraiment importantes ne sont peut-être pas seulement ce que le modèle peut faire, mais plutôt ce qu'il peut faire lorsqu'il dispose de suffisamment de temps, de fonds et de ressources de calcul.
Référence de connexion : https://x.com/polynoamial/status/2064210146558136827
L'auteur est issu de "Heart of Machine" et du "Département de Rédaction de Heart of Machine".
Lien de l’article :https://airai.cc/fr/ai-news/10/
Cela vous a-t-il aidé ?