Nhà khoa học OpenAI Noam Brown: giới hạn thực sự của AI có thể không ai có thể đo lường được
Khi các mô hình ngôn ngữ lớn dần tham gia vào các nhiệm vụ phức tạp như suy luận, nghiên cứu tự động hóa và bảo mật mạng, các phương pháp đánh giá mô hình truyền thống đang đối mặt với những thách thức mới.
Trong quá khứ, việc phát hành một mô hình thường đi kèm với bảng kết quả bao gồm nhiều bài kiểm thử chuẩn như toán học, lập trình, trả lời câu hỏi khoa học, bảo mật mạng, suy luận kiến thức, v.v., và so sánh mức độ hiệu quả của mô hình đó với thế hệ trước.
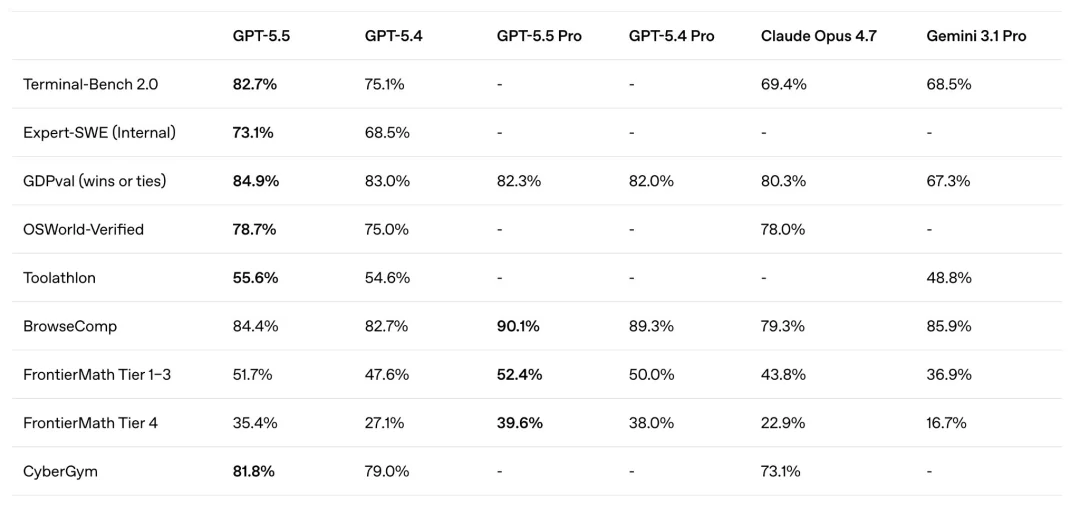
Nhà nghiên cứu tại OpenAI, Noam Brown, gần đây đã chỉ ra trong một bài viết rằng khi các mô hình sử dụng nhiều bước suy luận hơn, gọi nhiều công cụ hơn hoặc thực hiện các cuộc tìm kiếm và kiểm thử kéo dài hơn khi trả lời câu hỏi, điểm số đơn lẻ ngày càng khó phản ánh chính xác khả năng thực sự của mô hình đó.
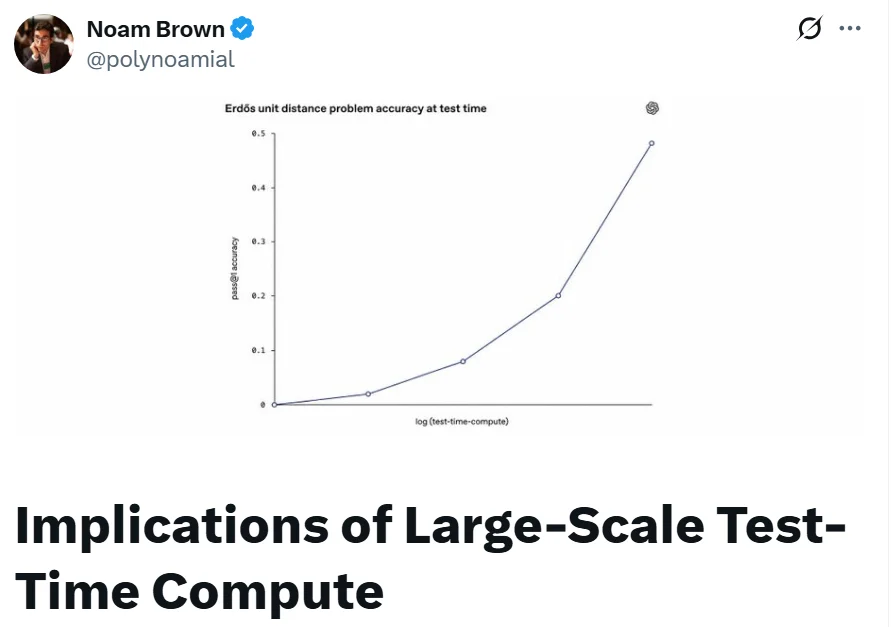
Quan điểm chính của Brown là:Hiệu suất của các mô hình lớn không chỉ phụ thuộc vào bản thân mô hình, mà còn phụ thuộc vào lượng tài nguyên tính toán mà mô hình nhận được trong quá trình suy luận.Khi đánh giá các mô hình trong tương lai, chúng ta không thể chỉ hỏi “Mô hình đạt được điểm số bao nhiêu?”, mà còn cần trả lời một câu hỏi khác: Mô hình đã tiêu tốn bao nhiêu token, và với chi phí cũng như thời gian chạy như thế nào, nó mới đạt được kết quả đó?
Ông đề nghị ngành công nghiệp nên chuyển từ việc đánh giá dựa trên “điểm số đơn lẻ” sang việc đánh giá “hiệu suất theo đường cong lượng tính toán suy luận”, và coi ngân sách dành cho việc suy luận là một biến số cơ bản trong việc đánh giá năng lực của mô hình trong chính sách an ninh trí tuệ nhân tạo.
Bảng xếp hạng truyền thống có thể đánh giá thấp sự chênh lệch về năng lực giữa các mô hình mới.
Brown đã sử dụng phản ứng thị trường sau khi công bố (được biểu thị bằng GPT-5.5) làm ví dụ để minh họa những hạn chế của hệ thống xếp hạng mô hình truyền thống.
Theo mô tả của anh ấy,GPT-5.5Ngay từ giai đoạn đầu tiên của việc phát hành, điều đầu tiên mà công chúng chú ý đến là một nhóm kết quả kiểm thử hiệu năng (benchmark test) không quá nổi bật.GPT-5.4So với mô hình cũ, điểm số của mô hình mới đã được cải thiện, nhưng theo bảng điểm truyền thống, mức độ cải thiện dường như khá hạn chế. Do đó, một số người dùng vẫn đang theo dõi hoặc thậm chí nghi ngờ về phiên bản mới này.
Tuy nhiên, trong vài giờ đầu tiên sau khi mô hình được công bố, một số người dùng nhận thấy rằng khi các nhà phát triển và nhà nghiên cứu bắt đầu thử nghiệm với những nhiệm vụ phức tạp hơn, GPT-5.5 thể hiện sự khác biệt rõ rệt giữa các thế hệ trong khả năng suy luận dài, thực hiện liên tục và xử lý các vấn đề phức tạp. Brown cho rằng hiện tượng này – trong đó “kinh nghiệm thực tế được cải thiện đáng kể, nhưng điểm số trong bảng xếp hạng chỉ thay đổi ít” – phản ánh việc các phương pháp đánh giá truyền thống không thể hiện đầy đủ khả năng của mô hình.
Vấn đề là, kết quả đánh giá của các mô hình khác nhau có thể không dựa trên cùng một ngân sách suy luận.
Trong các khung đánh giá truyền thống, các nhà nghiên cứu thường chọn một bộ cấu hình kiểm thử cho mỗi mô hình nhằm nâng cao kết quả tối đa có thể, sau đó đưa điểm số cuối cùng vào cùng một bảng. Cách làm này có vẻ công bằng, nhưng nó có thể che giấu một biến số quan trọng: một số mô hình có thể tiếp tục cải thiện đáng kể hiệu suất sau khi nhận được nhiều hơn các token suy luận, nhiều lần gọi hơn hoặc thời gian chạy dài hơn; trong khi những mô hình khác có thể đạt đến giới hạn hiệu suất sớm hơn.
Các trường hợp đánh giá bảo mật mạng được Brown trình bày cho thấy rằng, nếu chỉ so sánh các mô hình dựa trên kết quả cuối cùng ở điều kiện “tính toán lượng dữ liệu lớn nhất trong quá trình thử nghiệm”, thì lợi thế của GPT-5.5 so với GPT-5.4 có thể không rõ ràng. Tuy nhiên, nếu số lượng token, chi phí suy luận hoặc độ trễ được kiểm soát ở mức tương đương, và sau đó quan sát hiệu suất của các mô hình khác nhau, thì sự cải thiện về khả năng của GPT-5.5 sẽ trở nên rõ ràng hơn nhiều.
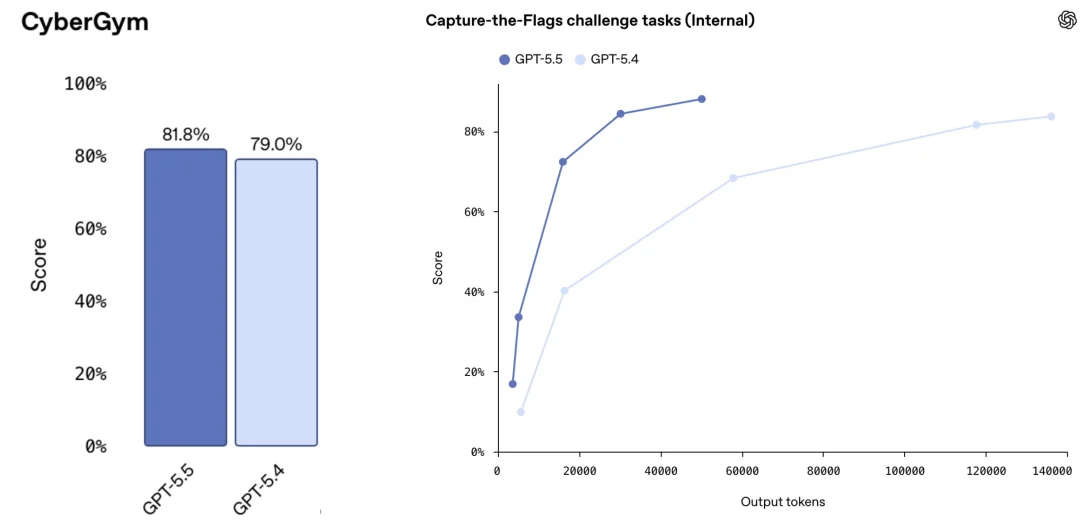
Nói cách khác, sự khác biệt giữa các mô hình không chỉ thể hiện ở điểm số cuối cùng mà còn ở hiệu quả sử dụng lượng dữ liệu suy luận bổ sung.
Tại sao không thể đơn giản hơn? “Tiếp tục tăng cường nguồn lực xử lý cho mỗi mô hình cho đến khi hiệu năng không còn được cải thiện nữa”
Giải pháp trực quan là tiếp tục bổ sung nguồn lực xử lý cho từng mô hình cho đến khi hiệu năng của chúng đạt đến một ngưỡng ổn định (giai đoạn “plateau”), sau đó so sánh khả năng tối đa của chúng.
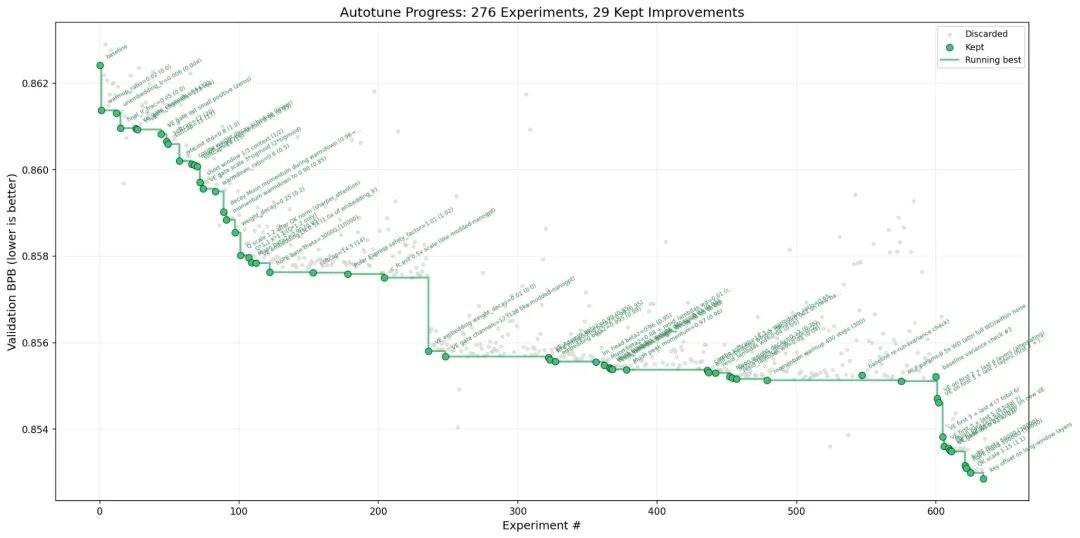
Tuy nhiên, Brown cho rằng ý tưởng này có thể không khả thi trong thực tế. Lý do là đối với các thế hệ mô hình mới, giai đoạn ổn định về hiệu năng có thể xuất hiện muộn hơn nhiều so với dự đoán, và thậm chí có thể khó được quan sát trong phạm vi ngân sách hợp lý.
Anh ấy đã trích dẫn một thí nghiệm nghiên cứu tự động do Andrej Karpathy khởi xướng làm ví dụ. Trong thí nghiệm đó, mô hình tiếp tục thực hiện nhiều lần thử nghiệm, và hiệu suất vẫn duy trì xu hướng cải thiện. Ngay cả sau hàng trăm lần thử nghiệm, đường cong cải thiện vẫn không hề giảm dần.
Brown đồng thời, Viện An ninh Trí tuệ nhân tạo của Vương quốc Anh (AI Security Institute) cũng đã đưa ra kết quả đánh giá về an ninh mạng. Trong đánh giá này, bao gồm cả các mô hình như Mythos và GPT-5.5, sau khi sử dụng tổng cộng hơn 100 triệu token, hiệu suất thực hiện nhiệm vụ tiếp tục được cải thiện.
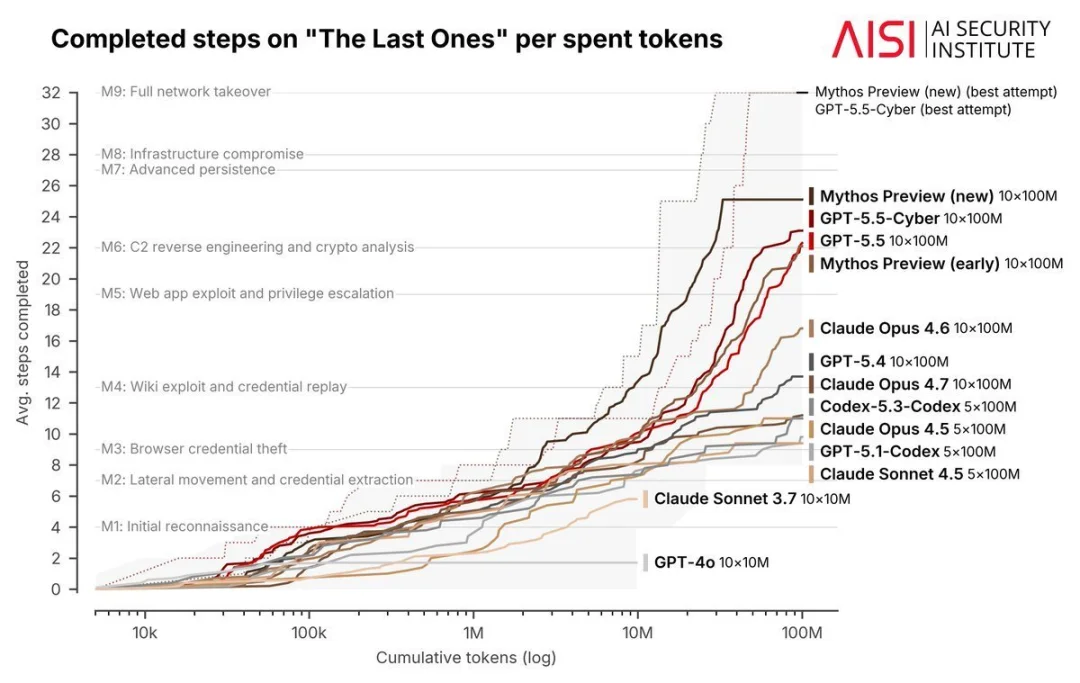
Hiện tượng này cho thấy các mô hình có thể sử dụng thời gian chạy ngày càng dài và ngân sách suy luận ngày càng lớn để liên tục khám phá, thử nghiệm và điều chỉnh các chiến lược trong các nhiệm vụ phức tạp. Những mô hình mạnh mẽ hơn không chỉ bắt đầu với một lợi thế vượt trội, mà còn có khả năng chuyển đổi nguồn lực tính toán bổ sung thành năng lực thực sự hiệu quả.
Theo suy đoán của Brown, khi khả năng của các mô hình được cải thiện, chu kỳ hoạt động hiệu quả của chúng cũng sẽ được kéo dài. Trong quá khứ, người ta có thể nhận thấy rằng hiệu suất của các mô hình trở nên ổn định trong điều kiện ngân sách tương đối hạn chế; trong tương lai, giới hạn về hiệu suất có thể sẽ được nâng cao hơn. Trong một số nhiệm vụ, cái gọi là “giai đoạn ổn định” (platform period) thậm chí có thể không còn là một trạng thái dễ đo lường nữa.
Từ việc đánh giá dựa trên một điểm số đơn lẻ chuyển sang sử dụng “đường cong hiệu suất-tiền phí” (performance-cost curve)
Đối mặt với sự thay đổi này, Brown đề nghị các tổ chức phát hành mô hình nên thay đổi cách trình bày kết quả các bài kiểm thử chuẩn (benchmark tests).
Thay vì chỉ công bố một điểm số cuối cùng, tốt hơn là ghi lại lượng tính toán suy luận trên trục ngang và hiển thị hiệu năng của nhiệm vụ trên trục dọc, đồng thời vẽ đường cong biểu diễn sự thay đổi hiệu năng một cách đầy đủ. Trục ngang có thể sử dụng các chỉ số như số lượng token, chi phí suy luận hoặc thời gian chạy thực tế.
Phương pháp này có thể trả lời những câu hỏi khó giải thích trong bảng điểm truyền thống. Ví dụ, với ngân sách giống nhau, mô hình nào hoạt động tốt hơn? Khi ngân sách tăng gấp mười lần, mô hình nào cải thiện nhanh hơn? Mô hình có đang tiến gần đến giới hạn khả năng của mình không? Hiệu quả chi phí của các mô hình khác nhau thay đổi như thế nào?
Các phương pháp tương tự đã bắt đầu được sử dụng trong một số bài kiểm thử chuẩn. Brown đề cập rằng việc đánh giá ARC-AGI nhằm mục đích đo lường mối quan hệ giữa điểm số của mô hình và chi phí vận hành, chứ không chỉ đơn thuần là công bố một điểm số duy nhất.
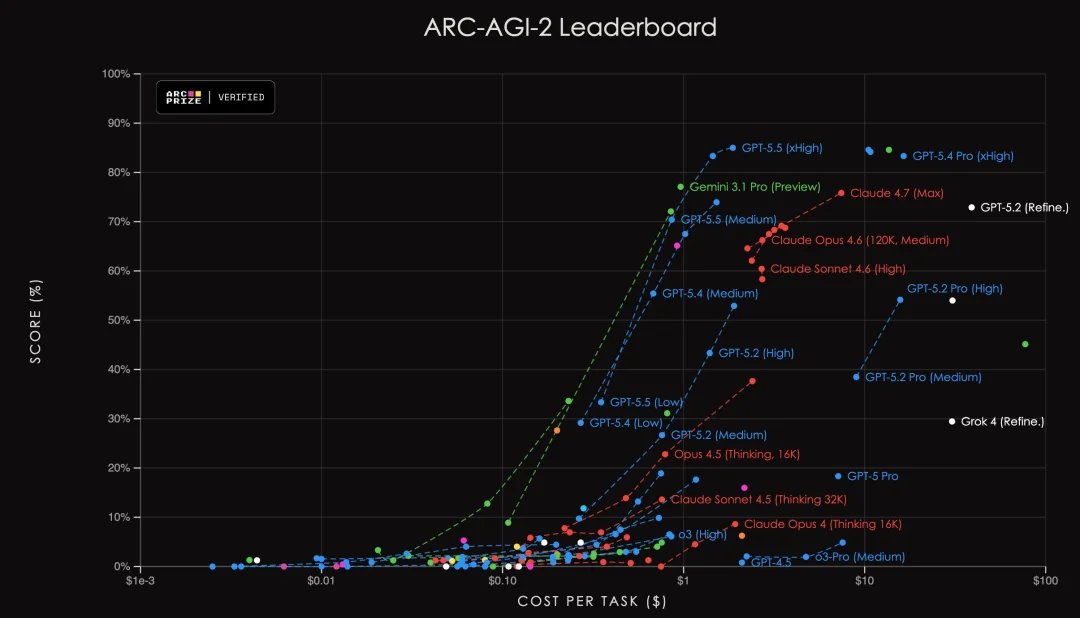
Một giải pháp khả thi khác là đặt ra các token cụ thể cho việc đánh giá, cùng với các giới hạn về chi phí hoặc thời gian, và thông báo trước cho mô hình về thông tin ngân sách. Cách này tương tự như cách con người tham gia các kỳ thi tiêu chuẩn hóa: dù là kỳ thi nhập học đại học SAT ở Mỹ hay Cuộc thi Toán học Olympic Quốc tế, thí sinh đều cần hoàn thành nhiệm vụ trong thời gian được quy định. Năng lực của các mô hình cũng có thể được so sánh trong những điều kiện giới hạn chung như vậy.
Tuy nhiên, Brown cũng chỉ ra rằng các chỉ số khác nhau là có hạn.
Do các mô hình sử dụng các công cụ phân tích ngôn ngữ (tokenizer) khác nhau, tốc độ tạo ra kết quả và các đơn vị đo lường khác nhau, số lượng token có thể không thể so sánh trực tiếp giữa các mô hình với nhau. Chi phí liên quan đến việc tạo ra token cũng có thể khác nhau tùy theo điều kiện. Chi phí này chịu ảnh hưởng bởi tỷ lệ sử dụng phần cứng, khả năng xử lý hàng loạt dữ liệu và cách thức triển khai công nghệ. Vì thời gian chạy chương trình không phải là một chỉ số hoàn hảo, nên nó cũng không phải là chỉ số phản ánh đầy đủ hiệu quả của hệ thống. Các kỹ thuật như “hợp tác đa thực thể” (multi-agent cooperation) hoặc “best-of-N” có thể tạo ra nhiều giải pháp đề xuất cùng lúc, nhưng điều này không nhất thiết làm tăng đáng kể thời gian chờ đợi của người dùng; tuy nhiên, chúng có thể làm tăng đáng kể tổng lượng tính toán cần thực hiện.
Mặc dù vậy, ông ấy cho rằng bất kỳ chỉ số nào trong số trên cũng cung cấp nhiều thông tin hơn so với một điểm số đơn lẻ vượt quá ngân sách suy luận.
Vấn đề ngân sách suy luận đang được mở rộng sang lĩnh vực đánh giá an ninh trí tuệ nhân tạo.
Thảo luận của Brown không chỉ giới hạn ở danh sách các mô hình; ông ấy tin rằng ngân sách suy luận cũng ảnh hưởng trực tiếp đến việc quản lý an ninh của các mô hình tiên tiến.
Trước khi phát hành các mô hình trí tuệ nhân tạo tiên tiến, các tổ chức nghiên cứu và phát triển (R&D) thường đánh giá khả năng lạm dụng tiềm tàng như tấn công mạng, rủi ro sinh học, rủi ro hóa học, v.v. Nếu mô hình đạt đến một ngưỡng rủi ro nhất định, các tổ chức này có thể cần trì hoãn việc phát hành hoặc thêm các biện pháp giảm thiểu như hạn chế truy cập, cơ chế giám sát, v.v., trước khi triển khai.
Câu hỏi là, nếu khả năng của mô hình được cải thiện theo sự tăng lên của lượng tính toán dùng để suy luận, thì lượng ngân sách dành cho việc đánh giá an ninh nên là bao nhiêu?
Trên thực tế, người dùng thông thường có thể chỉ đầu tư vài đô la hoặc vài chục đô la cho một nhiệm vụ. Tuy nhiên, một tổ chức có nguồn lực dồi dào, một nhóm chuyên nghiệp hoặc một bên tham gia từ quốc gia có thể sẵn lòng đầu tư nhiều hơn nhiều so với người dùng thông thường cho một mục tiêu duy nhất. Nếu cơ quan đánh giá chỉ kiểm thử mô hình với ngân sách thấp, họ có thể đánh giá thấp khả năng rủi ro của mô hình trong điều kiện có nguồn lực cao.
Brown lấy ví dụ về tranh cãi sau khi Gemini 3 Deep Think được phát hành. Ông chỉ ra rằng kết quả kiểm thử chuẩn của Deep Think cao hơn đáng kể so với các mô hình trước đó, nhưng không cung cấp đầy đủ thông tin về hệ thống khi nó được ra mắt, điều này không đáp ứng được các yêu cầu về khả năng đánh giá rủi ro của phiên bản này. Hành động này đã nhận được sự chỉ trích từ một số nhà nghiên cứu an ninh trí tuệ nhân tạo.
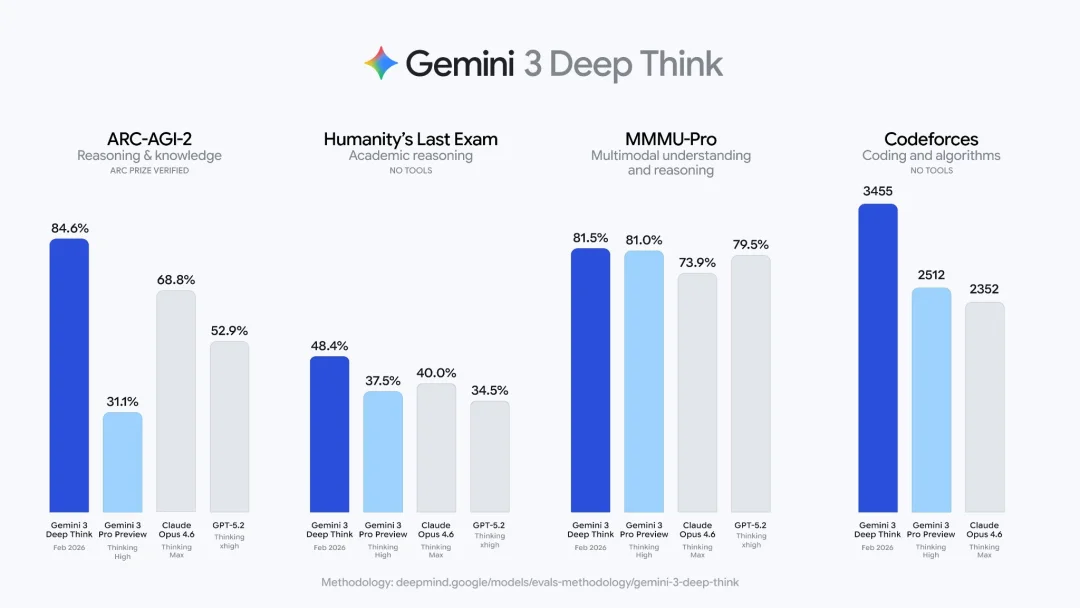
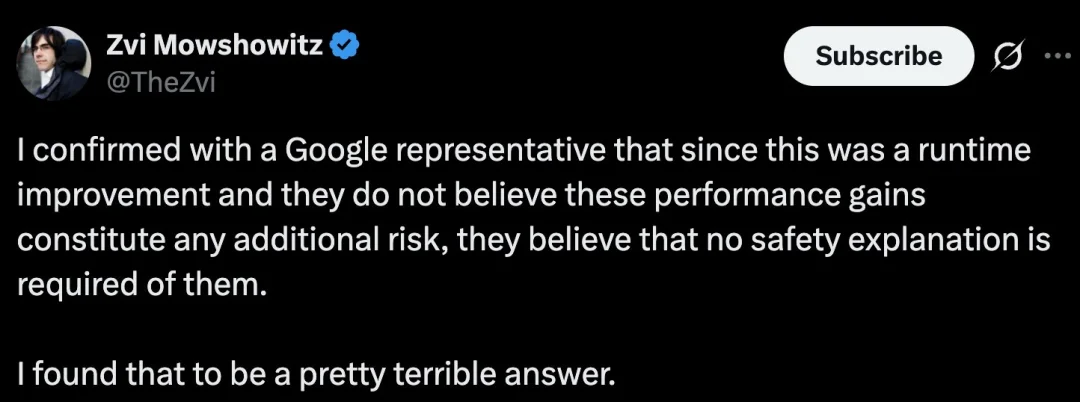
Tuy nhiên, có vẻ như đằng sau tranh cãi của Brown tồn tại một vấn đề sâu sắc hơn: các công ty trí tuệ nhân tạo và các tổ chức an ninh vẫn chưa xây dựng được một phương pháp ổn định để đánh giá khả năng của các mô hình dựa trên các ngân sách suy luận khác nhau.
Anh ấy suy đoán rằng Deep Think có thể không phải là một mô hình được đào tạo hoàn toàn độc lập, mà là một hệ thống khung suy luận dựa trên các mô hình hiện có. Hệ thống này có thể cải thiện hiệu suất thực hiện các nhiệm vụ phức tạp bằng cách gọi mô hình nhiều lần, tạo ra nhiều kết quả đề xuất song song, tự động kiểm tra câu trả lời và điều chỉnh lặp đi lặp lại.
Nếu giả định này đúng, thì về mặt lý thuyết, Deep Think không chỉ có thể thực hiện được một số chức năng được trình bày trên nền tảng mà còn cho phép các nhà phát triển bên ngoài, nếu họ sẵn lòng đầu tư đủ nhiều công sức vào quá trình suy luận, kết hợp nhiều mô hình lại với nhau để xây dựng các quy trình làm việc tương tự. Vai trò chính của Deep Think là biến những quy trình suy luận phức tạp đòi hỏi kỹ năng phát triển chuyên môn thành những sản phẩm mà người dùng thông thường cũng có thể sử dụng một cách dễ dàng.
Do đó, theo quan điểm của Brown và các đồng nghiệp, vấn đề thực sự đáng chú ý không phải là liệu sản phẩm có được phát hành riêng biệt với thẻ hệ thống hay không, mà là liệu các tổ chức nghiên cứu và phát triển có đã kiểm thử đầy đủ mức độ hiệu suất mà mô hình cơ bản có thể đạt được khi được phát hành lần đầu tiên, dựa trên các ngân sách và chiến lược xây dựng hệ thống khác nhau hay không.
Đánh giá ngân sách cao khó có thể được thực hiện một cách toàn diện, nhưng có thể thử áp dụng phương pháp suy ra từ dữ liệu hiện có (ngoại suy).
Theoretically, an entity with sufficient resources might be able to invest more than $10 million in reasoning costs for a single task. However, security assessments typically involve thousands or even millions of tests. If an extremely high budget is used for each operation, the assessment cost would quickly become unfeasible.
Brown đề xuất rằng có thể bắt đầu với các bài kiểm thử trong phạm vi ngân sách suy luận tương đối kiểm soát được, sau đó dựa trên xu hướng thay đổi khả năng của mô hình theo lượng tính toán để thúc đẩy hiệu suất ở các điều kiện ngân sách cao hơn. Đồng thời, các cơ quan đánh giá nên ghi rõ phạm vi dự đoán và mức độ không chắc chắn, thay vì coi kết quả tính toán như là kết luận chắc chắn.
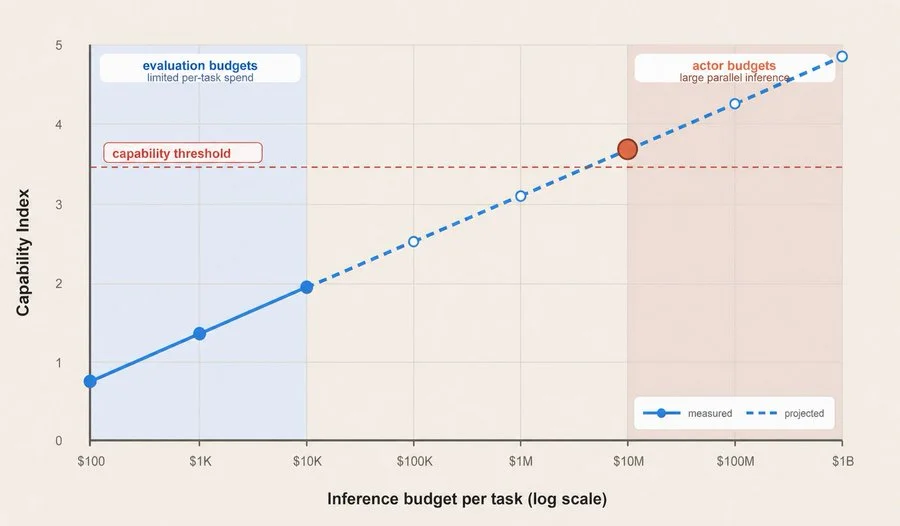
Phương pháp này tương tự như việc sử dụng dữ liệu cục bộ để ước lượng xu hướng thay đổi của hệ thống quy mô lớn hơn. Nó không thể thay thế được các bài kiểm thử thực tế, nhưng nó có thể giúp các tổ chức nghiên cứu và phát triển cũng như các cơ quan quản lý hiểu được những thay đổi có thể xảy ra ở các ranh giới rủi ro khi mô hình được cung cấp nhiều thời gian, công cụ và nguồn lực tính toán hơn.
Tuy nhiên, Brown cũng thừa nhận rằng các nhiệm vụ có thời gian thực hiện dài vẫn có thể gây ra những vấn đề mà các thí nghiệm ngắn hạn khó có thể giải quyết được.
Ví dụ, nếu các nhà nghiên cứu muốn xác định xem một thực thể thông minh độc lập có phát triển các sai lệch mục tiêu, hành vi lừa dối chiến lược hoặc các hành vi không phù hợp khác sau khi hoạt động liên tục trong một năm hay không, thì phương pháp đáng tin cậy nhất có lẽ vẫn là để thực thể đó hoạt động trong thời gian đủ dài. Chỉ dựa trên kết quả của vài giờ hoặc vài ngày thí nghiệm, có thể không thể phát hiện ra những thay đổi quan trọng trong hành vi lâu dài.
Điều này sẽ tạo ra một mâu thuẫn thực tế mới: chu kỳ phát triển và phát hành của các mô hình trí tuệ nhân tạo có thể chỉ kéo dài vài tháng, trong khi chu kỳ thực hiện các nhiệm vụ của các cơ thể thông minh có thể ngày càng dài hơn. Trong tương lai, các tổ chức nghiên cứu và phát triển có thể phải đối mặt với một tình huống đặc biệt – thế hệ mô hình tiếp theo có thể sẽ gần đến thời điểm phát hành trước khi kịp hoàn thành chu kỳ vận hành tối đa của chúng.
Ba đề xuất: Xem xét ngân sách suy luận như một biến cơ bản trong việc đánh giá mô hình
Để giải quyết các vấn đề nêu trên liên quan đến đánh giá năng lực và quản trị an ninh, Brown đã đưa ra ba đề xuất cụ thể.
Trước hết, khi các tổ chức nghiên cứu và phát triển trí tuệ nhân tạo (AI) phát hành mô hình mới, họ nên công bố kết quả các bài kiểm thử chuẩn (benchmark tests) dưới các điều kiện ngân sách suy luận khác nhau. Lý tưởng nhất là các công ty nên cung cấp đồ thị hiển thị mối quan hệ giữa số lượng token, chi phí hoặc thời gian thực thi trên trục ngang. Ít nhất, các công ty cũng cần giải thích rõ lượng tài nguyên suy luận thực tế đã được sử dụng để đạt được kết quả đó.
Thứ hai, bảng xếp hạng các bài kiểm thử chuẩn nên ghi lại mức tiêu thụ tài nguyên suy luận, hoặc đặt ra các giới hạn chung về số lượng token, chi phí hoặc thời gian cho các mô hình tham chiếu. Hiện nay, một số yếu tố đánh giá đã được tính đến, nhưng ngành này vẫn chưa hình thành các thực hành tiêu chuẩn.
Thứ ba, nguồn lực tính toán cho giai đoạn suy luận của Khung Chuẩn bị (Preparedness Framework) và Chính sách Mở rộng có Trách nhiệm (Responsible Scaling Policy – RSP) của các doanh nghiệp trí tuệ nhân tạo cần được xem xét một cách cụ thể. Khi các tổ chức đánh giá xem mô hình có vượt qua một ngưỡng an ninh nhất định hay không, họ không chỉ cần kiểm tra hiệu suất ở một cấu hình duy nhất mà còn phải đánh giá nhiều mức ngân sách suy luận khác nhau, đồng thời dự đoán mức độ rủi ro ở những điều kiện ngân sách cao hơn.
Ngành này đã nhận thức được vấn đề này, nhưng hệ thống đánh giá vẫn chưa theo kịp.
Việc tăng cường nguồn lực tính toán trong giai đoạn suy luận có thể cải thiện hiệu suất của mô hình, và đây không phải là một phát hiện mới.
Kể từ khi OpenAI công bố mô hình suy luận o1 vào tháng 9 năm 2024, giới chuyên môn đều nhận định rằng mô hình này thực hiện nhiều bước suy luận hơn khi trả lời câu hỏi, từ đó đạt được kết quả tốt hơn trong các lĩnh vực toán học, lập trình và các nhiệm vụ phân tích phức tạp. Các nghiên cứu về “khả năng mở rộng khi thực hiện các bài kiểm thử tính toán” hoặc “khả năng mở rộng trong quá trình suy luận tính toán” cũng dần trở thành hướng phát triển quan trọng cho các mô hình lớn.
Tuy nhiên, theo Brown, gần hai năm sau khi xuất hiện xu hướng này, việc phát hành nhiều mô hình tiên tiến vẫn chủ yếu dựa vào một điểm chuẩn duy nhất để truyền bá và so sánh. Một số cơ quan an ninh cũng có thể xem xét lại giới hạn của khả năng mô hình sau khi sử dụng ngân sách suy luận cao gấp hàng chục lần thậm chí hàng trăm lần trong hệ thống giá đỡ (framework).
Khi các mô hình ngày càng giỏi trong việc sử dụng các nguồn lực như thời gian chạy dài hơn, quá trình thử nghiệm lặp đi lặp lại nhiều lần, và khả năng suy luận quy mô lớn, khả năng giải thích của các danh sách truyền thống có thể tiếp tục suy giảm. Trong các điều kiện khác nhau như trả lời câu hỏi với ngân sách thấp, nghiên cứu sâu với ngân sách cao, sự hợp tác giữa nhiều trí tuệ nhân tạo, và việc gọi các công cụ tự động hóa, cùng một mô hình cơ bản có thể thể hiện những mức độ khả năng hoàn toàn khác nhau.
Brown cho rằng, trong tương lai khi đánh giá khả năng của trí tuệ nhân tạo, ngân sách dành cho việc suy luận không nên chỉ được coi là thông tin hỗ trợ trong quá trình kiểm thử, mà cần trở thành một tham số trung tâm trong báo cáo đánh giá, cùng với các yếu tố như quy mô mô hình, dữ liệu huấn luyện và cửa sổ ngữ cảnh.
Nhìn từ một góc độ rộng hơn, điều này cũng có nghĩa là ngành công nghiệp trí tuệ nhân tạo đang dần chia tay giai đoạn “định nghĩa một mô hình bằng một con số”. Đối với việc đánh giá khả năng, so sánh sản phẩm và quản lý an ninh, vấn đề thực sự quan trọng không chỉ là những gì một mô hình có thể làm, mà là những gì nó có thể làm được khi nó nhận được đủ thời gian, nguồn vốn và tài nguyên tính toán.
Tài liệu tham khảo: https://x.com/polynoamial/status/2064210146558136827
Tác giả đến từ “Trái Tim Máy móc” và “Biên tập viên Trái Tim Máy móc”.
Liên kết bài viết:https://airai.cc/vi/ai-news/10/
Thông tin này có hữu ích không?