Noam Brown, científico de OpenAI: el verdadero límite de la IA, que nadie puede permitirse medir
A medida que los grandes modelos de lenguaje comienzan a abordar tareas complejas como la inferencia, la investigación automatizada y la seguridad cibernética, los métodos tradicionales de evaluación de modelos se enfrentan a nuevos desafíos.
Durante mucho tiempo, el lanzamiento de modelos ha ido acompañado de tablas de resultados que incluyen una variedad de pruebas de referencia relacionadas con matemáticas, programación, preguntas y respuestas científicas, seguridad cibernética, inferencia de conocimiento, etc., y se comparan con los modelos de la generación anterior.
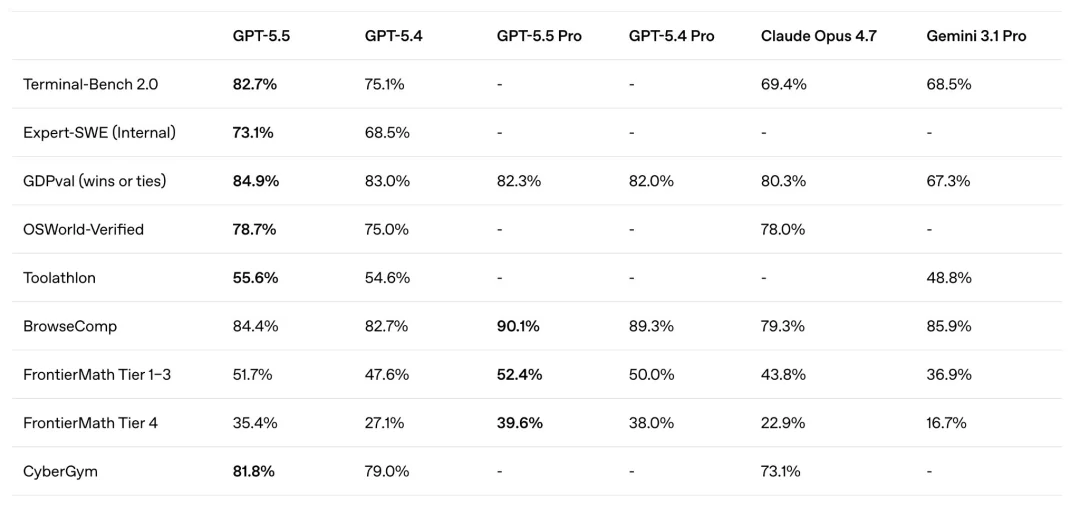
El investigador de OpenAI, Noam Brown, señaló recientemente en un artículo que, cuando los modelos utilizan más pasos de razonamiento al responder preguntas, invocan más herramientas o realizan búsquedas y pruebas de mayor duración, es cada vez más difícil que una única puntuación refleje con precisión la verdadera capacidad del modelo.
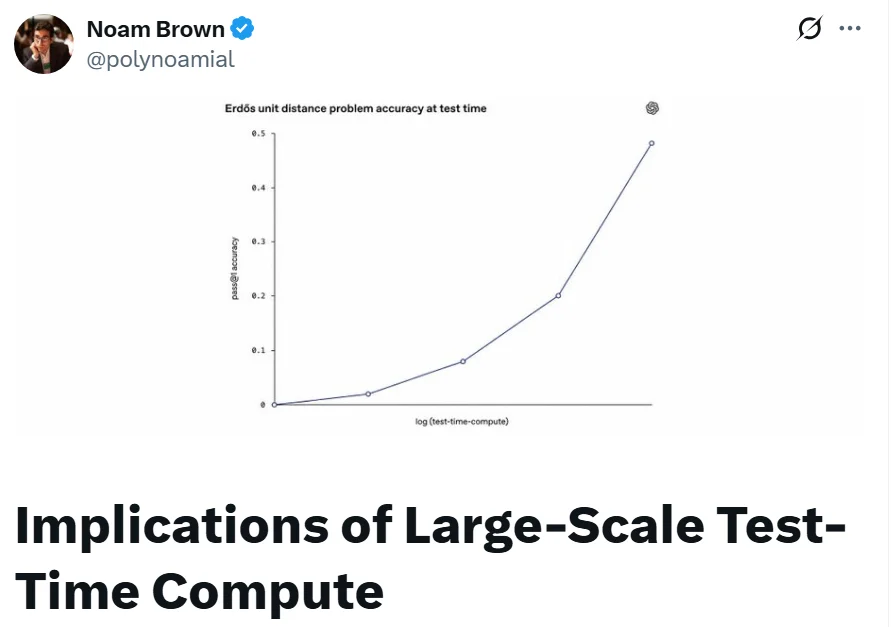
Las principales ideas de Brown son las siguientes:El rendimiento de los grandes modelos no solo depende del modelo en sí, sino también de la cantidad de recursos computacionales de los que dispone en la fase de razonamiento.Al evaluar modelos en el futuro, no podemos preguntarnos solo «¿Cuántos puntos ha obtenido el modelo?», sino que también debemos responder a otra pregunta: ¿Cuántos tokens ha consumido el modelo y a qué costo y tiempo de ejecución se ha logrado ese resultado?
Sugiere que la industria debe pasar de evaluar los «resultados individuales» a analizar el «rendimiento de la curva de cálculo de inferencia», y considerar el presupuesto para la inferencia como una variable fundamental en la evaluación de la capacidad de los modelos y en las políticas de seguridad de la inteligencia artificial.
Los sistemas de evaluación tradicionales pueden subestimar las diferencias en la capacidad de los nuevos modelos.
Brown utiliza la reacción del mercado después de la publicación de GPT-5.5 como ejemplo para ilustrar las limitaciones de las clasificaciones de modelos tradicionales.
Según su descripción,GPT-5.5Al comienzo de su lanzamiento, lo primero que llamó la atención del público fueron un conjunto de resultados de pruebas de rendimiento que no eran particularmente llamativos. Así mismo,GPT-5.4En comparación, las puntuaciones del nuevo modelo han mejorado, pero según las tablas de puntuaciones tradicionales, el aumento parece ser limitado. Por lo tanto, algunos usuarios adoptan una actitud de espera o incluso de escepticismo hacia la nueva versión.
Pero en las pocas horas posteriores a la apertura del modelo, algunos usuarios notaron que, a medida que los desarrolladores e investigadores comenzaron a probar tareas más complejas, GPT-5.5 mostró diferencias generacionales más evidentes en el razonamiento de cadenas largas, la ejecución continua y el manejo de problemas complejos. Brown cree que este fenómeno, en el que la «experiencia práctica mejora significativamente, pero las puntuaciones en la lista cambian poco», refleja que las evaluaciones tradicionales no son capaces de representar completamente el potencial del modelo.
El problema es que los resultados de la evaluación de diferentes modelos pueden no basarse en el mismo presupuesto de razonamiento.
En los marcos de evaluación tradicionales, los investigadores a menudo eligen un conjunto de configuraciones de prueba para cada modelo con el objetivo de mejorar los resultados tanto como sea posible y luego colocan las puntuaciones finales en la misma tabla. Esto parece justo, pero puede ocultar una variable clave: algunos modelos pueden seguir mejorando significativamente su rendimiento al recibir más tokens de inferencia, más llamadas o un tiempo de ejecución más largo; otros modelos, por otro lado, pueden alcanzar su límite de rendimiento más temprano.
Los casos de evaluación de seguridad cibernética mostrados por Brown indican que si los llamados modelos se comparan únicamente en base al resultado final bajo la condición de «calcular la cantidad máxima durante la prueba», la ventaja de GPT-5.5 en comparación con GPT-5.4 puede no ser tan evidente. Sin embargo, si el número de tokens, el costo de la inferencia o la latencia se mantienen a un mismo nivel y luego se observa el rendimiento de los diferentes modelos, la mejora en la capacidad de GPT-5.5 será mucho más notable.
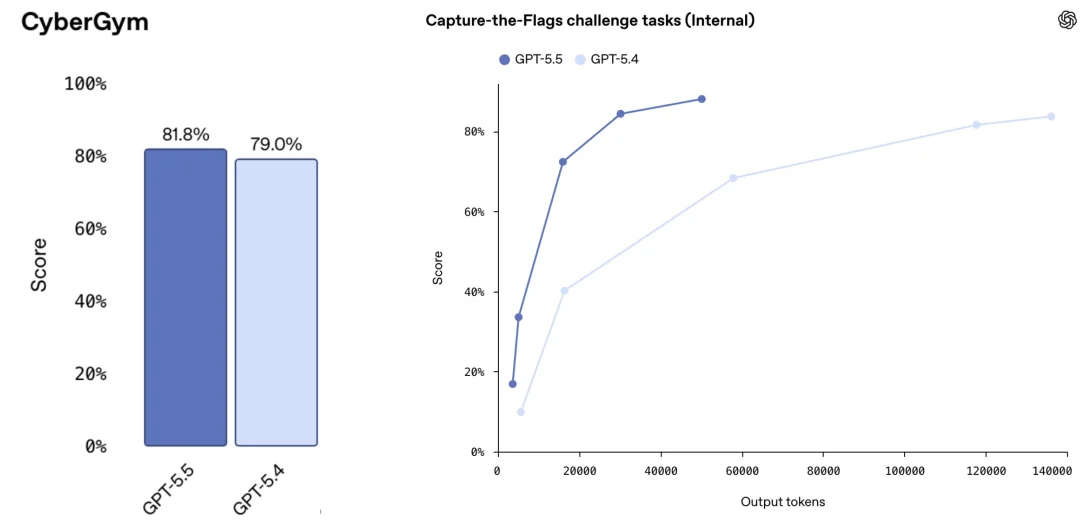
En otras palabras, la diferencia entre los modelos no solo se refleja en las puntuaciones finales, sino también en la eficiencia con la que utilizan la cantidad adicional de cálculo para la inferencia.
¿Por qué no es tan simple? “Continuar añadiendo recursos de inferencia hasta que el rendimiento ya no mejore más”.
La solución intuitiva sería seguir incrementando los recursos para cada modelo hasta que su rendimiento alcanze un punto de estancamiento (platoforma), y luego comparar su capacidad máxima.
Brown cree que esta idea podría ser in practicable en la realidad. La razón es que para las nuevas generaciones de modelos, el punto de estancamiento en el rendimiento podría llegar mucho más tarde de lo esperado, e incluso podría ser difícil de detectar dentro del rango presupuestario realmente viable.
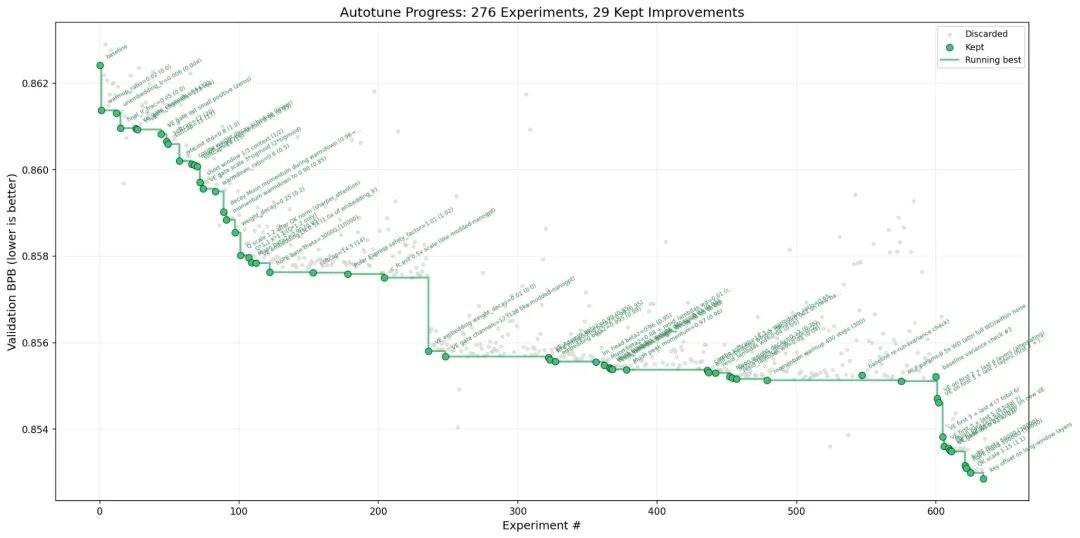
Él citó como ejemplo el experimento de investigación automatizada iniciado por Andrej Karpathy. En ese experimento, el rendimiento del modelo continuó mejorando incluso después de que se realizaran numerosos ensayos. Incluso después de cientos de pruebas, la curva de mejora no fue completamente estable (es decir, no mostró una tendencia de estabilización).
Brown Además, el Instituto de Seguridad de la Inteligencia Artificial del Reino Unido también mencionó los resultados de la evaluación de seguridad cibernética realizada por dicho instituto. En esta evaluación, modelos como Mythos y GPT-5.5, entre otros, mostraron un continuo mejoramiento en su rendimiento después de haber utilizado un total de más de 100 millones de tokens.
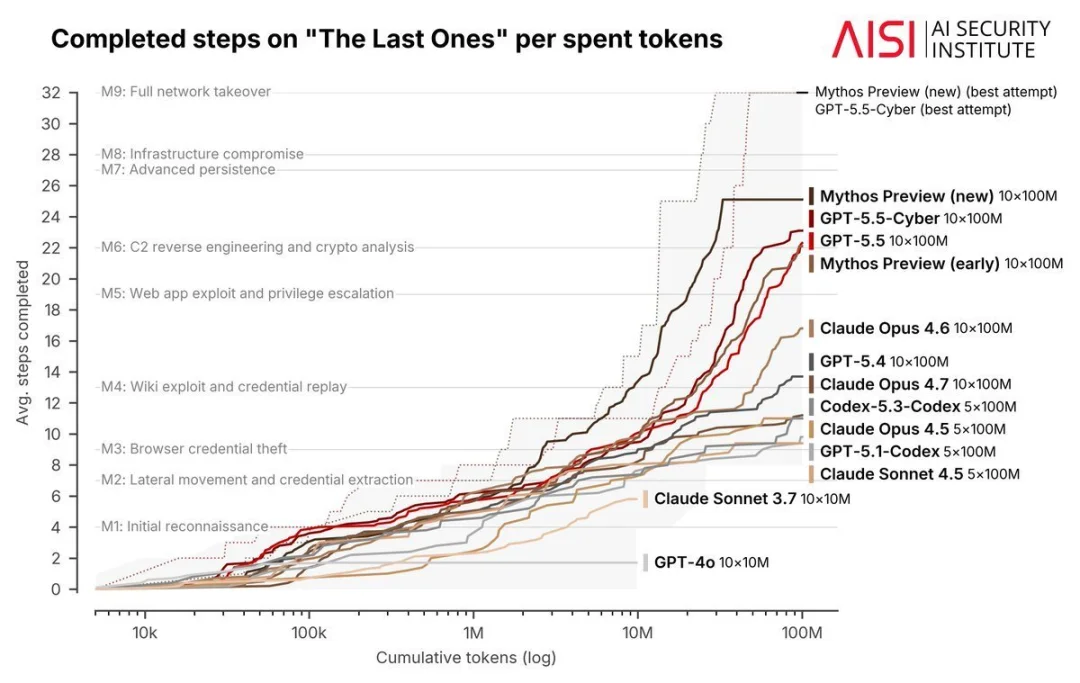
Este fenómeno significa que los modelos pueden utilizar tiempos de ejecución cada vez más largos y presupuestos de inferencia más elevados para explorar, probar y corregir estrategias continuamente en tareas complejas. Los modelos más potentes no solo tienen un punto de partida más alto, sino que también pueden ser más capaces de convertir recursos de cálculo adicionales en capacidades efectivas.
Según Brown, se presume que a medida que mejore la capacidad de los modelos, también se prolongará el ciclo de tiempo en el que funcionan de manera efectiva. En el pasado, se podría observar que el rendimiento de los modelos se estabilizaba dentro de un presupuesto relativamente limitado; en el futuro, el límite de rendimiento podría aumentar. En algunas tareas, lo que se conoce como “período de estancamiento” (plateau) podría dejar de ser un estado fácil de medir.
De una única puntuación a la «curva rendimiento-costo»
Frente a este cambio, Brown sugiere que las instituciones que publican los modelos deben modificar la forma en que se presentan los tests de referencia.
En lugar de publicar solo una puntuación final, sería mejor marcar la cantidad de cálculo de inferencia en el eje horizontal y mostrar el rendimiento de la tarea en el eje vertical, trazando una curva completa de cambio de rendimiento. El eje horizontal podría utilizar indicadores como el número de tokens, el costo de inferencia o el tiempo de ejecución real.
Este método puede responder a preguntas que son difíciles de explicar en las tablas de calificaciones tradicionales. Por ejemplo, ¿cuál modelo funciona mejor con el mismo presupuesto? ¿Cuál modelo mejora más rápido cuando el presupuesto se incrementa diez veces? ¿Está el modelo cerca del límite de su capacidad? ¿Cómo cambia la relación costo-beneficio de los diferentes modelos?
Los métodos similares ya se han comenzado a utilizar en algunos ensayos de referencia. Brown menciona que la evaluación ARC-AGI intenta medir la relación entre las puntuaciones de los modelos y los costos de ejecución, y no simplemente publicar una única puntuación.
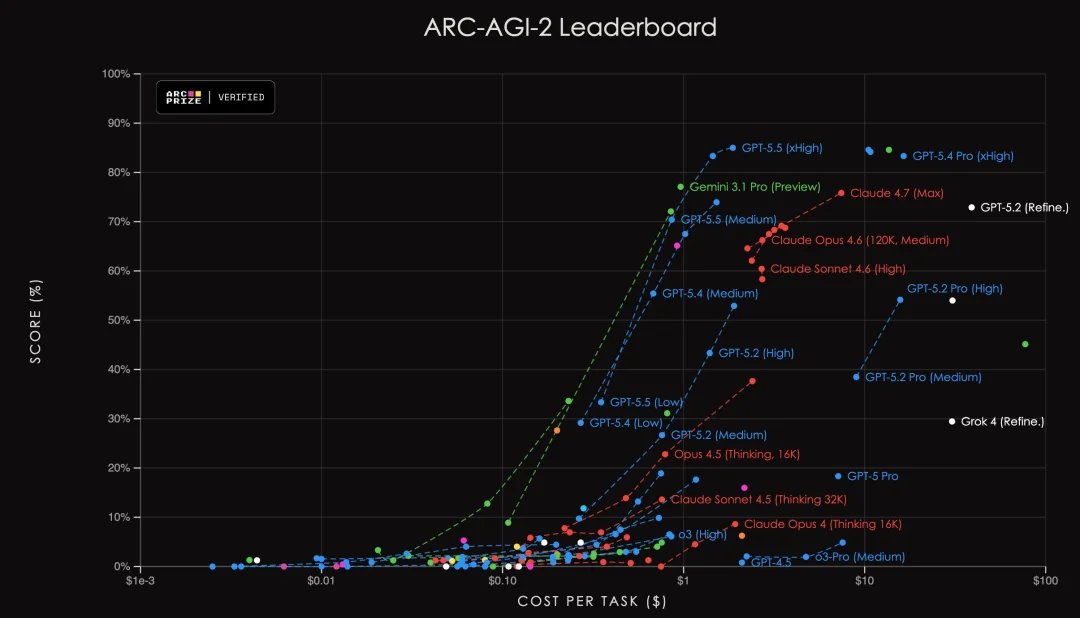
Otra opción viable es establecer tokens de planificación claros, limitaciones de costos o de tiempo para la evaluación, y notificar anticipadamente a los modelos la información sobre el presupuesto. Este enfoque es similar al de los humanos que participan en exámenes estandarizados: ya sea el Examen de Admisión a Universidades de los EE. UU. (SAT) o los Juegos Olímpicos Internacionales de Matemáticas, los participantes deben completar las tareas en un tiempo determinado. De esta manera, las capacidades de los modelos también pueden compararse bajo restricciones uniformes.
Sin embargo, Brown también señaló que los diferentes indicadores son limitados.
Debido a que los diferentes modelos utilizan segmentadores de palabras distintos, velocidades de generación y unidades de medida, es posible que las cantidades no sean directamente comparables entre ellos. El costo de generación también puede variar. El costo está influenciado por el uso del hardware, el procesamiento en lotes y la implementación del proyecto. Dado que el tiempo de ejecución no es un indicador perfecto, tampoco lo es el tiempo de respuesta. Técnicas como la «cooperación de múltiples agentes inteligentes» o el método best-of-N pueden generar múltiples respuestas candidatas de forma paralela, lo que no necesariamente aumenta significativamente el tiempo de espera percibido por el usuario, pero sí incrementa considerablemente la cantidad total de cálculos.
A pesar de ello, considera que cualquiera de los indicadores mencionados proporciona más información que una única puntuación que se desvía del presupuesto de razonamiento.
El problema del presupuesto de razonamiento se está extendiendo a la evaluación de la seguridad de la inteligencia artificial.
Los debates de Brown no se limitan a la lista de modelos; cree que el presupuesto de razonamiento también afecta directamente la gestión de la seguridad de los modelos de vanguardia.
Antes de publicar modelos de inteligencia artificial de vanguardia, las instituciones de I+D suelen evaluar posibles capacidades de abuso, como ataques cibernéticos, riesgos biológicos y riesgos químicos. Si un modelo alcanza un cierto umbral de riesgo, las instituciones de I+D pueden necesitar posponer su publicación o implementar medidas de mitigación, como restricciones de acceso y mecanismos de monitoreo, antes de su despliegue.
La pregunta es: si la capacidad del modelo mejora a medida que aumenta la cantidad de cálculo de inferencia, ¿cuánto presupuesto de inferencia debería utilizarse para la evaluación de seguridad?
De hecho, un usuario promedio podría invertir solo unos pocos dólares o decenas de dólares en una tarea. Sin embargo, una organización con fondos suficientes, un equipo profesional o un actor estatal podría estar dispuesto a invertir recursos mucho mayores que los de un usuario promedio en un único objetivo. Si las instituciones de evaluación prueban los modelos con un presupuesto más reducido, podrían subestimar su capacidad de riesgo en condiciones de altos recursos.
Brown toma como ejemplo la controversia que surgió después del lanzamiento de Gemini 3 Deep Think. Señala que los resultados de los tests de referencia de Deep Think eran significativamente superiores a los de los modelos anteriores, pero no se proporcionó el conjunto completo de datos del sistema al momento del lanzamiento para evaluar la capacidad de riesgo de esa versión. Este enfoque ha generado críticas por parte de algunos investigadores en seguridad de la inteligencia artificial.
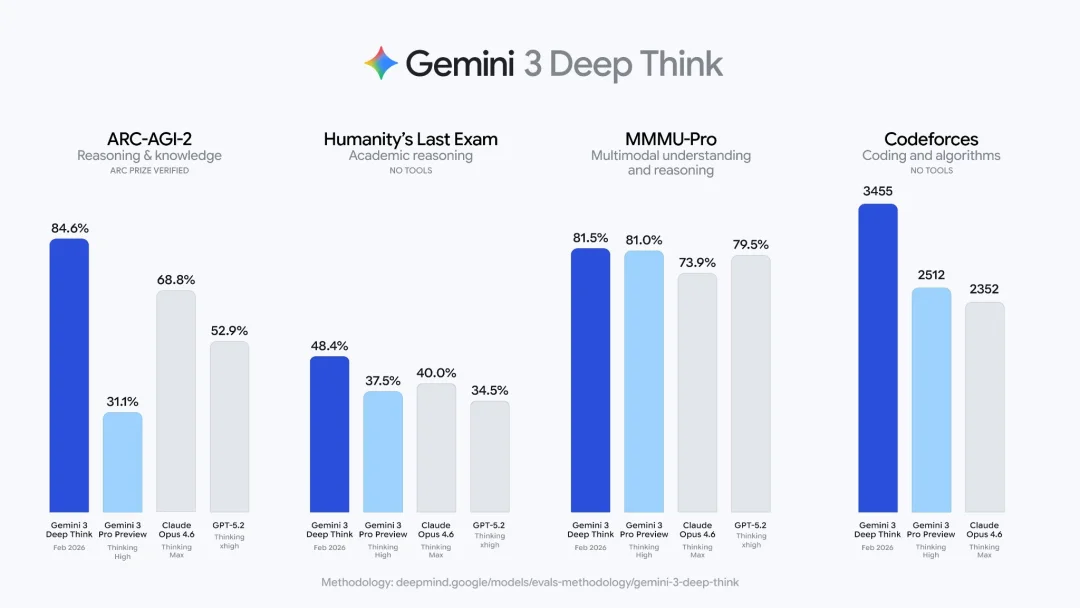
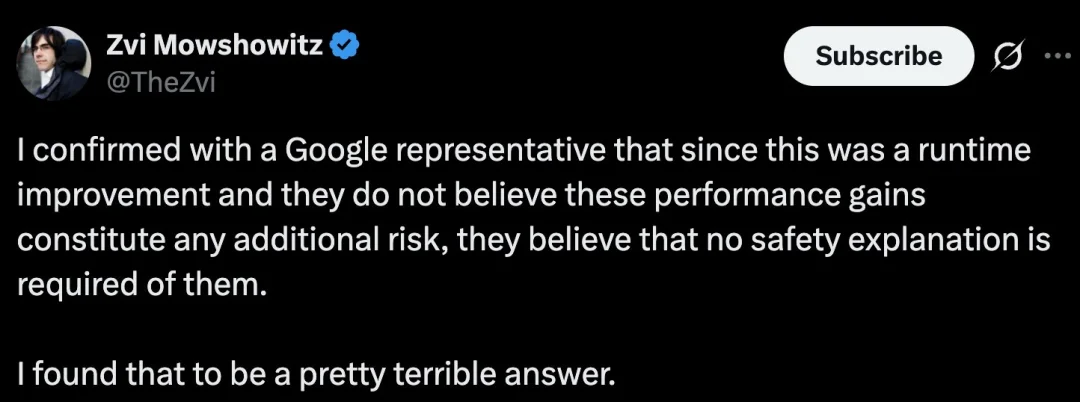
Sin embargo, parece que hay un problema más profundo detrás de la controversia de Brown: las empresas de inteligencia artificial y las instituciones de seguridad aún no han desarrollado un método estable para evaluar la capacidad de los modelos bajo diferentes presupuestos de razonamiento.
Él especula que Deep Think podría no ser un modelo completamente nuevo entrenado de forma independiente, sino más bien un sistema de andamiaje de razonamiento basado en otros modelos existentes. Este sistema puede mejorar el rendimiento de tareas complejas mediante la llamada repetida de modelos, la generación paralela de resultados candidatos, la verificación automática de respuestas y la corrección iterativa.
Si esta premisa se establece, entonces, en teoría, Deep Think no solo podría implementar algunas de las capacidades que muestra la plataforma en sí misma. Mientras los desarrolladores externos estén dispuestos a invertir un costo de razonamiento suficientemente alto, también podrían combinar múltiples modelos para crear flujos de trabajo similares. El papel de Deep Think es principalmente encapsular procesos de razonamiento complejos que normalmente requieren habilidades de desarrollo especializado en productos que los usuarios comunes puedan utilizar de manera sencilla.
Por lo tanto, la gente de Brown cree que la verdadera cuestión que merece atención no es si el sistema de tarjetas se lanzó por separado o no, sino si las instituciones de investigación y desarrollo han probado adecuadamente el nivel de capacidad que el modelo básico podría alcanzar cuando se lanzó por primera vez, teniendo en cuenta diferentes presupuestos de inferencia y estrategias de desarrollo.
La evaluación con presupuestos elevados es difícil de implementar de manera integral, pero se puede intentar hacer extrapolaciones.
En teoría, un actor con recursos suficientes podría invertir hasta un millón de dólares en costos de inferencia para una sola tarea. Sin embargo, las evaluaciones de seguridad suelen involucrar miles o incluso millones de pruebas. Si se utiliza un presupuesto muy alto para cada operación, el costo de la evaluación perdería rápidamente su viabilidad.
Brown propone que se puedan realizar pruebas dentro de un presupuesto de inferencia relativamente controlable, y luego mejorar el rendimiento bajo condiciones de presupuesto más alto a medida que cambie la capacidad del modelo con el volumen de cálculo. Al mismo tiempo, las instituciones de evaluación deben marcar claramente el rango de predicción y la incertidumbre, en lugar de considerar los resultados del cálculo como conclusiones definitivas.
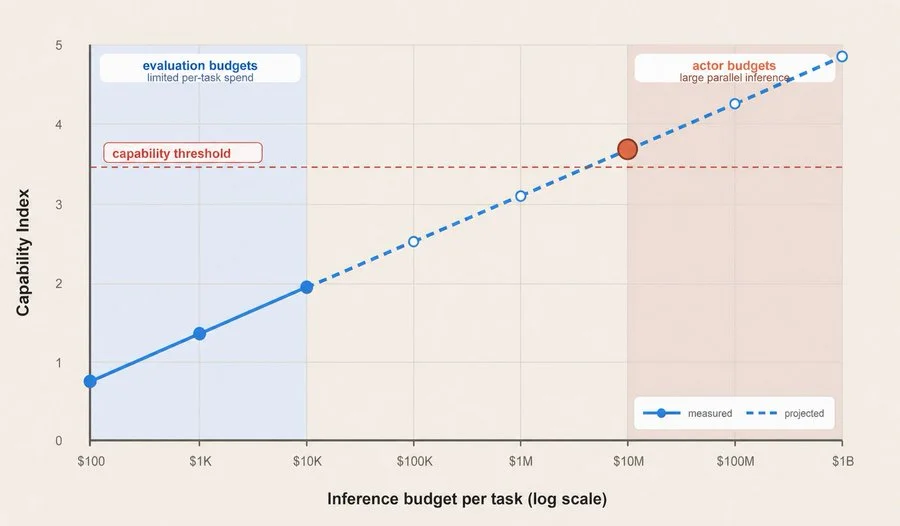
Este método es similar a estimar las tendencias de cambio en sistemas de mayor escala a partir de datos locales. No puede reemplazar las pruebas reales, pero puede ayudar a las instituciones de investigación y desarrollo y a las autoridades reguladoras a comprender cómo podrían cambiar los límites de riesgo cuando se le dé al modelo más tiempo, herramientas y recursos de cálculo.
Sin embargo, Brown también reconoce que las tareas de largo plazo pueden presentar problemas que son difíciles de resolver con experimentos a corto plazo.
Por ejemplo, si los investigadores quieren determinar si un ente inteligente independiente desarrollará desviaciones de objetivos, engaños estratégicos u otros comportamientos incompatibles después de funcionar continuamente durante un año, el método más fiable podría seguir siendo dejar que el ente inteligente opere durante un período de tiempo suficientemente largo. Basarse únicamente en los resultados de experimentos de unas pocas horas o días podría no permitir detectar los cambios clave en su comportamiento a largo plazo.
Esto generará un nuevo conflicto de realidad: el ciclo de desarrollo y lanzamiento de los modelos de inteligencia artificial podría ser de solo unos meses, mientras que el ciclo de tareas que un cuerpo inteligente puede realizar de manera continua podría ser cada vez más largo. En el futuro, las instituciones de investigación y desarrollo podrían enfrentar una situación especial: el próximo modelo podría estar cerca de su lanzamiento antes de haber completado su ciclo máximo de funcionamiento.
Tres sugerencias: hacer que el presupuesto para la inferencia sea una variable básica en la evaluación de los modelos
En respuesta a los problemas mencionados anteriormente en la evaluación de capacidades y la gobernanza de la seguridad, Brown propone tres sugerencias concretas.
Primero, cuando las instituciones de investigación en inteligencia artificial lanzan nuevos modelos, deben publicar los resultados de las pruebas de rendimiento bajo diferentes condiciones de presupuesto de inferencia. En el ideal, las empresas deberían proporcionar curvas de rendimiento con el número de tokens, el costo o el tiempo de ejecución en el eje horizontal. Al menos, las empresas necesitan explicar cuántos recursos de inferencia se utilizaron realmente para obtener un resultado concreto.
En segundo lugar, las clasificaciones de las pruebas de rendimiento deben registrar el consumo de recursos de inferencia, o establecer límites uniformes de tokens, costos o tiempo para los modelos de referencia. Actualmente, algunas evaluaciones ya han incorporado estos factores, pero la industria aún no ha adoptado prácticas estándar al respecto.
En tercer lugar, los recursos de computación necesarios para las fases de razonamiento del Marco de Preparación de las empresas de inteligencia artificial (Preparedness Framework) y de la Política de Escalado Responsable (Responsible Scaling Policy, RSP) deben considerarse de manera explícita. Cuando una institución determina si un modelo supera ciertos umbrales de seguridad, no solo se debe verificar el rendimiento en una sola configuración, sino también evaluar varios niveles de presupuesto de razonamiento, así como hacer predicciones de incertidumbre sobre la capacidad de respuesta frente a condiciones de presupuesto más elevadas.
La industria ya es consciente de este problema, pero los sistemas de evaluación aún no han avanzado lo suficiente para abordarlo de manera integral.
Aumentar los recursos de cálculo en la fase de inferencia puede mejorar el rendimiento del modelo, y esto no es un descubrimiento nuevo.
Desde que OpenAI lanzó el modelo de razonamiento o1 en septiembre de 2024, la industria en general considera que este modelo emplea más pasos de razonamiento al responder preguntas, lo que le permite obtener mejores resultados en tareas matemáticas, de código y de análisis complejo. La investigación sobre la «ampliabilidad al realizar pruebas de cálculo» o la «ampliabilidad en el razonamiento computacional» también se ha convertido gradualmente en una dirección importante en el desarrollo de grandes modelos.
Pero Brown cree que, incluso después de casi dos años de esta tendencia, la publicación de muchos modelos de vanguardia todavía se basa principalmente en una única puntuación de referencia para su difusión y comparación. Algunas agencias de seguridad también pueden reevaluar los límites de la capacidad de los modelos después de utilizar presupuestos de inferencia que son decenas o incluso cientos de veces mayores en los sistemas de andamiaje.
A medida que los modelos se vuelven más capaces de utilizar procesos a largo plazo, múltiples iteraciones de prueba y error, y recursos de inferencia a gran escala, la interpretación de las listas tradicionales puede seguir disminuyendo. Bajo diferentes condiciones, como preguntas y respuestas con bajos presupuestos, investigaciones profundas con altos presupuestos, colaboración entre múltiples inteligencias y llamadas a herramientas automatizadas, el mismo modelo básico puede mostrar niveles de capacidad completamente diferentes.
Brown sostiene que, en el futuro, al medir las capacidades de la inteligencia artificial, el presupuesto de inferencia no debería considerarse más como información adicional durante el proceso de prueba, sino que debería convertirse en un parámetro central en los informes de evaluación, junto con el tamaño del modelo, los datos de entrenamiento y la ventana de contexto.
Desde una perspectiva más amplia, esto también significa que la industria de la inteligencia artificial está dejando gradualmente atrás la etapa de definir un modelo con un solo número. Para la evaluación de capacidades, la comparación de productos y la gestión de seguridad, lo realmente importante no es solo lo que puede hacer un modelo, sino lo que puede lograr cuando dispone de suficiente tiempo, fondos y recursos de computación.
Referencia de enlace: https://x.com/polynoamial/status/2064210146558136827
El autor proviene de “Machine Heart” y es del “Equipo Editorial de Machine Heart”.
Enlace del artículo:https://airai.cc/es/ai-news/10/
¿Te ha resultado útil?