نعوم براون، عالم OpenAI: الحد الأقصى الحقيقي للذكاء الاصطناعي قد لا يقيسه أحد
مع دخول نماذج اللغات الكبيرة تدريجيًا في مهام معقدة مثل الاستدلال والبحث الآلي وأمن الشبكات، تواجه طرق تقييم النماذج التقليدية تحديات جديدة.
لفترة طويلة، كان إطلاق النماذج يصاحبه عادةً جداول نتائج تتكون من اختبارات متنوعة مثل الرياضيات والبرمجة والأسئلة العلمية وأمن الشبكات والاستدلال المعرفي، ويتم مقارنة هذه النتائج مع الجيل السابق من النماذج.
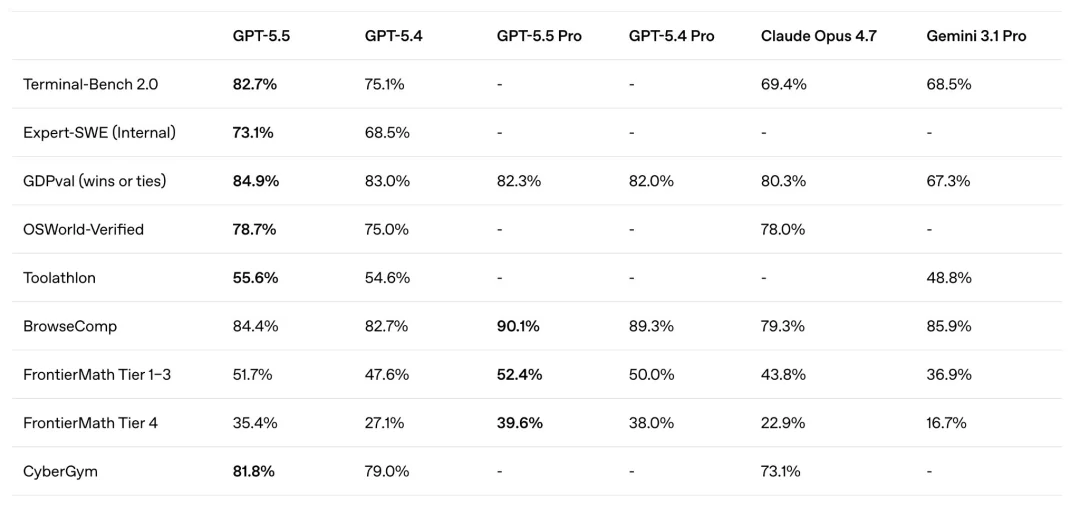
الباحث في OpenAI، نوع براون، أشار مؤخرًا إلى أنه عندما تستخدم النماذج المزيد من خطوات التفكير عند الإجابة على الأسئلة، أو تستدعي المزيد من الأدوات، أو تقوم بعمليات بحث واختبار أطول، يصبح من الصعب أكثر فأكثر أن يعكس الدرجة الواحدة بدقة القدرات الفعلية للنموذج.
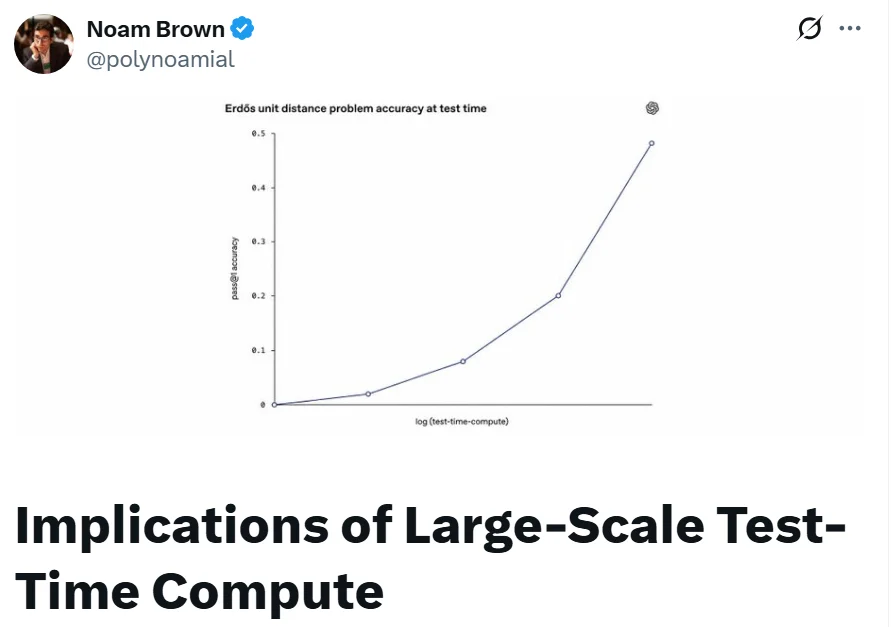
النقاط الرئيسية لبراون هي كالتالي:أداء النماذج الكبيرة لا يعتمد فقط على النموذج نفسه، ولكن أيضًا على كمية الموارد الحاسوبية التي حصل عليها النموذج خلال مرحلة التفكير.عند تقييم النماذج في المستقبل، لا يمكننا أن نسأل فقط "كم حصل النموذج على درجات؟"، بل يجب أن نجيب أيضًا على سؤال آخر: كم عدد الرموز (tokens) التي استهلكها النموذج، وبأي تكلفة ووقت تشغيل تم تحقيق هذا النتيجة؟
يقترح أن تتحول الصناعة من التركيز على "الدرجات الفردية" إلى "أداء منحنى حسابات التفكير الاستدلالي"، وأن تعتبر ميزانية التفكير الاستدلالي كمتغير أساسي في تقييم قدرات النماذج ضمن سياسات أمان الذكاء الاصطناعي.
قد تقلل الجداول التقليدية للتقييم من شأن الفروق في قدرات النماذج الجديدة.
يستخدم براون (Brown) ردود فعل السوق بعد الإصدار كمثال على القيود المفروضة على ترتيب النماذج التقليدية، مستخدمًا الرمز GPT-5.5.
وفقًا لوصفه،GPT-5.5في بداية الإصدار، لاحظ الجمهور أولاً مجموعة من نتائج اختبارات الأداء التي لم تكن بارزة بشكل خاص. وكذلكGPT-5.4مقارنةً بذلك، تحسنت نتائج النموذج الجديد، ولكن من وجهة نظر جداول الدرجات التقليدية، يبدو أن مقدار التحسن محدود. لذلك، يتخذ بعض المستخدمين موقفاً متردداً تجاه الإصدار الجديد بل ويشككون فيه.
لكن في غضون ساعات قليلة من فتح النموذج، اكتشف بعض المستخدمين أنه مع بدء المطورين والباحثين في اختبار مهام أكثر تعقيدًا، أظهر GPT-5.5 اختلافات واضحة بين الأجيال فيما يتعلق بالتنبؤات الطويلة السلسلة والتنفيذ المستمر ومعالجة المشكلات المعقدة. يعتقد براون أن هذه الظاهرة، التي تتمثل في "تحسن واضح في الخبرة العملية، لكن مع تغيرات محدودة في درجات القائمة"، تعكس أن التقييمات التقليدية لا تعكس بشكل كامل قدرات النموذج.
المشكلة هي أن نتائج تقييم النماذج المختلفة قد لا تستند إلى نفس ميزانية التفكير.
في الأطر التقليدية للتقييم، يختار الباحثون غالبًا مجموعة من إعدادات الاختبار لكل نموذج من أجل تحسين النتائج قدر الإمكان، ثم يضعون الدرجات النهائية في جدول واحد. قد يبدو هذا عادلاً، ولكنه قد يخفي متغيرًا رئيسيًا: بعض النماذج قد تتمكن من الحصول على المزيد من رموز التفكير (tokens)، أو عدد أكبر من المكالمات (calls)، أو وقت تشغيل أطول، مما يؤدي إلى تحسين أدائها بشكل ملحوظ؛ بينما قد تصل نماذج أخرى إلى حد أقصى لأدائها في وقت أسرع.
تُظهر حالات تقييم الأمن السيبراني التي نشرها Brown أنه إذا قارنا كل نموذج على حدة، فإن الميزة بين GPT-5.5 و GPT-5.4 قد لا تكون واضحة من حيث النتيجة النهائية تحت شرط "حساب أقصى كمية خلال الاختبار". ولكن إذا تم السيطرة على عدد الرموز، تكلفة التفكير، أو التأخير على نفس المستوى، ثم مراقبة أداء النماذج المختلفة، فإن تحسن قدرات GPT-5.5 سيكون أكثر وضوحًا.
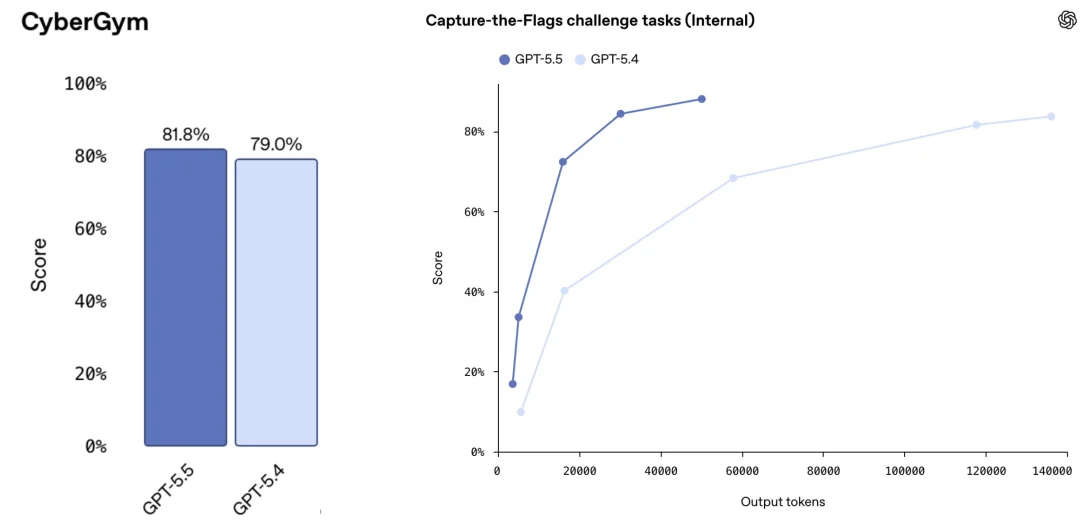
بعبارة أخرى، الفارق بين النماذج لا يتجلى فقط في النتائج النهائية، ولكن أيضًا في كفاءة استخدام الكميات الإضافية من الحسابات التفكيرية.
لماذا لا يمكن أن يكون الأمر بسيطًا؟ "الاستمرار في التشغيل حتى تتوقف الأداء عن التحسن"
الحل البديهي هو الاستمرار في زيادة موارد التنبؤ لكل نموذج حتى يصل أداؤه إلى مرحلة الاستقرار، ثم مقارنة أعلى قدراته.
يعتقد براون أن هذه الفكرة قد لا تكون قابلة للتطبيق في الواقع. السبب هو أن فترة الأداء الثابت للنماذج الجديدة قد تأتي أبعد مما كان متوقعًا، بل وقد يكون من الصعب ملاحظتها حتى ضمن نطاق الميزانية المقبولة فعليًا.
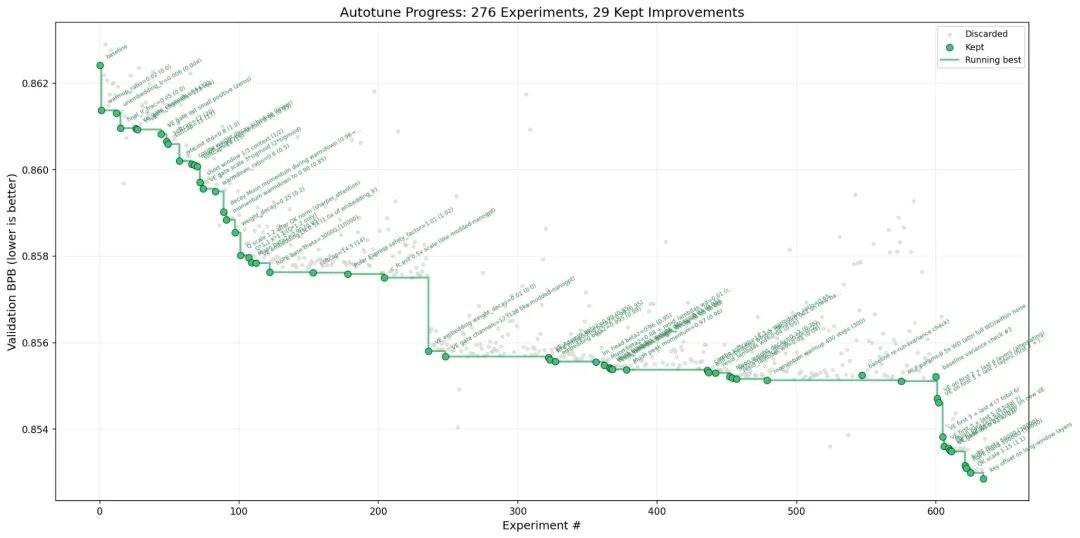
لقد استشهد بتجربة البحث الآلي التي بادر بها أندريه كارباثي كمثال. في هذه التجارب، استمر النموذج في إجراء عدد كبير من التجارب، وظل أداؤه في تحسن. حتى بعد مئات التجارب، لم تكن منحنيات التحسن هادئة تمامًا.
في الوقت نفسه، ذكر معهد أمن الذكاء الاصطناعي في المملكة المتحدة نتائج تقييم الأمان الشبكي الخاص به. في هذا التقييم، والذي شمل نماذج مثل Mythos و GPT-5.5، استمر أداء المهام في التحسن بعد استخدام أكثر من 100 مليون رمز (token).
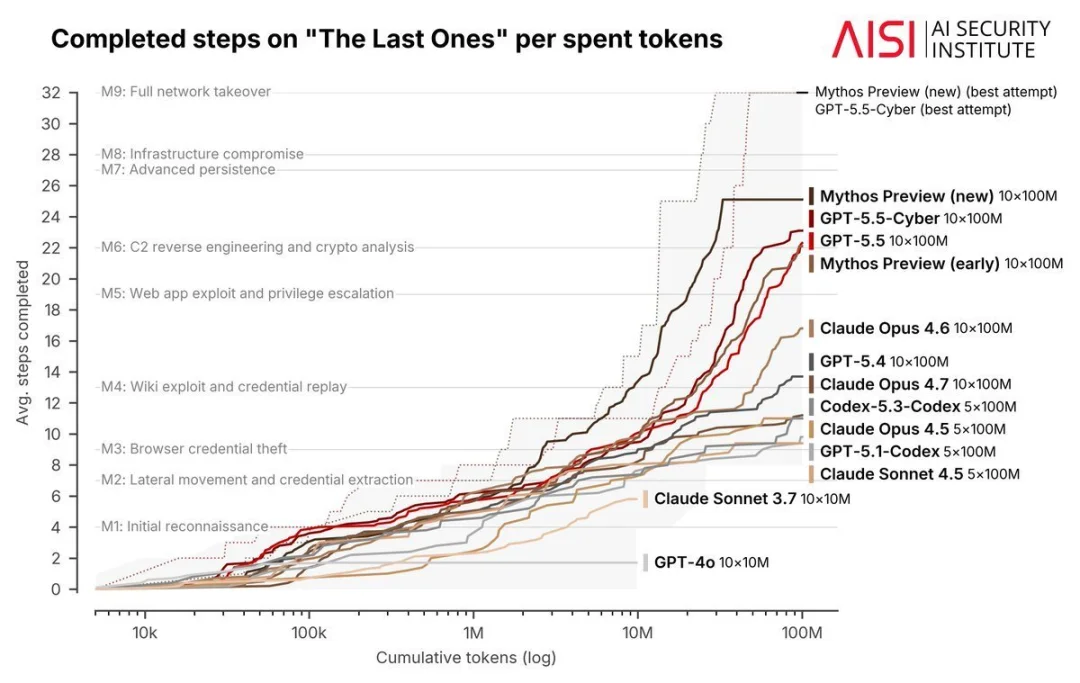
هذه الظاهرة تعني أن النماذج يمكنها استخدام وقت تشغيل أطول وميزانية تفكير أكبر، مما يسمح لها بالاستكشاف المستمر وتجربة وتصحيح الاستراتيجيات في المهام المعقدة. النماذج الأقوى لا تمتلك فقط نقطة بداية أعلى، ولكنها قد تكون أيضًا أكثر قدرة على تحويل الموارد الحسابية الإضافية إلى قدرات فعالة.
يُعتقد، وفقًا لبراون، أنه مع تحسن قدرات النماذج، ستزداد أيضًا الفترات الزمنية التي يمكن أن تعمل فيها بشكل فعال. في الماضي، كان من الممكن ملاحظة استقرار أداء النماذج ضمن ميزانيات محدودة نسبيًا؛ أما في المستقبل، فقد يتم تحقيق حدود أعلى للأداء. في بعض المهام، قد لا يعد ما يُسمى بـ "مرحلة الاستقرار" حالة يسهل قياسها.
من التركيز على درجة واحدة إلى التحول إلى "منحنى الأداء مقابل التكلفة"
في مواجهة هذا التغيير، يقترح براون أن تغير مؤسسات نشر النماذج طريقة عرض اختبارات المعايير الأساسية.
بدلاً من الإعلان عن درجة نهائية واحدة فقط، من الأفضل تحديد كمية الحسابات اللازمة للتنبؤ على المحور الأفقي، وعرض أداء المهمة على المحور الرأسي، مع رسم منحنى كامل لتغير الأداء. يمكن استخدام مؤشرات مثل عدد الرموز (tokens)، تكلفة التنبؤ، أو الوقت الفعلي للتشغيل كمعايير على المحور الأفقي.
يمكن لهذه الطريقة أن تجيب على الأسئلة التي يصعب تفسيرها في الجداول التقليدية للنتائج. على سبيل المثال، مع نفس الميزانية، أي النماذج أداؤه أفضل؟ عندما تزداد الميزانية عشرة أضعاف، أي النماذج يتحسن أسرع؟ هل النماذج قريبة من الحد الأقصى لقدراتها؟ كيف تتغير نسبة التكلفة إلى الفائدة للنماذج المختلفة؟
لقد بدأ استخدام طرق مماثلة بالفعل في بعض اختبارات المعايير. ذكر براون أن تقييم ARC-AGI يحاول قياس العلاقة بين درجات النماذج وتكاليف التشغيل، وليس فقط نشر درجة واحدة.
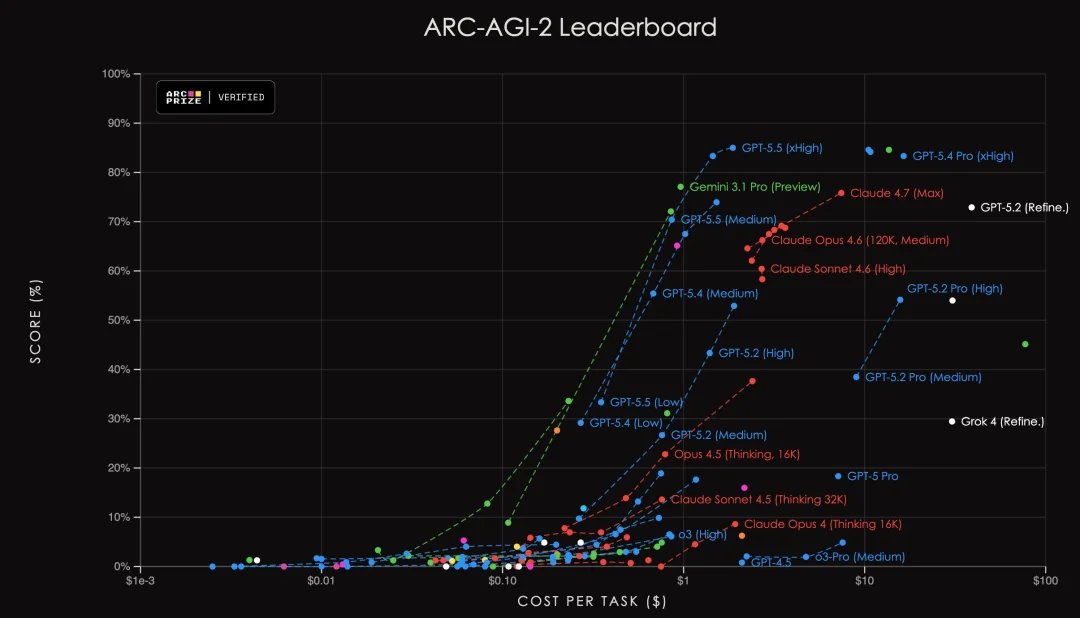
خيار آخر ممكن هو تحديد رموز معينة للخطة، أو قيود مالية، أو حدود زمنية للتقييم، وإبلاغ النماذج مسبقًا بمعلومات الميزانية. هذا الأسلوب يشبه الطريقة التي يخضع بها البشر للاختبارات الموحدة: سواء كانت اختبارات القبول في الجامعات الأمريكية مثل SAT، أو المسابقات الدولية في الرياضيات الأولمبية، حيث يحتاج المشاركون إلى إكمال المهام في وقت محدد. يمكن أيضًا مقارنة قدرات النماذج تحت قيود موحدة.
ومع ذلك، أشار براون أيضًا إلى أن المؤشرات المختلفة محدودة.
قد لا يكون من الممكن مقارنة الأعداد مباشرة بين النماذج المختلفة بسبب اختلافات في مقسمات الكلمات المستخدمة، وسرعة التوليد، والوحدات المستخدمة. قد تختلف تكاليف التوليد أيضًا. تتأثر التكاليف بمعدل استخدام الأجهزة، ومعالجة المجموعات الكبيرة من البيانات، وتنفيذ الهندسة. نظرًا لأن وقت التشغيل ليس مؤشرًا مثاليًا، فهو أيضًا ليس مؤشرًا مثاليًا. تقنيات مثل "التعاون بين العديد من العوامل الذكية" أو تقنيات الانتظار من أفضل الخيارات (best-of-N) يمكن أن تولد عدة إجابات محتملة بشكل متوازي، وقد لا تزيد بشكل كبير من وقت الانتظار الذي يشعر به المستخدم، ولكنها قد تزيد بشكل كبير من الحجم الإجمالي للحسابات.
على الرغم من ذلك، يعتقد أن أي من المؤشرات المذكورة أعلاه تحتوي على معلومات أكثر من مجرد درجة واحدة تتجاوز الميزانية المخصصة للتفكير الاستدلالي.
مشكلة الميزانية المتعلقة بالاستنتاج تتوسع الآن لتشمل تقييم أمان الذكاء الاصطناعي
النقاش حول Brown لا يقتصر فقط على قوائم النماذج؛ يعتقد أن ميزانية التفكير (الموارد المخصصة لعمليات الاستنتاج) ستؤثر أيضًا بشكل مباشر على إدارة الأمان للنماذج الرائدة.
قبل نشر نماذج الذكاء الاصطناعي المتقدمة، عادة ما تقوم المؤسسات البحثية والتطويرية بتقييم القدرات المحتملة على الاستغلال السيئ، مثل الهجمات الإلكترونية والمخاطر البيولوجية والكيميائية. إذا وصلت النماذج إلى عتبات معينة من المخاطر، قد تحتاج هذه المؤسسات إلى تأجيل النشر، أو إضافة تدابير تخفيفية مثل قيود الوصول وآليات المراقبة قبل النشر.
السؤال هو: إذا تحسنت قدرات النموذج مع زيادة حجم الحسابات التفسيرية، فكم يجب أن يكون ميزانية الاستدلال المستخدمة لتقييم الأمان؟
في الواقع، قد يستثمر المستخدمون العاديون بضعة دولارات أو عشرات الدولارات فقط في مهمة ما. ومع ذلك، قد تكون المنظمات ذات التمويل الوفير، أو الفرق المتخصصة، أو الجهات الوطنية المعنية على استعداد لاستثمار موارد أكبر بكثير من المستخدمين العاديين من أجل تحقيق هدف واحد. إذا قامت مؤسسات التقييم باختبار النماذج فقط ضمن ميزانيات محدودة، فقد تقلل من تقدير قدرتها على تحمل المخاطر في ظل ظروف موارد أكبر.
استخدم براون جدل ما تبع إطلاق نموذج Gemini 3 Deep Think كمثال. أشار إلى أن نتائج اختبارات الأداء الأساسية لنموذج Deep Think كانت أعلى بشكل ملحوظ من النماذج السابقة، لكن لم يتم توفير بطاقة النظام الكاملة في وقت الإطلاق لتقييم قدرة النموذج على تحمل المخاطر. أدى هذا الأمر إلى انتقادات من بعض الباحثين في مجال أمن الذكاء الاصطناعي.
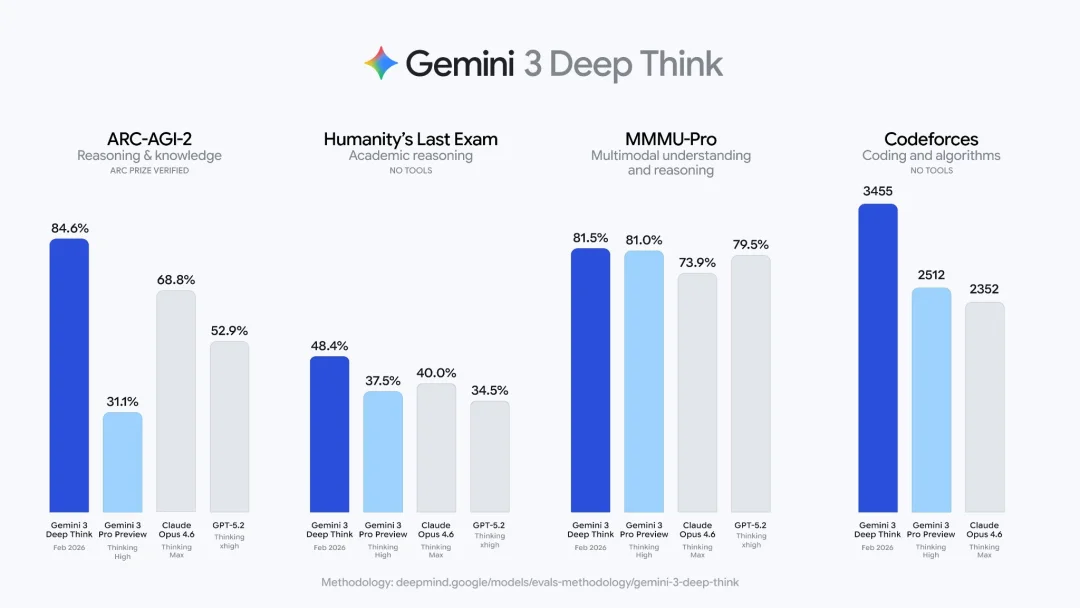
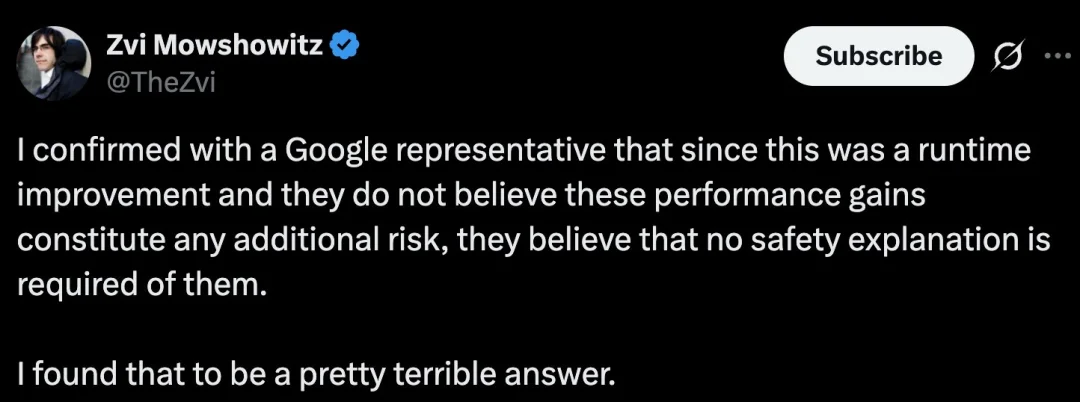
ومع ذلك، يبدو أن هناك مشكلة أعمق وراء جدل براون: لم تتمكن شركات الذكاء الاصطناعي والمؤسسات الأمنية بعد من تطوير طريقة موحدة لتقييم قدرات النماذج المختلفة استنادًا إلى ميزانيات التفكير المتاحة لديها.
يفترض أن Deep Think قد لا يكون نموذجًا جديدًا تم تدريبه بشكل مستقل تمامًا، بل هو نظام إطار عمل للتفكير يعتمد على نماذج قائمة أخرى. يمكن لهذا النظام تحسين أداء المهام المعقدة من خلال استدعاء النماذج عدة مرات، وتوليد النتائج المحتملة بشكل متوازي، وفحص الإجابات تلقائيًا، وإجراء التصحيحات التكرارية.
إذا تم إثبات هذا الافتراض، فمن الناحية النظرية، لا يمكن لمنصة Deep Think فقط تحقيق القدرات المعروضة، بل يمكن للمطورين الخارجيين أيضًا، طالما كانوا على استعداد لاستثمار جهد كبير في عمليات التفكير، دمج عدة نماذج لبناء سير عمل مماثلة. الدور الرئيسي لـ Deep Think هو تحويل عمليات التفكير المعقدة التي تتطلب مهارات تطوير متخصصة إلى منتجات يمكن للمستخدمين العاديين استخدامها بسهولة.
لذلك، يعتقد البعض في مجموعة Brown أن السؤال الحقيقي الذي يستحق الاهتمام ليس ما إذا تم إصدار البطاقة النظامية بشكل منفصل أم لا، بل ما إذا قامت مؤسسات البحث والتطوير باختبار القدرات التي كان من الممكن تحقيقها في النموذج الأساسي عند إصداره الأولي بشكل كامل، وذلك ضمن ميزانيات استدلال مختلفة واستراتيجيات مختلفة لبناء الأدوات اللازمة للتطوير.
تقييم الميزانيات العالية يصعب تنفيذه بشكل شامل، ولكن يمكن محاولة التعميم عليها.
نظريًا، قد يقوم كيان مزود بموارد وفيرة بإنفاق مبالغ أكبر تصل إلى عشرة ملايين دولار أمريكي على التفكير في مهمة واحدة. ومع ذلك، فإن عمليات تقييم الأمان عادة ما تتضمن آلاف أو حتى ملايين الاختبارات. إذا تم استخدام ميزانية عالية جدًا لكل عملية، فإن تكلفة التقييم ستصبح غير مجدية بسرعة.
اقترح براون أنه يمكن إجراء الاختبارات أولاً ضمن نطاق ميزانية التفكير النسبياً المحكم، ثم تحسين الأداء تحت ظروف ميزانية أعلى وفقاً لاتجاه تغير قدرات النموذج مع زيادة حجم الحسابات. في الوقت نفسه، يجب على الهيئات التقييمية تحديد نطاق التنبؤات ومستوى عدم اليقين بوضوح، بدلاً من اعتبار نتائج الحسابات كاستنتاجات نهائية مؤكدة.
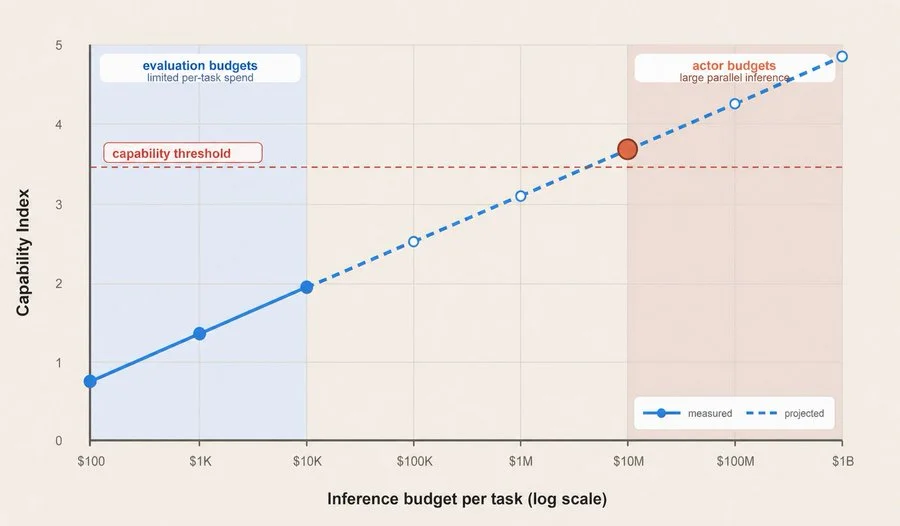
هذه الطريقة مشابهة لتقدير اتجاهات التغير في أنظمة أكبر حجمًا من خلال البيانات المحلية. لا يمكن أن تحل محل الاختبارات الفعلية، ولكنها يمكن أن تساعد المؤسسات البحثية والتطويرية والهيئات التنظيمية على فهم كيف قد تتغير حدود المخاطر عندما يتم منح النماذج المزيد من الوقت والأدوات والموارد الحاسوبية.
ومع ذلك، يعترف براون أيضًا بأن المهام طويلة الأجل قد تظل تطرح مشكلات لا يمكن حلها بسهولة من خلال التجارب قصيرة الأجل.
على سبيل المثال، إذا أراد الباحثون تحديد ما إذا كانت الكيانات الذكية المستقلة ستظهر انحرافات في الأداء، أو خداعاً استراتيجياً، أو سلوكيات غير متوافقة بعد تشغيلها لمدة عام كامل، فقد يكون الطريقة الأكثر موثوقية لا تزال هي السماح لهذه الكيانات الذكية بالعمل لفترة زمنية كافية. فقط استناداً إلى نتائج التجارب التي تستمر لبضع ساعات أو أيام، قد لا يكون من الممكن التقاط التغيرات الرئيسية في السلوك على المدى الطويل.
سينتج عن ذلك تناقض واقعي جديد: دورة تطوير وإطلاق نماذج الذكاء الاصطناعي قد تكون فقط بضعة أشهر، بينما قد تصبح دورات تشغيل الأجسام الذكية أطول وأطول. في المستقبل، قد تواجه مؤسسات البحث والتطوير حالة خاصة حيث تكون الجيل القادم من النماذج قريبًا من الإطلاق قبل أن تنتهي دورة تشغيلها القصوى.
ثلاثة اقتراحات: جعل ميزانية التفكير من المتغيرات الأساسية في تقييم النماذج
استجابةً للمشاكل المذكورة أعلاه في تقييم القدرات والحوكمة الأمنية، قدم براون ثلاثة اقتراحات محددة.
أولاً، عندما تصدر مؤسسات تطوير الذكاء الاصطناعي نماذج جديدة، يجب أن تعلن عن أداء الاختبارات الأساسية تحت ظروف ميزانيات التفكير المختلفة. من الناحية المثالية، يجب على الشركات تقديم منحنيات أداء تظهر عدد الرموز (tokens)، التكلفة، أو وقت التشغيل كمحاور أفقية. على الأقل، يحتاج الشركاء إلى شرح كم من موارد التفكير تم استخدامها فعليًا لتحقيق نتيجة معينة.
ثانيًا، يجب أن تسجل ترتيبات اختبارات الأداء استهلاك موارد التفكير الاستدلالي، أو أن تحدد حدودًا موحدة للرموز (tokens)، أو التكاليف، أو الوقت للنماذج المرجعية. حاليًا، تم تضمين بعض المعايير في عمليات التقييم، لكن لم تتشكل بعد ممارسات قياسية في هذا المجال.
ثالثًا، يجب أخذ موارد الحوسبة الخاصة بمرحلة استنتاج إطار الاستعداد لشركات الذكاء الاصطناعي (Preparedness Framework) وسياسة التوسع المسؤولة (Responsible Scaling Policy، RSP) في الاعتبار بشكل واضح. عندما تقرر المؤسسات ما إذا كان النموذج يتجاوز عتبة أمان معينة، يجب عليها ليس فقط فحص الأداء تحت إعداد واحد، ولكن أيضًا تقييم مستويات ميزانية الاستنتاج المتعددة، والتنبؤ بالقدرة على تحمل المخاطر تحت ظروف ميزانية أعلى.
لقد أدركت الصناعة هذه المشكلة بالفعل، ولكن نظام التقييم لم يواكب بعد بشكل كامل.
زيادة موارد الحوسبة في مرحلة التفكير يمكن أن تحسن أداء النموذج، وهذا ليس اكتشافًا جديدًا.
منذ أن أطلقت OpenAI نموذج التفكير o1 في سبتمبر 2024، اعتقد القطاع بشكل عام أن هذا النموذج يستخدم المزيد من خطوات التفكير عند الإجابة على الأسئلة، مما يمكن أن يؤدي إلى نتائج أفضل في المسائل الرياضية والكود ومهام التحليل المعقدة. وأصبحت الأبحاث المتعلقة بـ「قدرة النماذج الكبيرة على التوسع أثناء الاختبارات الحسابية» أو «قدرة التفكير الحسابي على التوسع» اتجاهًا مهمًا في تطوير النماذج الكبيرة.
لكن يُعتقد أنه بعد مرور ما يقرب من عامين على ظهور هذا الاتجاه، لا يزال إصدار العديد من النماذج المتطورة يعتمد بشكل أساسي على درجات معيارية واحدة للترويج والمقارنة بينها. كما يمكن لبعض الهيئات الأمنية أن تعيد النظر في حدود قدرات النماذج بعد استخدام ميزانيات تفكير تزيد بعشرات أو حتى مئات المرات في أنظمة الإطار العمل الخاصة بها.
مع تحسن النماذج بشكل مستمر في استخدام الموارد طويلة الأمد، وعمليات التجربة والخطأ المتعددة الجولات، والقدرة على المنطق على نطاق واسع، من المحتمل أن تستمر قدرات التفسير للقوائم التقليدية في الانخفاض. قد يظهر نفس النموذج الأساسي مستويات مختلفة تمامًا من الأداء في ظروف متنوعة مثل الأسئلة والأجوبة ذات الميزانية المنخفضة، والأبحاث المتعمقة ذات الميزانية العالية، والتعاون بين الذكاءات المتعددة، واستدعاء الأدوات الآلية.
الحكم الذي توصل إليه Brown هو أنه في المستقبل، عند قياس قدرات الذكاء الاصطناعي، يجب ألا يعتبر ميزانية التفكير مجرد معلومة مساعدة خلال عملية الاختبار، بل يجب أن تصبح معلمة أساسية في تقارير التقييم، مثل حجم النموذج، بيانات التدريب، ونافذة السياق.
ومن منظور أوسع، هذا يعني أيضًا أن صناعة الذكاء الاصطناعي تتخلى تدريجيًا عن مرحلة "تعريف النموذج برقم واحد". بالنسبة لتقييم القدرات، مقارنة المنتجات، وإدارة الأمان، السؤال الحقيقي المهم قد لا يكون فقط ما يمكن للنموذج القيام به، بل ما يمكنه القيام به عندما يحصل على الوقت الكافي، والتمويل، والموارد الحسابية.
المرجع: https://x.com/polynoamial/status/2064210146558136827
المؤلف من “قلب الآلة”، “تحرير قلب الآلة”.
هل كان هذا مفيدًا؟