Ilmuwan OpenAI Noam Brown: Batas Sejati AI Mungkin Tidak Bisa Diukur
Seiring dengan semakin banyaknya model bahasa besar yang digunakan untuk tugas-tugas yang kompleks seperti penalaran, penelitian otomatisasi, dan keamanan jaringan, metode penilaian model tradisional menghadapi tantangan baru.
Selama ini, peluncuran sebuah model biasanya disertai dengan tabel hasil yang terdiri dari berbagai jenis pengujian baseline, seperti matematika, pemrograman, pertanyaan ilmiah, keamanan jaringan, dan penalaran pengetahuan, serta dibandingkan secara horizontal dengan model generasi sebelumnya.
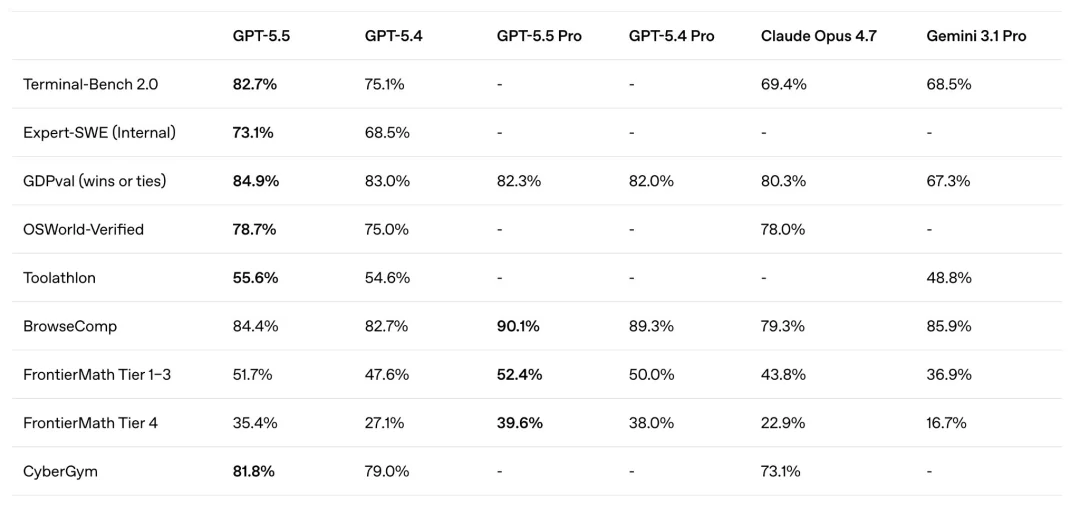
Peneliti OpenAI, Noam Brown, baru-baru ini menunjukkan dalam artikel tersebut bahwa ketika sebuah model menggunakan lebih banyak langkah penalaran, memanggil lebih banyak alat, atau melakukan pencarian dan pengujian yang lebih lama saat menjawab pertanyaan, skor tunggal semakin sulit untuk mencerminkan kemampuan sebenarnya dari model tersebut dengan akurat.
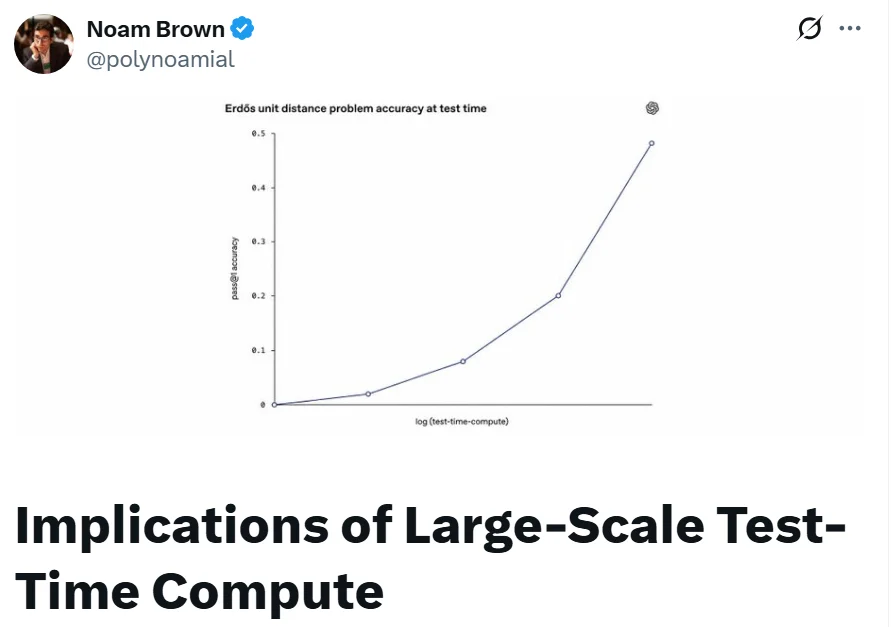
Poin utama Brown adalah sebagai berikut:Kinerja model besar tidak hanya ditentukan oleh model itu sendiri, tetapi juga oleh seberapa banyak sumber daya komputasi yang didapatkan model selama tahap penalaran.Dalam menilai model di masa depan, kita tidak hanya boleh bertanya “Berapa skor yang diperoleh model tersebut?”, tetapi juga harus menjawab pertanyaan lain: Berapa banyak token yang digunakan model, dan dengan biaya serta waktu eksekusi berapa, model tersebut mencapai skor tersebut?
Ia menyarankan agar industri beralih dari penilaian berdasarkan “skor tunggal” ke penilaian berdasarkan “kurva jumlah komputasi yang diperlukan untuk melakukan inferensi”, serta menganggap anggaran komputasi sebagai variabel dasar dalam penilaian kemampuan model dalam kebijakan keamanan kecerdasan buatan.
Laporan skor tradisional mungkin meremehkan perbedaan kemampuan antar model yang baru.
BrownGPT-5.5Sebagai contoh, respons pasar setelah produk dipasarkan menunjukkan keterbatasan dari sistem peringkat model tradisional.
Berdasarkan deskripsinya,GPT-5.5Pada tahap awal peluncuran, yang pertama kali diperhatikan oleh masyarakat adalah sekelompok hasil pengujian benchmark yang tidak terlalu menonjol.GPT-5.4Dibandingkan dengan model sebelumnya, skor dari model baru ini telah meningkat, namun jika dilihat dari tabel skor tradisional, peningkatannya tampaknya terbatas. Oleh karena itu, beberapa pengguna masih ragu-ragu atau bahkan meragukan versi baru ini.
Namun, dalam beberapa jam setelah model tersebut dibuka untuk umum, beberapa pengguna menemukan bahwa seiring dengan para pengembang dan peneliti mulai menguji tugas-tugas yang lebih kompleks, GPT-5.5 menunjukkan perbedaan yang lebih jelas antar generasi dalam hal penalaran berantai panjang, eksekusi berkelanjutan, dan penanganan masalah yang rumit. Brown berpendapat bahwa fenomena ini, di mana “pengalaman praktis meningkat secara signifikan, tetapi perubahan skor dalam daftar terbatas”, mencerminkan bahwa metode penilaian tradisional tidak sepenuhnya mampu menggambarkan kemampuan model tersebut.
Masalahnya adalah, hasil penilaian dari model-model yang berbeda mungkin tidak didasarkan pada anggaran penalaran yang sama.
Dalam kerangka penilaian tradisional, para peneliti sering memilih satu set konfigurasi pengujian untuk setiap model guna meningkatkan hasil sebanyak mungkin, kemudian menempatkan skor akhir mereka dalam tabel yang sama. Ini tampaknya adil, tetapi hal tersebut dapat menyembunyikan sebuah variabel penting: beberapa model mungkin dapat terus meningkatkan kinerjanya setelah mendapatkan lebih banyak token penalaran, lebih banyak kali pemanggilan, atau waktu eksekusi yang lebih lama; sementara model lain mungkin mencapai batas kinerja mereka lebih awal.
Kasus penilaian keamanan jaringan yang ditampilkan oleh Brown menunjukkan bahwa jika model-model tersebut hanya dibandingkan berdasarkan hasil akhir pada kondisi “menghitung jumlah maksimum selama pengujian”, keunggulan GPT-5.5 dibandingkan dengan GPT-5.4 mungkin tidak terlalu mencolok. Namun, jika jumlah token, biaya penalaran, atau waktu tunggu dapat dikendalikan pada tingkat yang sama, dan kemudian kinerja model-model yang berbeda diamati, peningkatan kemampuan GPT-5.5 akan menjadi lebih jelas.
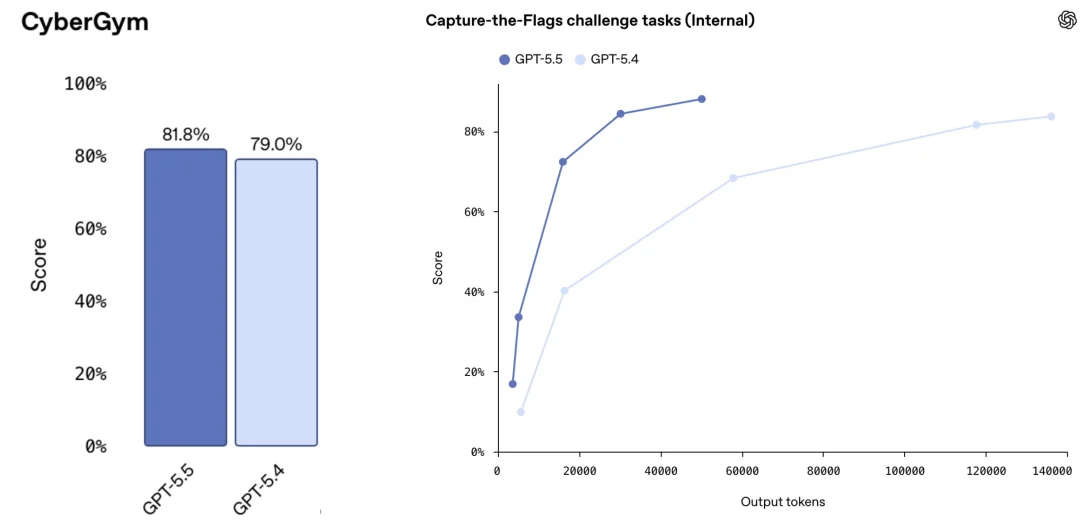
Dengan kata lain, perbedaan antar model tidak hanya terlihat pada skor akhir, tetapi juga pada efisiensi penggunaan sumber daya komputasi untuk penalaran tambahan.
Mengapa tidak bisa lebih sederhana? “Terus menambahkan sumber daya untuk proses penalaran hingga kinerja tidak lagi meningkat”
Solusi yang intuitif adalah terus meningkatkan sumber daya untuk setiap model hingga kinerjanya mencapai titik stabil (plateau), kemudian membandingkan kemampuan maksimalnya.
Brown berpendapat bahwa ide ini mungkin tidak praktis dalam penerapan nyata. Alasannya adalah untuk generasi model terbaru, titik kinerja stabil mungkin terjadi jauh lebih lambat dari yang diperkirakan, dan bahkan mungkin sulit untuk diamati dalam batas anggaran yang realistis.
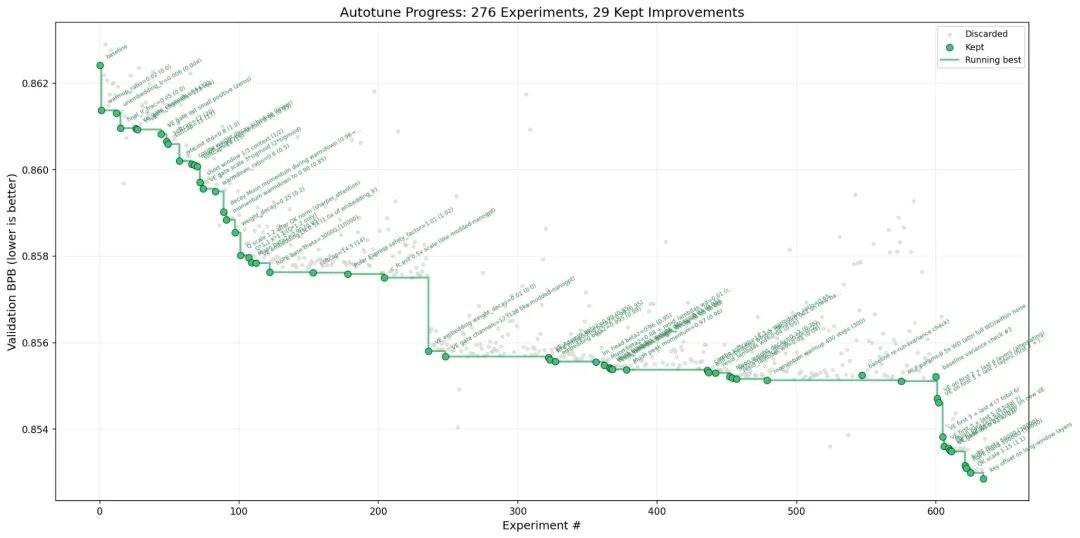
Dia mengutip sebagai contoh eksperimen penelitian otomatisasi yang diprakarsai oleh Andrej Karpathy. Dalam eksperimen tersebut, meskipun model terus menjalani banyak percobaan, kinerjanya masih menunjukkan tren peningkatan. Bahkan setelah ratusan percobaan dilakukan, kurva peningkatan tersebut tidak sepenuhnya stabil (tidak menunjukkan penurunan yang signifikan).
Brown juga menyebutkan hasil penilaian keamanan jaringan dari AI Security Institute di Inggris. Dalam penilaian tersebut, beberapa model, termasuk Mythos dan GPT-5.5, menunjukkan peningkatan kinerja setelah menggunakan lebih dari 100 juta token.
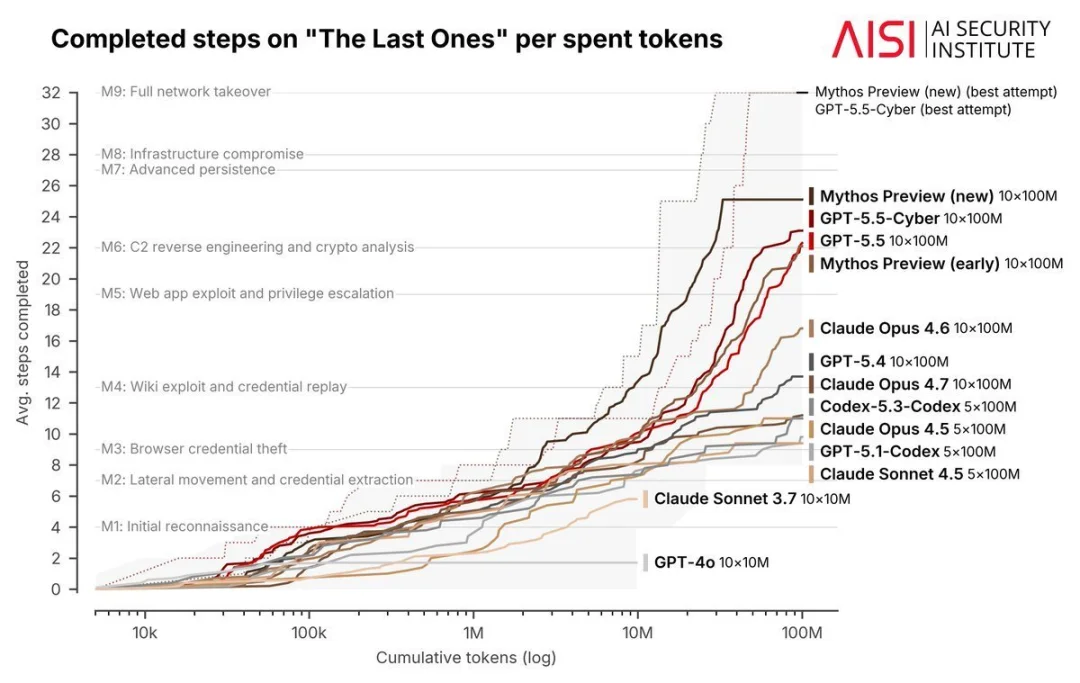
Phenomena ini menunjukkan bahwa model dapat memanfaatkan waktu eksekusi yang semakin lama dan anggaran penalaran yang semakin besar untuk terus-menerus mengeksplorasi, mencoba, dan memperbaiki strategi dalam tugas-tugas yang kompleks. Model yang lebih kuat tidak hanya memiliki titik awal yang lebih baik, tetapi juga mungkin lebih mahir dalam mengubah sumber daya komputasi tambahan menjadi kemampuan yang efektif.
Brown menduga bahwa seiring dengan peningkatan kemampuan model, periode waktu di mana model dapat beroperasi secara efektif juga akan memanjang. Di masa lalu, orang-orang mungkin mengamati bahwa kinerja model menjadi stabil dalam batasan anggaran yang relatif terbatas; di masa depan, batas kinerja tersebut mungkin akan semakin jauh. Dalam beberapa tugas, apa yang disebut “periode platform” mungkin bahkan tidak akan lagi menjadi kondisi yang mudah diukur.
Dari pendekatan berbasis skor tunggal, perlu beralih ke “kurva kinerja-kosakota”.
Menghadapi perubahan ini, Brown menyarankan bahwa lembaga penerbit model harus mengubah cara penyajian hasil pengujian dasar (benchmark testing).
Daripada hanya mengumumkan satu skor akhir, lebih baik menandai jumlah komputasi penalaran pada sumbu horizontal dan menampilkan kinerja tugas pada sumbu vertikal, serta menggambar kurva perubahan kinerja yang lengkap. Sumbu horizontal dapat menggunakan indikator seperti jumlah token, biaya penalaran, atau waktu eksekusi aktual.
Metode ini dapat menjawab pertanyaan-pertanyaan yang sulit dijelaskan dalam lembar nilai tradisional. Misalnya, dengan anggaran yang sama, model mana yang berkinerja lebih baik? Ketika anggaran meningkat sepuluh kali lipat, model mana yang berkembang lebih cepat? Apakah model tersebut mendekati batas kemampuannya? Bagaimana perubahan efisiensi biaya antar model?
Metode serupa sudah mulai digunakan dalam beberapa pengujian benchmark. Brown menyebutkan bahwa ARC-AGI berusaha mengukur hubungan antara skor model dan biaya pengoperasian model, bukan hanya menerbitkan satu skor saja.
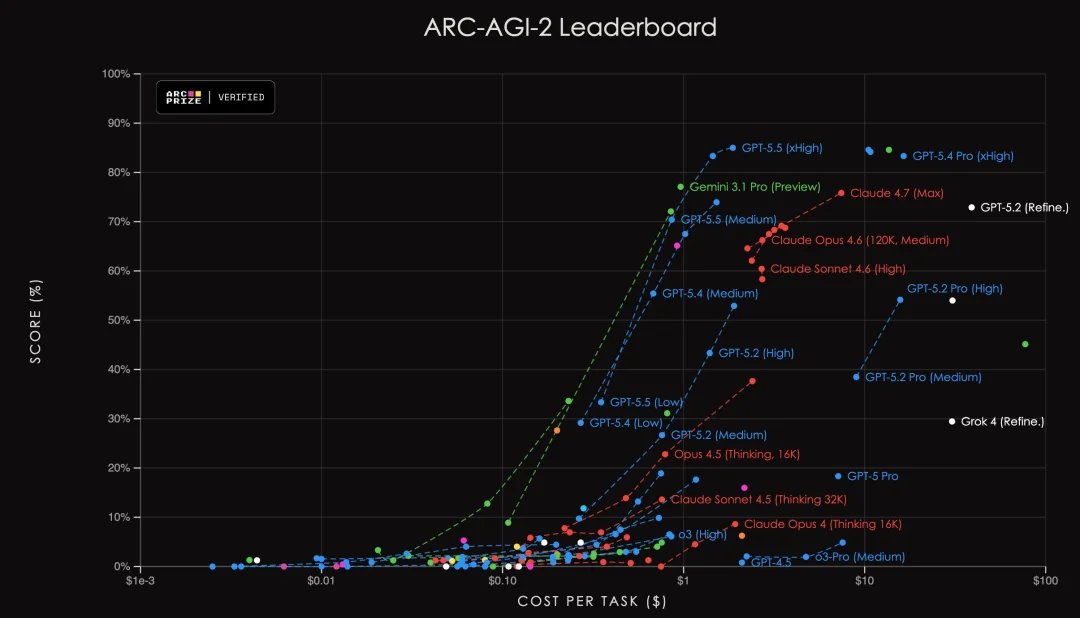
Solusi lain yang layak adalah dengan menetapkan token skema, batasan biaya, atau waktu yang jelas untuk penilaian, serta memberitahu model tentang informasi anggaran terlebih dahulu. Pendekatan ini mirip dengan ujian standar yang diikuti oleh manusia: baik itu Ujian Masuk Perguruan Tinggi Amerika (SAT) maupun Kompetisi Olimpiade Matematika Internasional, peserta perlu menyelesaikan tugas dalam waktu yang ditentukan. Kemampuan model juga dapat dibandingkan dalam batasan yang seragam.
Namun, Brown juga menunjukkan bahwa indikator-indikator yang tersedia terbatas.
Karena model-model yang berbeda menggunakan pemisah kata (tokenizer) yang berbeda, kecepatan generasi, dan satuan pengukuran yang berbeda, jumlah token mungkin tidak dapat dibandingkan secara langsung antar model. Biaya pembuatan token juga dapat bervariasi. Biaya tersebut dipengaruhi oleh tingkat penggunaan perangkat keras (hardware utilization), proses pemrosesan dalam batch, dan implementasi teknis. Karena waktu eksekusi (runtime) bukanlah indikator yang sempurna, maka waktu eksekusi juga tidak dapat dijadikan patokan yang akurat. Teknologi seperti “kolaborasi antar-agen cerdas” (multi-agent cooperation) atau pendekatan best-of-N dapat menghasilkan beberapa jawaban alternatif secara paralel, yang mungkin tidak akan secara signifikan meningkatkan waktu tunggu yang dirasakan oleh pengguna, namun akan meningkatkan total beban komputasi secara signifikan.
Meskipun demikian, dia berpendapat bahwa setiap indikator tersebut memberikan lebih banyak informasi daripada sekadar skor tunggal yang melebihi anggaran penalaran.
Masalah anggaran penalaran kini mulai diperluas ke dalam penilaian keamanan kecerdasan buatan.
Pembahasan Brown tidak terbatas hanya pada daftar model; dia juga berpendapat bahwa anggaran penalaran secara langsung mempengaruhi pengelolaan keamanan model-model terdepan.
Sebelum merilis model kecerdasan buatan terdepan, lembaga R&D biasanya menilai potensi penyalahgunaan model tersebut, seperti serangan siber, risiko biologis, dan risiko kimia. Jika model tersebut melebihi ambang batas risiko tertentu, lembaga R&D mungkin perlu menunda rilisnya, atau menambahkan langkah-langkah mitigasi seperti pembatasan akses dan mekanisme pemantauan sebelum penggunaan.
Pertanyaannya adalah, jika kemampuan model meningkat seiring dengan peningkatan jumlah komputasi yang digunakan untuk proses penalaran, berapa banyak anggaran penalaran yang seharusnya digunakan untuk melakukan penilaian keamanan?
Faktanya, pengguna biasa mungkin hanya akan menginvestasikan beberapa dolar atau puluhan dolar untuk satu tugas saja. Namun, sebuah organisasi yang memiliki dana cukup, tim profesional, atau aktor negara mungkin bersedia menginvestasikan sumber daya yang jauh lebih besar daripada pengguna biasa untuk tujuan yang sama. Jika lembaga penilaian hanya menguji model dengan anggaran yang rendah, mereka mungkin akan meremehkan kemampuan model tersebut dalam menghadapi kondisi dengan sumber daya yang lebih tinggi.
Brown menggunakan kontroversi yang muncul setelah peluncuran Gemini 3 Deep Think sebagai contoh. Ia menunjukkan bahwa hasil pengujian dasar Deep Think jauh lebih tinggi daripada model-model sebelumnya, namun saat diluncurkan, tidak disertakan kartu sistem yang lengkap untuk memenuhi persyaratan keamanan risiko dari versi tersebut. Pendekatan ini mendapat kritik dari beberapa peneliti keamanan kecerdasan buatan.
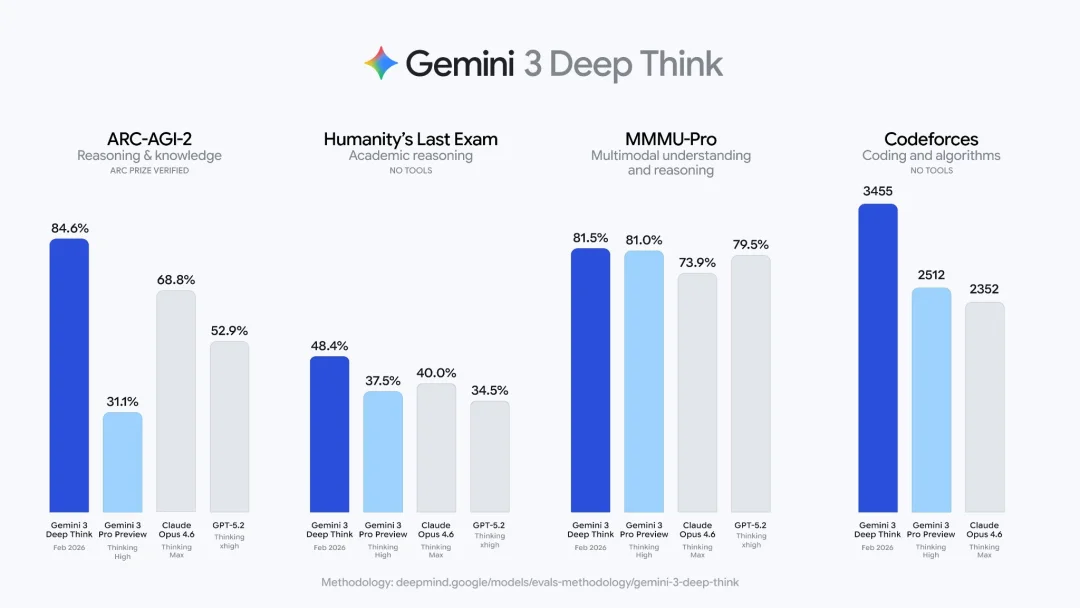
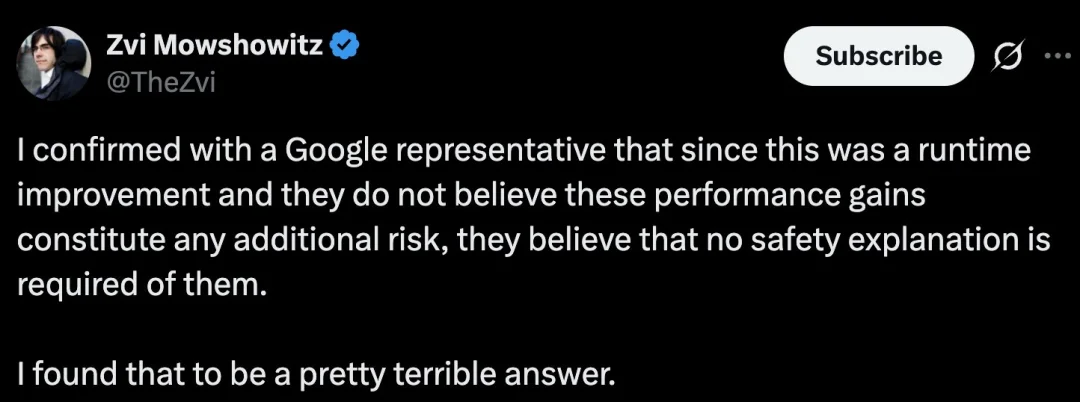
Namun, di balik kontroversi Brown tampaknya terdapat masalah yang lebih mendalam: perusahaan-perusahaan kecerdasan buatan dan lembaga keamanan belum menyusun metode yang stabil untuk menilai kemampuan model berdasarkan berbagai anggaran penalaran.
Ia menduga bahwa Deep Think mungkin bukanlah sebuah model yang dilatih secara independen sepenuhnya, melainkan sebuah sistem kerangka kerja inferensi (inference framework) yang berbasis pada model-model lain yang sudah ada. Sistem ini dapat meningkatkan kinerja tugas-tugas yang kompleks dengan cara memanggil model beberapa kali, menghasilkan beberapa kemungkinan jawaban secara paralel, memeriksa jawaban secara otomatis, dan melakukan perbaikan berulang-ulang.
Jika penilaian ini benar, maka secara teoritis, Deep Think tidak hanya dapat mewujudkan sebagian dari kemampuan yang ditampilkan oleh platform tersebut. Selama para pengembang eksternal bersedia menginvestasikan biaya penalaran yang cukup tinggi, mereka juga dapat menggabungkan beberapa model untuk membuat alur kerja yang serupa. Fungsi utama Deep Think adalah mengemas proses penalaran yang kompleks, yang biasanya memerlukan keahlian pengembangan khusus, menjadi produk yang dapat dengan mudah digunakan oleh pengguna biasa.
Oleh karena itu, menurut Brown dan rekan-rekannya, masalah yang sebenarnya perlu diperhatikan bukanlah apakah sistem kartu tersebut dirilis secara terpisah atau tidak, melainkan apakah lembaga penelitian dan pengembangan telah menguji sepenuhnya kemampuan dasar model tersebut sesuai dengan anggaran penalaran dan strategi pendukung yang berbeda, sebagaimana yang mungkin dicapai saat model tersebut pertama kali dirilis.
Penilaian dengan anggaran yang tinggi sulit untuk diimplementasikan secara menyeluruh, tetapi dapat dicoba dengan metode ekstrapolasi.
Secara teoritis, entitas yang memiliki sumber daya yang cukup mungkin akan menginvestasikan lebih dari satu juta dolar AS untuk biaya penalaran dalam satu tugas saja. Namun, penilaian keamanan biasanya melibatkan ribuan bahkan jutaan kali pengujian. Jika biaya per operasi sangat tinggi, biaya penilaian akan dengan cepat menjadi tidak layak secara finansial.
Brown mengusulkan untuk melakukan pengujian terlebih dahulu dalam batas anggaran penalaran yang relatif terkendali, kemudian meningkatkan kinerja dalam kondisi anggaran yang lebih tinggi sesuai dengan tren perubahan kemampuan model seiring dengan peningkatan jumlah komputasi. Pada saat yang sama, lembaga penilaian harus dengan jelas menandai kisaran prediksi dan tingkat ketidakpastiannya, bukan menganggap hasil perhitungan sebagai kesimpulan yang pasti.
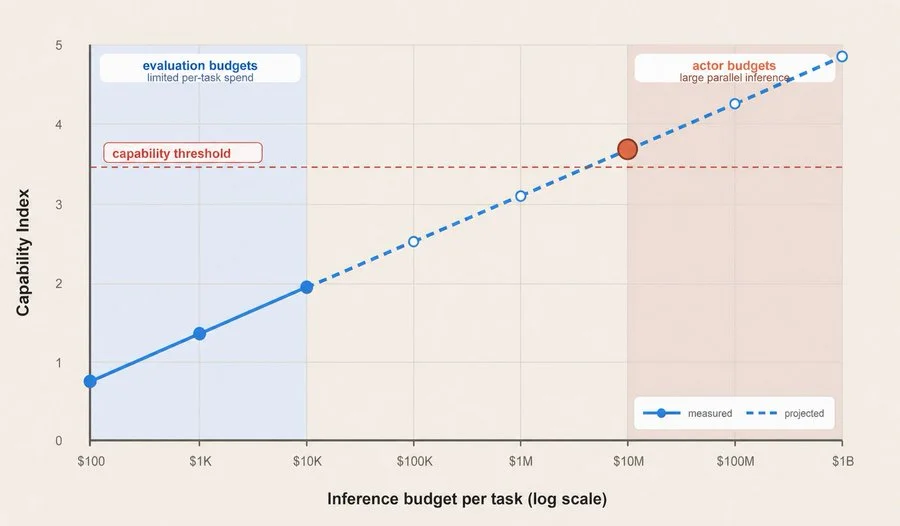
Metode ini mirip dengan memperkirakan tren perubahan pada sistem skala besar berdasarkan data lokal. Metode ini tidak dapat menggantikan pengujian aktual, tetapi dapat membantu lembaga pengembangan dan otoritas pengawas memahami bagaimana batasan risiko dapat berubah ketika model diberikan lebih banyak waktu, alat, dan sumber daya komputasi.
Namun, Brown juga mengakui bahwa tugas-tugas dengan jangka waktu yang panjang masih dapat menimbulkan masalah yang sulit diatasi oleh eksperimen jangka pendek.
Sebagai contoh, jika para peneliti ingin menentukan apakah sebuah entitas cerdas yang beroperasi secara mandiri akan mengalami penyimpangan tujuan, penipuan strategis, atau perilaku yang tidak sesuai setelah beroperasi selama satu tahun, maka metode yang paling dapat diandalkan mungkin masih dengan membiarkan entitas cerdas tersebut beroperasi selama waktu yang cukup lama. Berdasarkan hasil eksperimen yang hanya berlangsung selama beberapa jam atau hari, mungkin tidak akan dapat terdeteksi perubahan penting dalam perilaku jangka panjangnya.
Ini akan menciptakan kontradiksi baru dalam kenyataan: siklus pengembangan dan penerbitan model kecerdasan buatan mungkin hanya berlangsung selama beberapa bulan, sementara siklus tugas yang dapat dilakukan oleh tubuh cerdas dapat semakin lama. Di masa depan, lembaga penelitian dan pengembangan mungkin akan menghadapi situasi khusus di mana model generasi berikutnya hampir siap diterbitkan sebelum mereka mencapai siklus operasi maksimal mereka.
Tiga saran: menjadikan anggaran penalaran sebagai variabel dasar dalam penilaian model
Sebagai tanggapan terhadap masalah-masalah yang disebutkan di atas dalam penilaian kemampuan dan tata kelola keamanan, Brown mengusulkan tiga saran spesifik.
Pertama-tama, ketika lembaga penelitian dan pengembangan kecerdasan buatan merilis model baru, mereka harus mempublikasikan kinerja pengujian dasar (benchmark testing) dalam berbagai kondisi anggaran penalaran (reasoning budget). Idealnya, perusahaan harus menyediakan kurva kinerja yang menunjukkan jumlah token, biaya, atau waktu eksekusi sebagai sumbu horizontal. Setidaknya, perusahaan perlu menjelaskan berapa banyak sumber daya penalaran yang sebenarnya digunakan untuk mencapai hasil tertentu.
Kedua, peringkat pengujian dasar harus mencatat konsumsi sumber daya penalaran, atau menetapkan batasan yang seragam untuk token, biaya, atau waktu sebagai referensi bagi model-model lain. Saat ini, beberapa faktor penilaian telah dimasukkan ke dalam proses penilaian tersebut, tetapi industri ini belum memiliki praktik standar yang mapan.
Ketiga, sumber daya komputasi untuk tahap penalaran dari Kerangka Kerja Kesiapan (Preparedness Framework) perusahaan kecerdasan buatan dan Kebijakan Skalasi yang Bertanggung Jawab (Responsible Scaling Policy/RSP) harus dipertimbangkan dengan seksama. Ketika sebuah institusi menilai apakah suatu model telah melebihi ambang batas keamanan tertentu, tidak hanya kinerja dalam satu konfigurasi yang perlu diperiksa, tetapi juga berbagai tingkat anggaran penalaran harus dievaluasi, serta kemampuan menghadapi risiko dalam kondisi anggaran yang lebih tinggi perlu diprediksi dengan tingkat ketidakpastian yang tinggi.
Industri ini telah menyadari masalah ini, tetapi sistem penilaian belum sepenuhnya mengikuti perkembangan tersebut.
Menambahkan sumber daya komputasi pada tahap penalaran dapat meningkatkan kinerja model, dan ini bukanlah penemuan yang baru.
Sejak OpenAI merilis model penalaran o1 pada September 2024, industri secara umum berpendapat bahwa model tersebut menghabiskan lebih banyak langkah penalaran saat menjawab pertanyaan, sehingga dapat memberikan hasil yang lebih baik dalam tugas-tugas matematika, pemrograman, dan analisis yang kompleks. Penelitian tentang “skalabilitas saat pengujian komputasi” atau “skalabilitas saat penalaran komputasi” juga perlahan-lahan menjadi arah penting dalam pengembangan model besar.
Namun, menurut Brown, hampir dua tahun setelah tren ini muncul, banyak model canggih yang dirilis masih terutama disebarluaskan dan dibandingkan berdasarkan satu skor acuan saja. Beberapa lembaga keamanan juga dapat meninjau kembali batasan kemampuan model setelah menggunakan anggaran pemrosesan yang berlipat ganda, bahkan berlipat ratusan kali, pada sistem mereka.
Seiring dengan semakin mahirnya model dalam menggunakan proses yang berlangsung lama, metode percobaan dan kesalahan yang berulang-ulang, serta sumber daya pemrosesan skala besar, penjelasan yang diberikan oleh daftar tradisional mungkin akan terus menurun. Dalam berbagai kondisi, seperti pertanyaan dan jawaban dengan anggaran rendah, penelitian mendalam dengan anggaran tinggi, kolaborasi antar-intelijen, dan pemanggilan alat otomatis, model dasar yang sama dapat menunjukkan tingkat kemampuan yang sangat berbeda.
Brown berpendapat bahwa di masa depan, saat mengukur kemampuan kecerdasan buatan, anggaran untuk proses penalaran tidak boleh lagi dianggap sebagai informasi tambahan selama proses pengujian, melainkan harus menjadi parameter utama dalam laporan penilaian, termasuk skala model, data pelatihan, dan jendela konteks.
Dari perspektif yang lebih luas, ini juga berarti bahwa industri kecerdasan buatan sedang perlahan-lahan meninggalkan tahap di mana sebuah model didefinisikan hanya dengan satu angka. Dalam hal penilaian kemampuan, perbandingan produk, dan manajemen keamanan, pertanyaan yang benar-benar penting bukan hanya apa yang bisa dilakukan oleh sebuah model, tetapi apa yang bisa dilakukannya ketika model tersebut mendapatkan cukup waktu, dana, dan sumber daya komputasi.
Referensi tautan: https://x.com/polynoamial/status/2064210146558136827
Penulis berasal dari “Heart of Machine” dan “Editorial Department of Heart of Machine”.
Tautan artikel:https://airai.cc/id/ai-news/10/
Apakah ini membantu?