OpenAI-Wissenschaftler Noam Brown: Die wahre Obergrenze der KI kann sich niemand leisten
Mit dem zunehmenden Einsatz großer Sprachmodelle in anspruchsvollen Aufgaben wie komplexer Inferenz, automatisierter Forschung und Netzwerksicherheit stehen herkömmliche Methoden zur Bewertung von Modellen vor neuen Herausforderungen.
Seit langem werden Modelle veröffentlicht, zusammen mit Ergebnistabellen, die aus verschiedenen Benchmarks wie Mathematik, Programmierung, wissenschaftlichen Fragen und Antworten sowie Netzwerksicherheit bestehen, und diese werden mit den Ergebnissen der vorherigen Generationen verglichen.
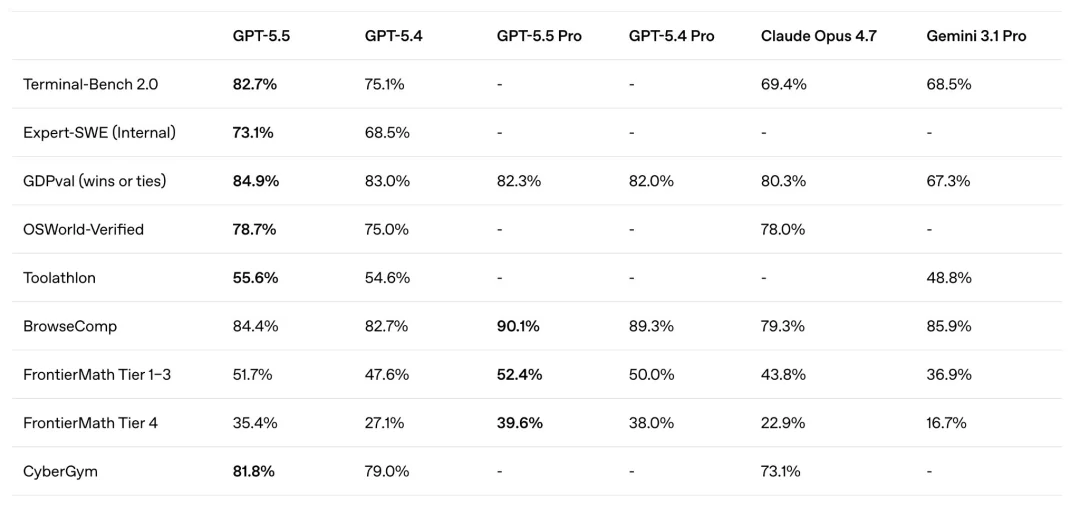
OpenAI-Forscher Noam Brown weist in einem kürzlich veröffentlichten Artikel darauf hin, dass es immer schwieriger wird, eine einzelne Bewertungsliste genau zu widerspiegeln, wenn Modelle bei der Beantwortung von Fragen mehr Schlussfolgerungsschritte einsetzen, mehr Werkzeuge aufrufen oder längere Such- und Testvorgänge durchführen.
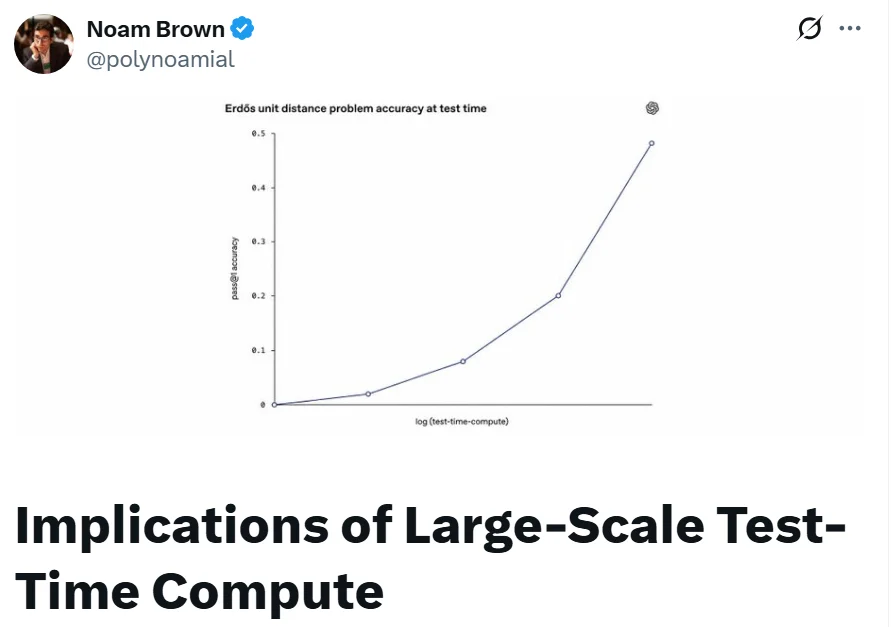
Die zentralen Punkte von Browns Argumentation sind folgende:Die Leistung großer Modelle hängt nicht nur vom Modell selbst ab, sondern auch davon, wie viele Rechenressourcen das Modell in der Schlussfolgerungsphase zur Verfügung hat.Bei der Bewertung von Modellen in der Zukunft sollten wir nicht nur fragen: „Wie viele Punkte hat das Modell erreicht?“, sondern auch eine weitere Frage beantworten: Wie viele Tokens hat das Modell verbraucht und zu welchen Kosten sowie bei welcher Laufzeit wurde dieses Ergebnis erzielt?
Er schlägt vor, dass die Branche den Schwerpunkt von den „einzelnen Leistungsindikatoren“ auf die „Leistung der Abfolge von Rechenvorgängen“ verlegen sollte und das Rechenbudget als grundlegende Variable für die Bewertung der Modellfähigkeiten in der Künstlichen Intelligenz-Sicherheitspolitik betrachten sollte.
Herkömmliche Bewertungssysteme könnten die Fähigkeitsunterschiede neuer Modelle unterschätzen.
Brown verwendet als Beispiel die Marktreaktionen nach der Veröffentlichung von GPT-5.5, um die Beschränkungen herkömmlicher Modell-Ranglisten aufzuzeigen.
Nach seiner Beschreibung,GPT-5.5Zu Beginn der Veröffentlichung fielen die Außenstehenden zunächst auf eine Reihe von nicht besonders auffälligen Benchmark-Ergebnissen auf.GPT-5.4Im Vergleich dazu hat die Punktzahl des neuen Modells zugenommen, aber aus der Sicht der traditionellen Punktzahlstabellen scheint die Steigerung begrenzt zu sein. Daher verhalten sich einige Nutzer gegenüber der neuen Version zurückhaltend oder sogar skeptisch.
Aber innerhalb weniger Stunden nach der Öffnung des Modells stellten einige Nutzer fest, dass GPT-5.5 bei der Durchführung langer Ketten von Schlussfolgerungen, der kontinuierlichen Ausführung und der Bearbeitung komplexer Probleme deutlichere Generationsschiede zeigte, als die Entwickler und Forscher begannen, anspruchsvollere Aufgaben zu testen. Brown ist der Ansicht, dass dieses Phänomen – bei dem die „praktische Erfahrung deutlich zugenommen hat, aber die Veränderungen in den Bewertungszahlen begrenzt sind“ – darauf hindeutet, dass herkömmliche Bewertungsmethoden nicht in der Lage sind, die Fähigkeiten des Modells vollständig zu erfassen.
Das Problem ist, dass die Bewertungsergebnisse verschiedener Modelle möglicherweise nicht auf dem gleichen Schlussfolgerungsbudget basieren.
In traditionellen Bewertungssystemen wählen Forscher oft eine Reihe von Testkonfigurationen für jedes Modell aus, um die Ergebnisse so gut wie möglich zu verbessern, und fügen die endgültigen Punktzahlen in eine einzige Tabelle ein. Dies scheint fair zu sein, kann aber einen wichtigen Faktor überdecken: Einige Modelle können ihre Leistung weiter deutlich steigern, indem sie mehr Rechentoken erhalten, häufiger aufgerufen werden oder länger laufen; andere Modelle erreichen möglicherweise bereits früher ihre Leistungsgrenze.
Die von Brown dargestellten Fälle zur Netzwerksicherheitsbewertung zeigen, dass, wenn die sogenannten Modelle nur miteinander verglichen werden, unter der Bedingung „Berechnung der maximalen Testmenge“ das Endresultat von GPT-5.5 im Vergleich zu GPT-5.4 nicht so auffällig sein könnte. Wenn jedoch die Anzahl der Tokens, die Rechenaufwand oder die Verzögerung auf dem gleichen Niveau gehalten werden und dann die Leistung der verschiedenen Modelle beobachtet wird, wird der Leistungsvorteil von GPT-5.5 deutlicher werden.
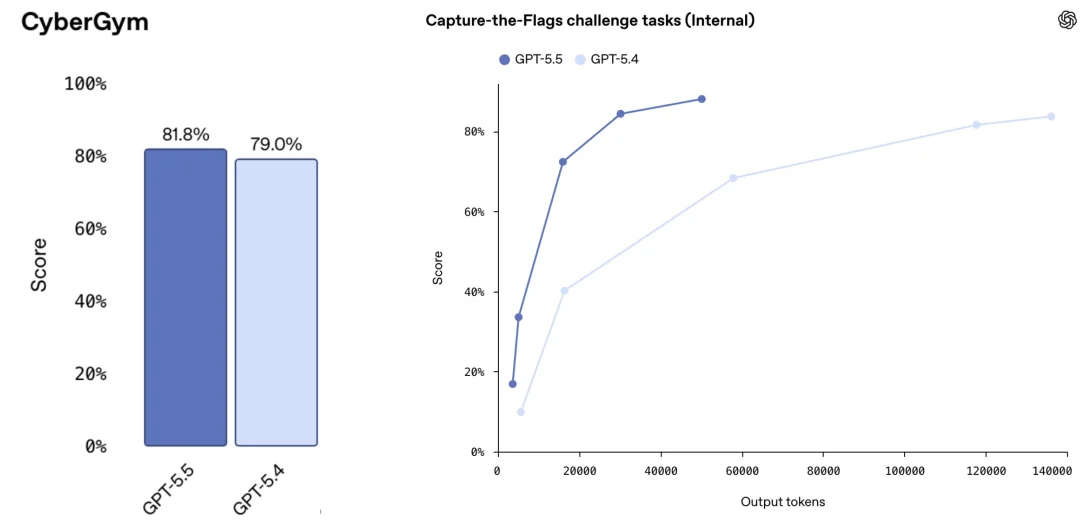
Mit anderen Worten, der Unterschied zwischen den Modellen zeigt sich nicht nur in den Endergebnissen, sondern auch in der Effizienz beim Einsatz zusätzlicher Rechenressourcen für die Verarbeitung.
Warum kann es nicht einfach sein? „So lange weitermachen, bis die Leistung nicht mehr verbessert wird“
Die intuitive Lösung wäre, weiterhin Ressourcen für die Verarbeitung der Modelle zu erhöhen, bis ihre Leistung ein Plateau erreicht, und anschließend ihre maximale Leistung zu vergleichen.
Brown ist der Ansicht, dass diese Vorgehensweise in der Praxis möglicherweise nicht umsetzbar ist. Der Grund dafür ist, dass bei neuen Generationen von Modellen das Leistungspotenzial oft viel später erreicht wird, als erwartet – und sogar innerhalb eines realistischen Budgets kaum erkennbar ist.
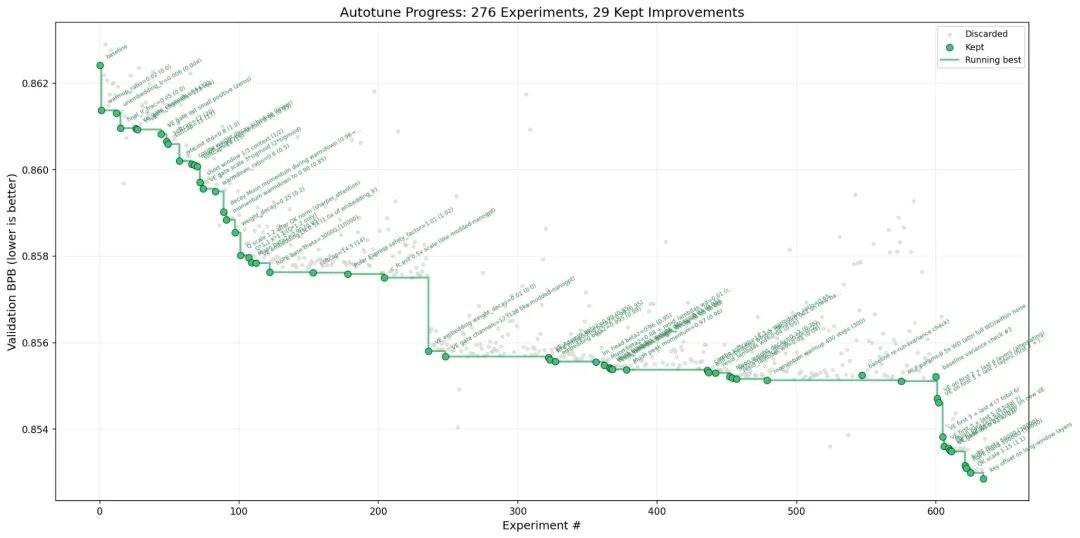
Er zitierte als Beispiel das von Andrej Karpathy initiierte Forschungsprojekt zur Automatisierung. In diesen Experimenten zeigte sich, dass das Modell auch nach zahlreichen weiteren Tests weiterhin eine Verbesserung seiner Leistung aufwies. Selbst nach Hunderten von Tests blieb die Kurve der Verbesserung nicht vollständig flach.
Brown erwähnte außerdem die Ergebnisse einer Netzwerk Sicherheitsbewertung des AI Security Institute in Großbritannien. In dieser Bewertung zeigten einige Modelle, darunter Mythos und GPT-5.5, nach dem Einsatz von insgesamt mehr als 100 Millionen Token weiterhin eine Verbesserung ihrer Leistung.
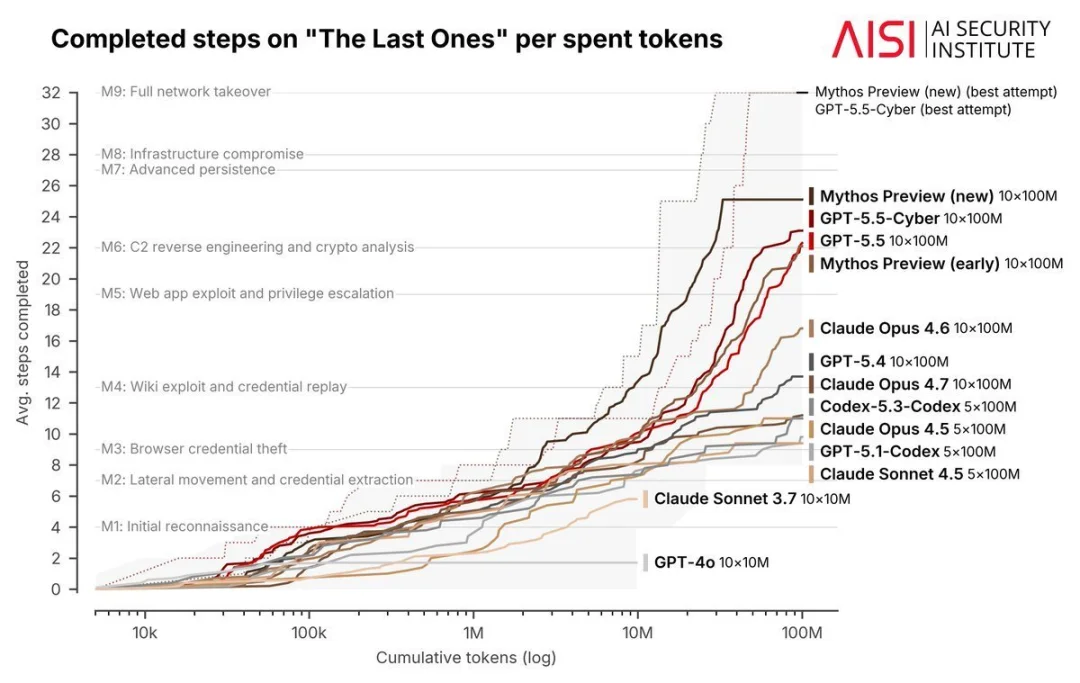
Dieses Phänomen bedeutet, dass Modelle mit zunehmender Laufzeit und einem größeren Rechenbudget in komplexen Aufgaben weiterhin Strategien erkunden, ausprobieren und korrigieren können. Stärkere Modelle verfügen nicht nur über einen besseren Ausgangspunkt, sondern sind möglicherweise auch besser darin, zusätzliche Rechenressourcen in effektive Leistung umzuwandeln.
Brown vermutet, dass sich mit der Steigerung der Modellfähigkeiten auch die Dauer der effektiven Arbeitszyklen verlängern wird. In der Vergangenheit konnten Menschen unter relativ begrenzten Budgetbedingungen beobachten, dass die Leistung der Modelle stabil wurde; in der Zukunft könnte die Leistungsobergrenze jedoch weiter hinausgeschoben werden. Bei bestimmten Aufgaben könnte der sogenannte „Plateau-Zustand“ sogar nicht mehr so leicht messbar sein.
Vom einzelnen Score zur „Leistung-Kosten-Kurve“
Angesichts dieser Veränderung schlägt Brown vor, dass die Modellveröffentlichungsorganisationen die Darstellung der Benchmarks ändern sollten.
Anstatt nur einen endgültigen Score zu veröffentlichen, wäre es besser, die Rechenbelastung der Inferenz auf der horizontalen Achse anzuzeigen und die Leistung der Aufgabe auf der vertikalen Achse darzustellen, sowie eine vollständige Kurve der Leistungsveränderung zu zeichnen. Für die horizontale Achse könnten Indikatoren wie die Anzahl der Tokens, die Rechenkosten oder die tatsächliche Laufzeit verwendet werden.
Diese Methode kann Fragen beantworten, die mit herkömmlichen Notenblättern schwer zu erklären sind. Zum Beispiel: Welches Modell performt besser bei gleicher Budgetierung? Wie schnell verbessert sich ein Modell, wenn das Budget um das Zehnfache erhöht wird? Nähert sich das Modell seiner Leistungsgrenze? Wie verändert sich die Kosteneffizienz der verschiedenen Modelle?
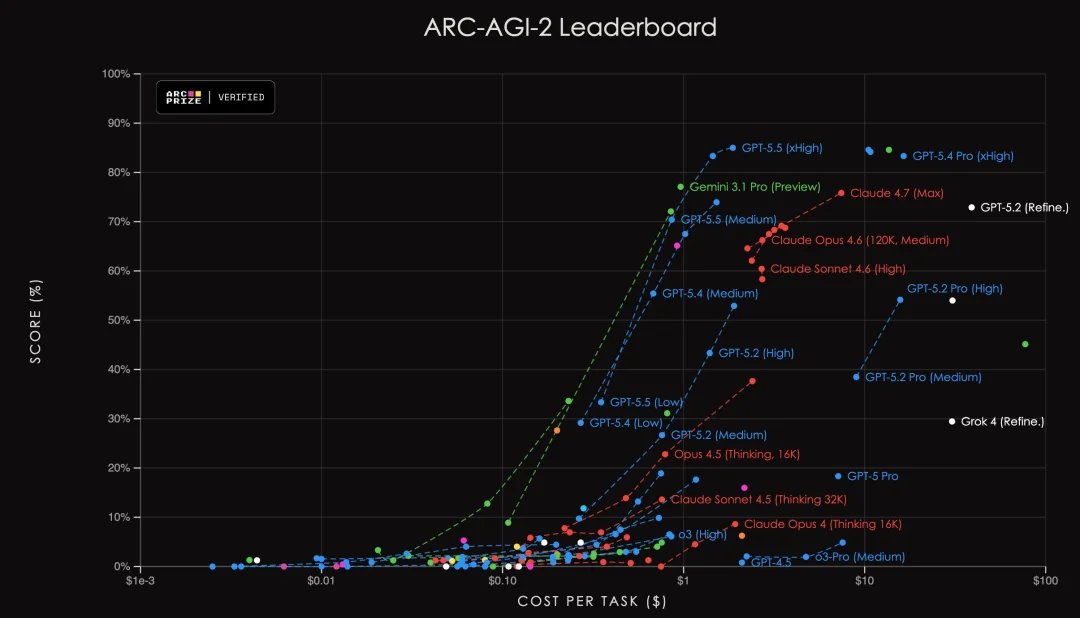
Ähnliche Methoden werden bereits in einigen Benchmarks eingesetzt. Brown erwähnt, dass die ARC-AGI-Bewertung versucht, das Verhältnis zwischen den Modellscores und den Betriebskosten zu messen, anstatt nur einen einzelnen Score zu veröffentlichen.
Eine weitere Möglichkeit besteht darin, klare Richtlinien für die Bewertung hinsichtlich von Token, Kosten oder Zeitbeschränkungen festzulegen und die Modelle im Voraus über die Budgetinformationen zu informieren. Dies ähnelt der Situation, in der Menschen an standardisierten Prüfungen teilnehmen – sei es der SAT für den Eintritt in amerikanische Universitäten oder die Internationale Mathematik-Olympiade, bei denen die Teilnehmer ihre Aufgaben innerhalb einer festen Zeit erledigen müssen. Auf diese Weise können die Fähigkeiten der Modelle auch unter einheitlichen Bedingungen verglichen werden.
Allerdings wies Brown auch darauf hin, dass die verschiedenen Indikatoren begrenzt sind.
Aufgrund der unterschiedlichen Tokenizer, Generierungsgeschwindigkeiten und Einheiten, die von verschiedenen Modellen verwendet werden, kann die Anzahl der Token nicht direkt zwischen den Modellen verglichen werden. Die Kosten für die Erzeugung von Token können variieren. Die Kosten hängen von der Auslastung der Hardware, der Batchverarbeitung und der Implementierung der Software ab. Da die Laufzeit kein perfekter Indikator ist, ist auch die Laufzeit nicht der beste Maßstab. Techniken wie „Mehragenten-Kooperation“ oder „Best-of-N“-Ansätze ermöglichen die parallele Erzeugung mehrerer Antwortoptionen, was nicht unbedingt zu einer signifikanten Verlängerung der Wartezeit für den Benutzer führt, aber gleichzeitig die Gesamtberechnungsleistung erheblich erhöht.
Trotzdem ist er der Ansicht, dass jeder der oben genannten Indikatoren aussagekräftiger ist als eine einzelne Zahl, die das Rechenbudget überschreitet.
Das Problem des Rechenbudgets erstreckt sich auf die Sicherheitsbewertung künstlicher Intelligenz.
Browns Diskussion beschränkt sich nicht auf die Liste der Modelle. Er ist der Meinung, dass das Rechenbudget auch die Sicherheitsverwaltung fortschrittlicher Modelle direkt beeinflusst.
Vor der Veröffentlichung fortschrittlicher KI-Modelle bewerten Forschungs- und Entwicklungsorganisationen in der Regel potenzielle Missbrauchsmöglichkeiten wie Netzwerkangriffe, biologische Risiken und chemische Gefahren. Wenn ein Modell einen bestimmten Risikowert erreicht, müssen die Organisationen die Veröffentlichung vielleicht verschieben oder vor der Bereitstellung Absicherungsmaßnahmen wie Zugriffsbeschränkungen und Überwachungssysteme ergreifen.
Die Frage ist: Wenn sich die Leistungsfähigkeit der Modelle mit zunehmender Rechenleistung verbessert, wie viel Rechenressourcen sollten dann für die Sicherheitsbewertung eingesetzt werden?
Tatsächlich werden durchschnittliche Nutzer für eine Aufgabe wahrscheinlich nur ein paar Dollar oder ein paar Dutzend Dollar investieren. Eine gut finanzierte Organisation, ein professionelles Team oder ein staatliches Akteur hingegen könnte bereit sein, für ein einzelnes Ziel deutlich mehr Ressourcen aufzuwenden als durchschnittliche Nutzer. Wenn Bewertungseinrichtungen Modelle nur mit niedrigen Budgets testen, könnten sie deren Risikofähigkeit unter Bedingungen mit hohen Ressourcen unterschätzen.
Brown nimmt die nach der Veröffentlichung von Gemini 3 Deep Think entstandenen Kontroversen als Beispiel. Er weist darauf hin, dass die Basistestergebnisse von Deep Think deutlich höher waren als die der vorherigen Modelle, jedoch bei der Veröffentlichung keine vollständigen Systemdokumentationen zur Verfügung gestellt wurden, um die Risikobewertung dieser Version zu unterstützen. Diese Vorgehensweise hat Kritik von Forschern auf dem Gebiet der KI-Sicherheit hervorgerufen.
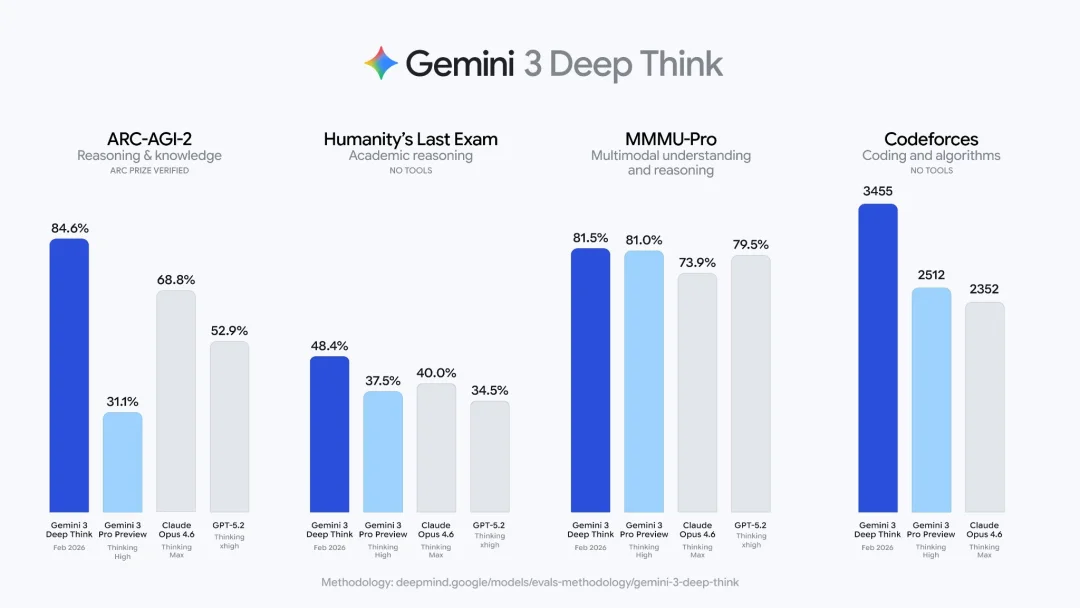
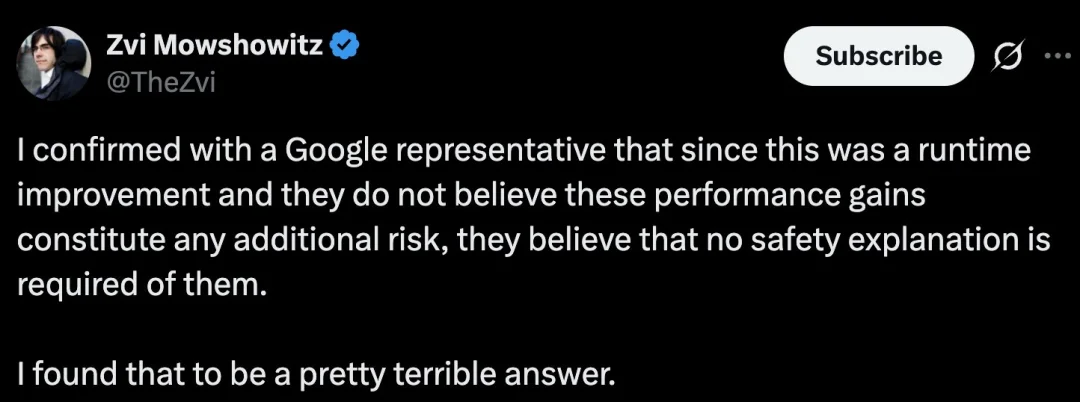
Hinter der Kontroverse um Brown scheinen jedoch noch tiefgreifendere Probleme zu stecken: KI-Unternehmen und Sicherheitsbehörden haben bisher keine einheitliche Methode entwickelt, um die Fähigkeiten von Modellen unter verschiedenen Rechenressourcenbedingungen zu bewerten.
Er vermutet, dass Deep Think möglicherweise kein völlig unabhängig trainiertes neues Modell ist, sondern ein Infrastruktur-System für das Schlussfolgern, das auf anderen bestehenden Modellen basiert. Dieses System kann die Leistung bei komplexen Aufgaben verbessern, indem es das Modell mehrmals aufruft, parallel alternative Ergebnisse erzeugt, automatisch Antworten überprüft und diese iterativ anpasst.
Wenn diese Annahme zutrifft, dann könnte Deep Think theoretisch nicht nur die von der Plattform selbst dargestellten Funktionen umsetzen. Solange externe Entwickler bereit sind, einen ausreichend hohen Aufwand in die Rechenprozesse zu investieren, können sie auch mehrere Modelle kombinieren, um ähnliche Arbeitsabläufe zu erstellen. Die Hauptfunktion von Deep Think besteht darin, komplexe Rechenprozesse, die normalerweise spezielle Entwicklungskenntnisse erfordern, in eine Form zu packen, die auch für normale Benutzer einfach nutzbar ist.
Daher glauben die Leute von Brown, dass die wirklich wichtige Frage nicht darin besteht, ob das System-Card als eigenständiges Produkt veröffentlicht wurde, sondern ob die Entwicklungsorganisationen die Leistungsfähigkeit des Basismodells, die bei seiner ersten Veröffentlichung möglich war, unter verschiedenen Rechenbudgets und Strategien für die Entwicklung von Hilfsmitteln („Scaffolding“) ausreichend getestet haben.
Eine umfassende Bewertung mit hohen Budgets ist schwierig umzusetzen, aber es kann versucht werden, Schlussfolgerungen zu ziehen.
Theoretisch könnte eine gut ausgestattete Organisation mehrere Millionen US-Dollar in die Rechenleistung für eine einzelne Aufgabe investieren. Sicherheitsbewertungen hingegen umfassen oft Tausende oder sogar Millionen von Tests. Wenn für jeden Test ein sehr hohes Budget aufgewendet wird, wird die Bewertungskosten schnell unrentabel.
Brown schlägt vor, zunächst innerhalb eines relativ kontrollierbaren Rechenbudgets Tests durchzuführen und anschließend die Leistung unter höheren Budgetbedingungen anhand der Entwicklung der Modellfähigkeit mit der Veränderung der Rechenkapazität zu verbessern. Gleichzeitig sollten die Bewertungseinrichtungen die Vorhersagebereiche und Unsicherheiten klar kennzeichnen, anstatt die Rechenergebnisse als endgültige Schlussfolgerungen zu betrachten.
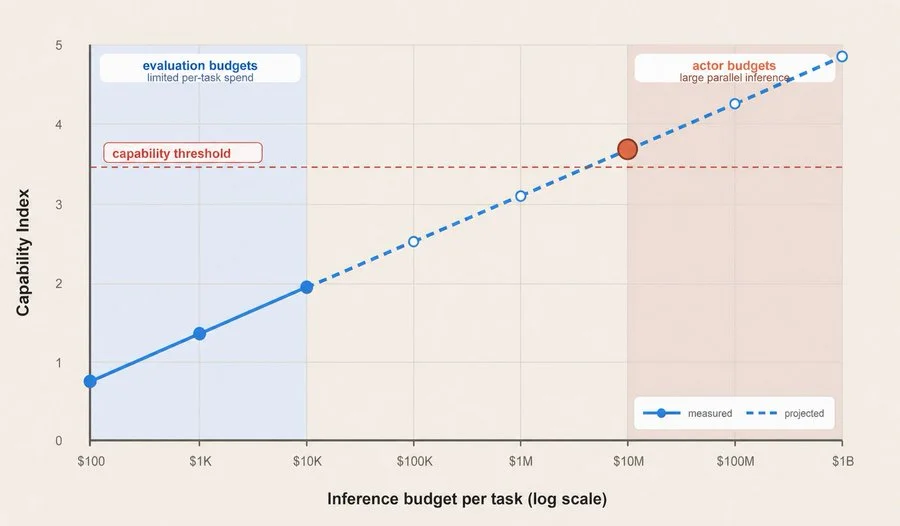
Diese Methode ähnelt der Schätzung von Veränderungstrends in größeren Systemen anhand lokaler Daten. Sie kann die tatsächlichen Tests nicht ersetzen, aber sie kann Entwicklungseinrichtungen und Regulierungsbehörden dabei helfen zu verstehen, wie sich die Risikogrenzen ändern könnten, wenn den Modellen mehr Zeit, Werkzeuge und Rechenressourcen zur Verfügung gestellt werden.
Allerdings räumt Brown auch ein, dass langfristige Aufgaben Probleme aufwerfen können, die mit kurzfristigen Experimenten nicht gelöst werden können.
Beispielsweise könnte es der zuverlässigste Weg sein, einen unabhängigen intelligenten Agenten tatsächlich über einen längeren Zeitraum laufen zu lassen, wenn Forscher herausfinden wollen, ob dieser nach einem Jahr Betrieb Zielabweichungen, strategische Täuschungen oder andere unangemessene Verhaltensweisen zeigt. Basierend auf Ergebnissen von nur ein paar Stunden oder Tagen könnte es nicht möglich sein, wesentliche Veränderungen im langfristigen Verhalten zu erkennen.
Dies wird zu einem neuen Widerspruch in der Realität führen: Die Entwicklungs- und Veröffentlichungszyklen von KI-Modellen könnten nur wenige Monate betragen, während die Zyklen der Aufgaben, die von intelligenten Körpern ausgeführt werden, immer länger werden. In der Zukunft könnten Forschungseinrichtungen mit einer besonderen Situation konfrontiert sein – die nächste Generation von Modellen könnte bereits kurz vor der Veröffentlichung sein, bevor sie ihren maximalen Betriebszyklus abgeschlossen hat.
Drei Vorschläge: Den Reasoning-Budget als grundlegende Variable für die Modellbewertung einsetzen
Angesichts der oben genannten Probleme bei der Fähigkeitsbewertung und der Sicherheitsverwaltung hat Brown drei konkrete Vorschläge gemacht.
Zunächst sollten KI-Forschungseinrichtungen bei der Veröffentlichung neuer Modelle die Basistestleistungen unter verschiedenen Rechenbudgetbedingungen veröffentlichen. Idealerweise sollten Unternehmen Leistungskurven auf der horizontalen Achse anhand der Anzahl der Tokens, der Kosten oder der Laufzeit bereitstellen. Mindestens sollten die Unternehmen erklären, wie viele Rechenressourcen tatsächlich für die Erreichung der einzelnen Ergebnisse verwendet wurden.
Zweitens sollten die Basistest-Rankings die Verbrauchsanalyse der Rechenressourcen erfassen oder einheitliche Grenzwerte für Tokens, Kosten oder Zeit für die Referenzmodelle festlegen. Derzeit wurden einige Bewertungskriterien bereits in die entsprechenden Variablen einbezogen, aber es gibt noch keine standardisierten Praktiken in der Branche.
Drittens sollten die Rechenressourcen für die Phase der Schlussfolgerung des Bereitschaftsrahmens (Preparedness Framework) sowie der verantwortungsvollen Skalierungsrichtlinie (Responsible Scaling Policy, RSP) von KI-Unternehmen ausdrücklich berücksichtigt werden. Wenn eine Institution beurteilt, ob ein Modell bestimmte Sicherheitsgrenzen überschreitet, muss nicht nur die Leistung bei einer einzelnen Konfiguration überprüft werden, sondern auch die Risikofähigkeit bei verschiedenen Budgetniveaus bewertet und Unsicherheiten vorhergesagt werden.
Die Branche ist sich dieses Problems bereits bewusst, aber die Bewertungssysteme haben noch nicht ganz Schritt gehalten.
Die Bereitstellung zusätzlicher Rechenressourcen in der Schlussfolgerungsphase kann die Leistung des Modells verbessern – das ist keine neue Erkenntnis.
Seit OpenAI im September 2024 das o1-Modell dieser Reihe von Inferenzmodellen veröffentlicht hat, gilt allgemein in der Branche, dass dieses Modell mehr Inferenzschritte bei der Beantwortung von Fragen einsetzt und bessere Ergebnisse in Bereichen wie Mathematik, Programmierung und komplexen Analyseaufgaben erzielt. Die Forschung zu „Erweiterbarkeit bei der Berechnung von Tests“ oder „Erweiterbarkeit bei der Berechnungsinferenz“ hat sich ebenfalls zu einer wichtigen Entwicklungrichtung für Großmodelle entwickelt.
Aber Brown ist der Ansicht, dass auch fast zwei Jahre nach dem Auftreten dieser Entwicklung die Verbreitung und Vergleichung vieler fortschrittlicher Modelle immer noch hauptsächlich auf einer einzigen Basisscore-Bewertung beruht. Einige Sicherheitsbehörden könnten nach der Verwendung von Rechenressourcen, die sich um das Zehnfache oder sogar Hundertfache des üblichen Betrags erstrecken, die Grenzen der Leistungsfähigkeit der Modelle erneut überprüfen.
Mit zunehmender Fähigkeit der Modelle, langfristige Prozesse durchzuführen, mehrere Iterationen des Trial-and-Error-Verfahrens zu nutzen und Ressourcen für groß angelegte Berechnungen einzusetzen, könnte die Qualität der Erklärungen durch traditionelle Listen weiter abnehmen. Unter verschiedenen Bedingungen – wie bei Fragen und Antworten mit niedrigem Budget, tiefgehenden Forschungen mit hohem Budget, der Zusammenarbeit mehrerer Intelligenzen sowie der automatischen Ausführung von Tools – kann derselbe grundlegende Modell völlig unterschiedliche Leistungsniveaus aufweisen.
Brown argumentiert, dass bei zukünftigen Messungen der Künstlichen Intelligenz die Schlussfolgerungsressourcen (Inference Resources) nicht länger als unterstützende Informationen im Testprozess angesehen werden sollten, sondern zu einem Kernparameter in den Bewertungsberichten werden müssen – genauso wie die Modellgröße, die Trainingsdaten und das Kontextfenster.
Aus einer breiteren Perspektive gesehen bedeutet dies auch, dass die KI-Industrie allmählich die Phase verlässt, in der ein Modell durch eine einzige Zahl definiert wird. Für die Bewertung von Fähigkeiten, den Vergleich von Produkten und die Sicherheitsverwaltung sind die wirklich wichtigen Fragen vielleicht nicht nur, was ein Modell kann, sondern vielmehr, was es tun kann, wenn es über ausreichend Zeit, finanzielle Mittel und Rechenressourcen verfügt.
Referenzlink: https://x.com/polynoamial/status/2064210146558136827
Der Autor stammt von „Heart of Machine“ und der „Redaktion von Heart of Machine“.
Artikellink:https://airai.cc/de/ai-news/10/
War das hilfreich?