OpenAI科学家Noam Brown:AI的真正上限,可能根本没人测得起
随着大语言模型逐渐进入复杂的推理、自动化研究和网络安全等困难任务,传统的模型评价方法正面临着新的挑战。
长期以来,模型发布往往伴随着由数学、编程、科学问答、网络安全、知识推理等多种基准测试组成的结果表,并与上一代模型进行水平比较。
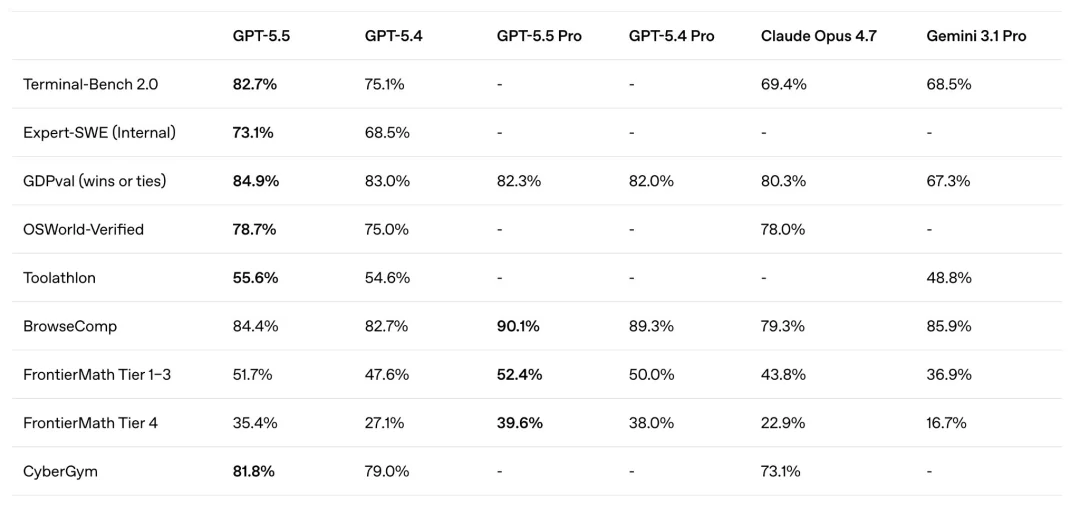
OpenAI 研究员 Noam Brown 最近,该文章指出,当模型在回答问题时使用更多的推理步骤、调用更多的工具或执行更长时间的搜索和测试时,单一分数越来越难以准确反映模型的实际能力。
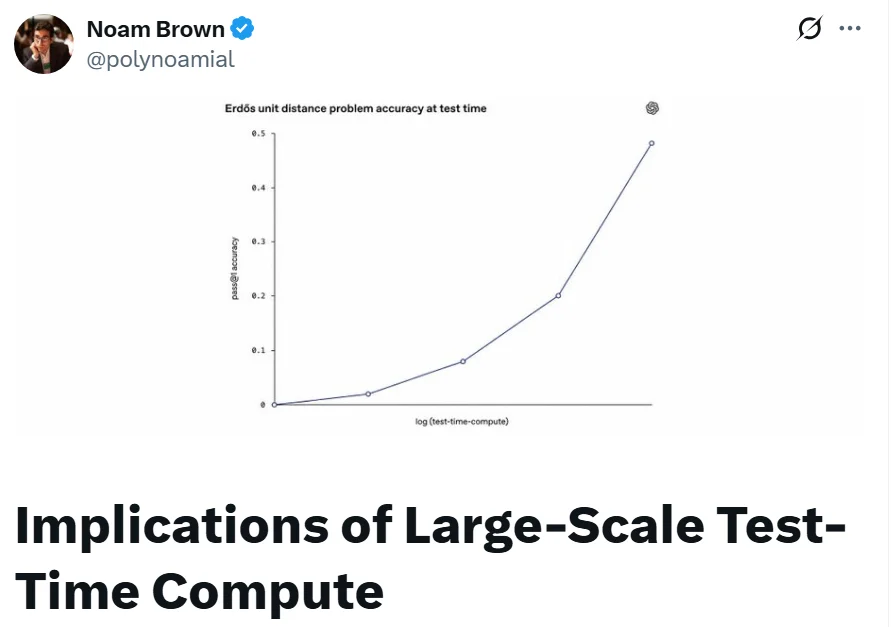
Brown 核心观点如下:大模型的性能不仅取决于模型本身,还取决于模型在推理阶段获得了多少计算资源。在未来评估模型时,我们不能只问「模型得了多少分?」,还应该回答另一个问题:模型消耗了多少 token、在多少成本和运行时间的前提下,取得这一成绩?
他建议行业应该从头开始「单点成绩」转向「推理计算量曲线的性能」,并将推理预算视为人工智能安全政策中的模型能力评估和基本变量。
传统成绩表可能低估新模型的能力差距
Brown 以 GPT-5.5 以发布后的市场反应为例,说明了传统模型排名的局限性。
按照他的描述,GPT-5.5 在发布初期,外界首先注意到的是一组不是特别显眼的基准测试结果。以及 GPT-5.4 相比之下,新模型的分数有所提高,但从传统的分数表来看,提高幅度似乎有限。因此,一些用户对新版本持观望甚至质疑态度。
但在模型开放后的几个小时内,一些用户发现,随着开发者和研究人员开始测试更复杂的任务,GPT-5.5 在长链推理、持续执行和处理复杂问题方面表现出更明显的代际差异。Brown 认为,这种「实际经验明显增强,但名单分数变化有限」这种现象反映了传统评价没有完全呈现模型的能力。
问题是,不同模型的评估结果可能不是基于相同的推理预算。
在传统的评价框架中,研究人员经常为每个模型选择一套测试配置,以尽可能提高结果,然后将最终分数放在同一表中。这似乎是公平的,但它可能会掩盖一个关键变量:一些模型可以得到更多的推理 token、更多的调用次数或更长的运行时间后,继续显著提高性能;其他模型可能更早达到性能上限。
Brown 显示的网络安全评估案例表明,如果所谓的所谓模型只比较每个模型,「计算最大测试时的量」条件下的最终结果,GPT-5.5 相较 GPT-5.4 优势可能不突出。但如果是的话 token 将数量、推理成本或延迟控制在同一水平,然后观察不同模型的性能,GPT-5.5 能力提升会更加明显。
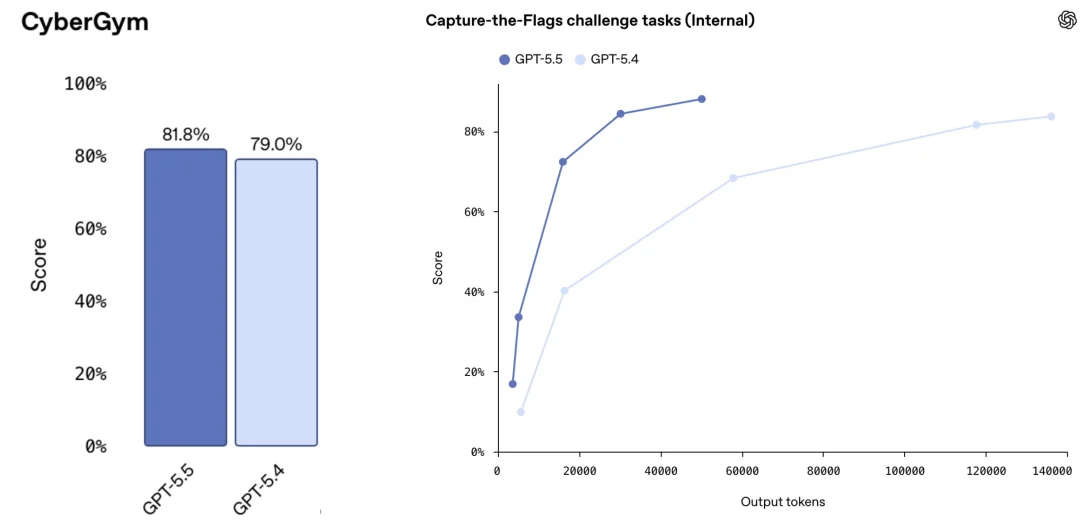
换句话说,模型之间的差距不仅体现在最终分数上,也体现在使用额外推理计算量的效率上。
为什么不能简单?「跑到性能不再提高为止」
直观的解决方案是继续为每个模型增加推理资源,直到其性能进入平台期,然后比较其最高能力。
Brown 认为这种想法在实践中可能不可行。原因是对于新一代模型来说,性能平台期可能比预期晚得多,甚至在实际可承受的预算范围内难以观察。
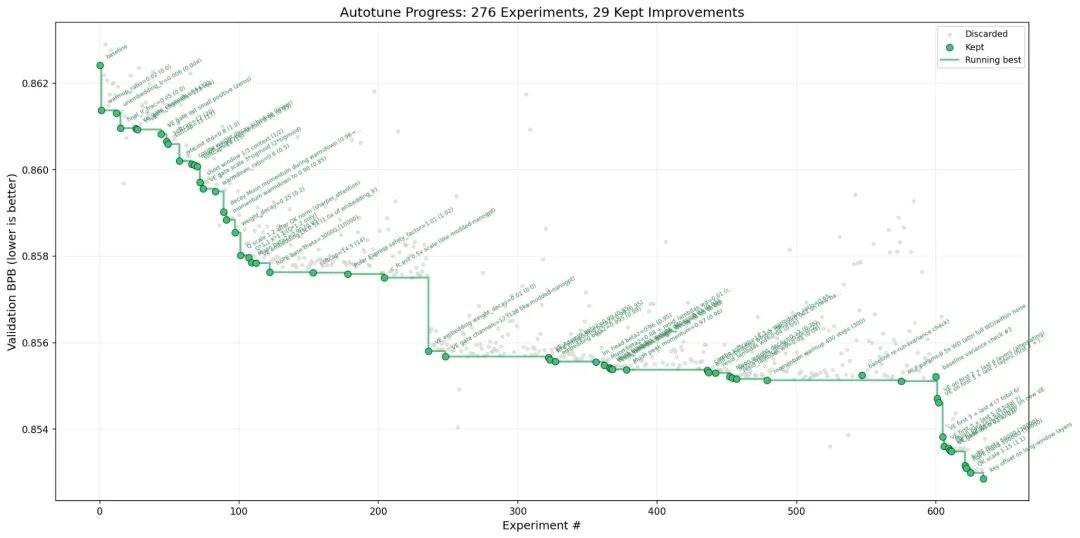
他引用了 Andrej Karpathy 以发起的自动化研究实验为例。在相关实验中,模型继续进行大量实验后,性能仍保持改进趋势。即使实验数百次,改进曲线也不完全温和。
Brown 同时,英国人工智能安全研究所也提到了英国人工智能安全研究所(AI Security Institute)网络安全评估结果。在此评估中,包括 Mythos 和 GPT-5.5 一些模型,包括在内,累计使用超过 1 亿 token 之后,任务表现继续提高。
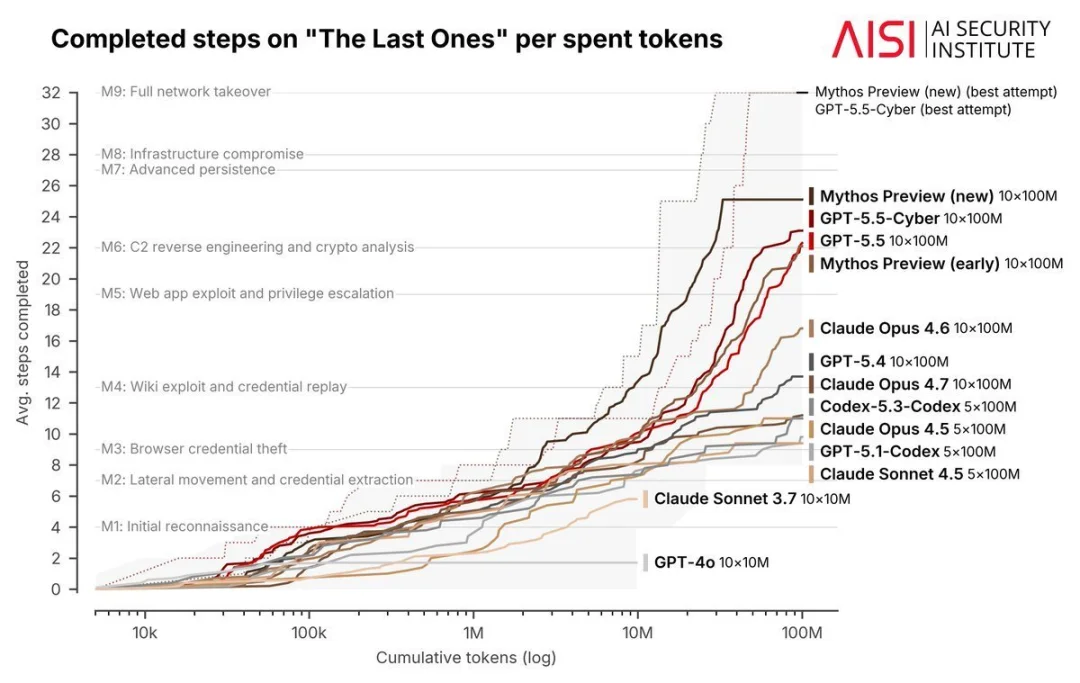
这种现象意味着模型可以利用越来越长的运行时间和越来越大的推理预算,在复杂的任务中不断探索、尝试和纠正策略。更强大的模型不仅有更高的起点,而且可能更擅长将额外的计算资源转化为有效的能力。
Brown 据推测,随着模型能力的提高,其有效运行的任务周期也会延长。在过去,人们可能会在相对有限的预算下观察到,模型性能趋于稳定;在未来,性能上限可能会被推远。在某些任务中,所谓「平台期」它甚至可能不再是一个容易测量的状态。
从单一分数转向「性能-成本曲线」
面对这一变化,Brown 建议模型发布机构应改变基准测试的呈现方式。
与其只公布一个最终分数,不如在横轴上标注推理计算量,在纵轴上显示任务性能,并绘制完整的性能变化曲线。横轴可用 token 数量、推理成本或实际运行时间等指标。
这种方法可以回答传统成绩表中难以解释的问题。例如,在相同的预算下,哪个模型表现得更好?当预算增加十倍时,哪个模型改进得更快?模型接近能力上限吗?不同模型的成本效益如何变化?
类似的方法已经开始用于一些基准测试。Brown 提到,ARC-AGI 评估试图衡量模型分数与运行成本之间的关系,而不仅仅是发布单一分数。
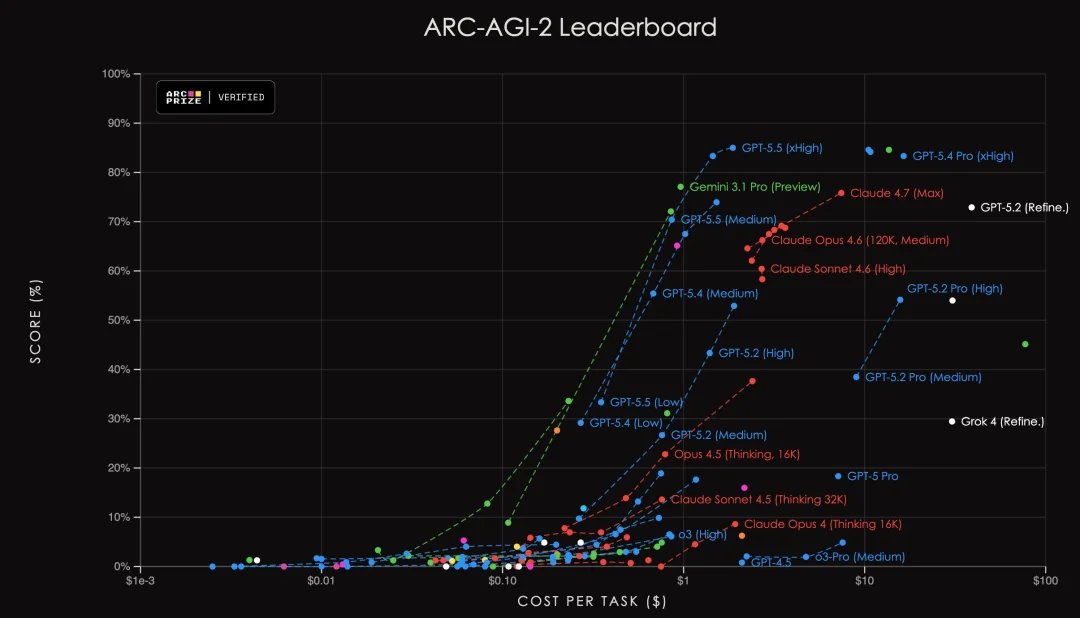
另一个可行的方案是为评估设置明确的方案 token、成本或时间限制,并提前通知模型预算信息。这种方式类似于人类参加标准化考试:无论是美国大学入学考试 SAT,或者国际数学奥林匹克比赛,参赛者需要在固定时间内完成任务。模型能力也可以在统一的约束下进行比较。
不过,Brown 同时,指出不同的指标是有限的。
token 由于不同模型使用的分词器、生成速度和单位,数量可能无法直接跨模型进行比较 token 成本可能会有所不同。成本受硬件利用率、批量处理和工程实现的影响。由于运行时间不是一个完美的指标,因此运行时间也不是一个完美的指标「多智能体合作」或 best-of-N 等待技术可以并行生成多个候选答案,不一定会显著增加用户感受到的等待时间,同时显著增加总计算量。
尽管如此,他认为上述任何指标都比脱离推理预算的单一分数更有信息量。
推理预算问题正在扩展到人工智能安全评估
Brown 讨论不限于模型列表。他认为,推理预算也会直接影响前沿模型的安全管理。
在发布前沿人工智能模型之前,R&D机构通常会评估网络攻击、生物风险、化学风险等潜在滥用能力。如果模型达到一定的风险阈值,R&D机构可能需要推迟发布,或者在部署前增加访问限制、监控机制等缓解措施。
问题是,如果模型能力随着推理计算量的增加而提高,安全评估应该使用多少推理预算?
事实上,普通用户可能只会为一项任务投资几美元或几十美元。然而,一个资金充足的组织、专业团队或国家行为人可能愿意为单一目标投资远高于普通用户的资源。如果评估机构只在较低的预算下测试模型,则可能会低估其在高资源条件下的风险能力。
Brown 以 Gemini 3 Deep Think 以发布后的争议为例。他指出,Deep Think 基准测试结果明显高于以前的模型,但在发布时没有同步提供完整的系统卡,以满足该版本的风险能力。这种做法引起了一些人工智能安全研究人员的批评。
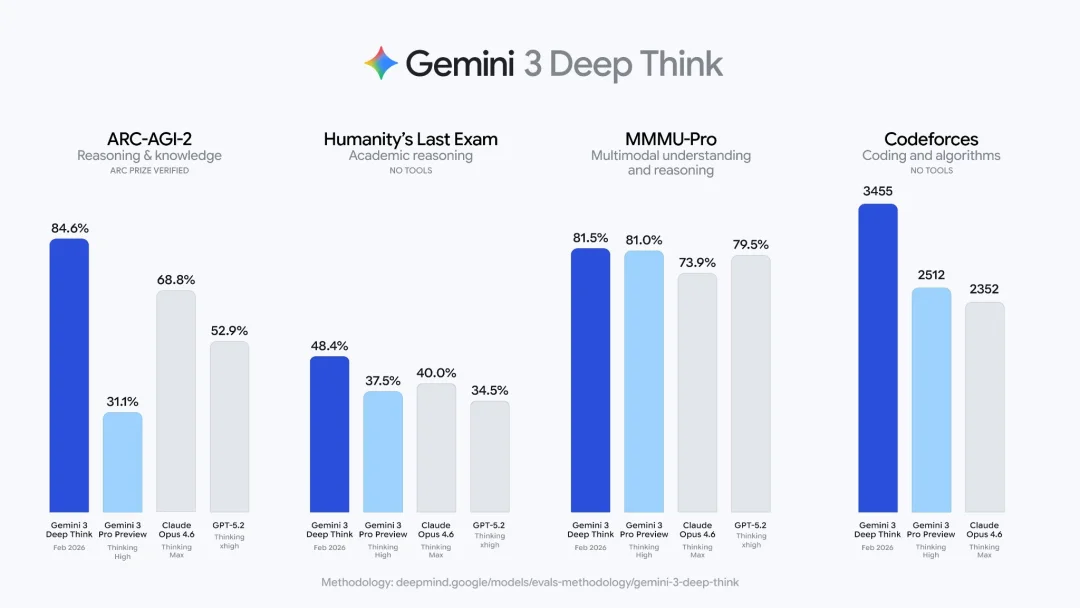
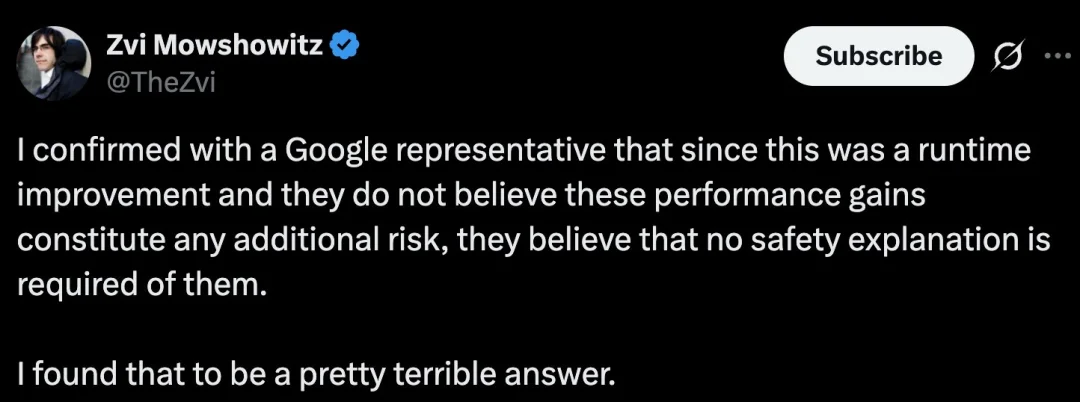
不过,在 Brown 争议背后似乎存在着更深层次的问题:人工智能企业和安全机构尚未形成一套用于评估不同推理预算下模型能力的稳定方法。
他推测,Deep Think 它可能不是一个完全独立训练的新模型,而是一个基于其他现有模型的推理脚手架系统。该系统可以通过多次调用模型、并行生成候选结果、自动检查答案和迭代修正来提高复杂的任务性能。
假如这个判断成立了,那么 Deep Think 理论上,不仅平台本身可以实现所展示的部分能力。只要外部开发人员愿意投入足够高的推理成本,他们也可以结合多个模型调用来构建类似的工作流。Deep Think 作用,更多的是将原本需要专业开发能力的复杂推理流程封装成普通用户也可以方便调用的产品形式。
因此,Brown 人们认为,真正值得注意的问题不是产品是否单独发布了系统卡,而是研发机构是否在不同的推理预算和脚手架策略下充分测试了基本模型最初发布时可能达到的能力水平。
高预算评估难以全面实施,但可以尝试外推
理论上,一个资源充足的行为体可能会在单一任务上投入更多 1000 一万美元的推理成本。然而,安全评估通常涉及数千甚至数百万次测试。如果每次操作都使用极高的预算,评估成本将很快失去可行性。
Brown 提出可以先在相对可控的推理预算范围内进行测试,然后根据模型能力随计算量变化的趋势推动更高预算条件下的性能。同时,评估机构应明确标记预测范围和不确定性,而不是将计算结果视为确定结论。
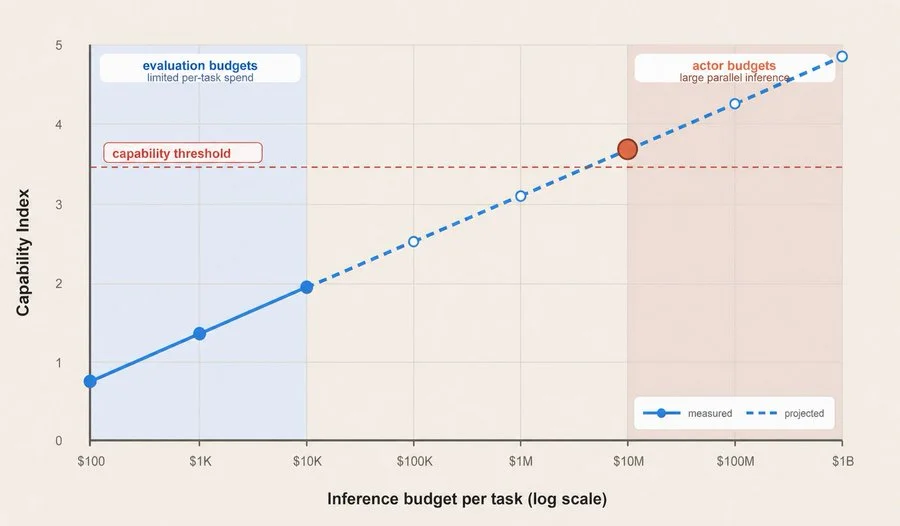
该方法类似于通过局部数据估计更大规模系统的变化趋势。它不能取代实际测试,但它可以帮助研发机构和监管机构理解当模型被赋予更多的时间、工具和计算资源时,风险边界可能会发生什么变化。
不过,Brown 还承认,长周期任务仍可能带来短期实验难以解决的问题。
例如,如果研究人员想判断一个独立的智能主体在持续运行一年后是否会有目标偏差、战略欺骗或其他不匹配行为,那么最可靠的方法可能仍然是让智能主体实际运行足够长的时间。仅仅根据几个小时或几天的实验结果,它可能无法捕捉到长期行为中的关键变化。
这将产生一个新的现实矛盾:人工智能模型的开发和发布周期可能只有几个月,而智能身体可以持续运行的任务周期可能越来越长。在未来,研发机构可能会面临一个特殊情况——下一代模型在覆盖其最大运行周期之前就已经接近发布。
三个建议:使推理预算成为模型评估的基本变量
针对能力评估和安全治理中的上述问题,Brown 提出三项具体建议。
首先,人工智能研发机构在发布新模型时,应在不同的推理预算条件下公布基准测试性能。理想情况下,企业应提供 token 数量、成本或运行时间是横轴的性能曲线。至少,企业需要解释在实现单点结果时实际使用了多少推理资源。
第二,基准测试排名应记录推理资源的消耗,或为参考模型设置统一 token、成本或时间限制。目前,一些评估已被纳入相关变量,但该行业尚未形成标准实践。
第三,人工智能企业的准备框架(Preparedness Framework)以及负责任的扩大政策(Responsible Scaling Policy,RSP)推理阶段的计算资源应明确考虑。当机构判断模型是否跨越一定的安全阈值时,不仅要检查单一配置下的性能,还要评估多个推理预算水平,对更高预算条件下的风险能力进行不确定性预测。
该行业已经意识到了这个问题,但评估系统还没有完全跟上
在推理阶段增加计算资源可以提高模型性能,这不是一个新的发现。
自 OpenAI 在 2024 年 9 月发布 o1 自该系列推理模型以来,该行业普遍认为,该模型在回答问题时投入了更多的推理步骤,可以在数学、代码和复杂的分析任务中取得更好的效果。围绕「计算测试时的扩展情况」或「计算推理时的扩展」研究也逐渐成为大模型发展的重要方向。
但 Brown 据认为,在这一趋势出现近两年后,许多尖端模型的发布仍然主要依靠单一的基准分数进行传播和比较。一些安全机构也可以在脚手架系统使用几十倍甚至数百倍的推理预算后重新审视模型能力的边界。
随着模型越来越擅长使用长期运行、多轮试错和大规模推理资源,传统列表的解释可能会继续下降。在低预算问答、高预算深度研究、多智能协作和自动化工具呼叫等不同条件下,同一基本模型可能表现出完全不同的能力水平。
Brown 判断是,在未来测量人工智能能力时,推理预算不应再被视为测试过程中的辅助信息,而应成为评估报告中的核心参数,如模型规模、培训数据和上下文窗口。
从更广泛的角度来看,这也意味着人工智能产业正在逐渐告别「用一个数字定义一个模型」阶段。对于能力评估、产品比较和安全管理来说,真正重要的问题可能不仅仅是模型能做什么,而是当它获得足够的时间、资金和计算资源时能做什么。
参考连接:https://x.com/polynoamial/status/2064210146558136827
作者来自“机器之心” “机器之心编辑部”。
有用吗?