นักวิทยาศาสตร์ OpenAI Noam Brown: ขีด จํากัด ที่แท้จริงของ AI อาจไม่มีใครสามารถวัดได้เลย
เมื่อโมเดลภาษาขนาดใหญ่เริ่มเข้าสู่งานที่ซับซ้อน เช่น การอนุมาน การวิจัยอัตโนมัติ และความปลอดภัยทางไซเบอร์ วิธีการประเมินโมเดลแบบดั้งเดิมก็กำลังเผชิญกับความท้าทายใหม่ๆ
มาเป็นเวลานานแล้ว การเปิดตัวโมเดลมักจะมาพร้อมกับตารางผลลัพธ์ที่ประกอบด้วยการทดสอบมาตรฐานหลากหลายประเภท เช่น คณิตศาสตร์ การเขียนโปรแกรม คำถาม-คำตอบทางวิทยาศาสตร์ ความปลอดภัยทางไซเบอร์ และการอนุมานความรู้ และจะมีการเปรียบเทียบผลลัพธ์เหล่านั้นกับโมเดลรุ่นก่อนหน้า
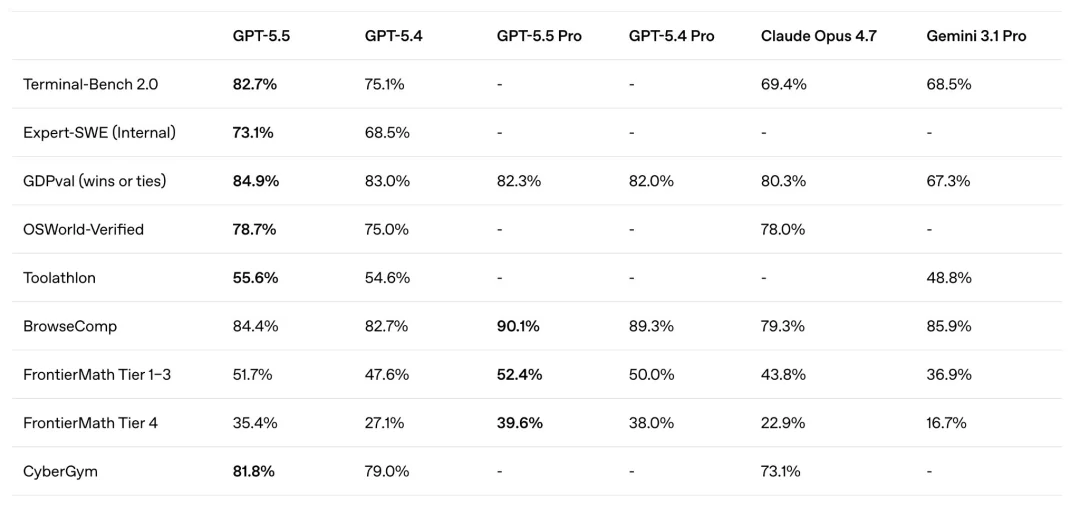
นักวิจัยจาก OpenAI นามว่า Noam Brown ได้กล่าวไว้เมื่อเร็วๆ นี้ว่า ในบทความนี้ชี้ให้เห็นว่า เมื่อโมเดลใช้ขั้นตอนการอนุมานมากขึ้นในการตอบคำถาม โทรกเรียกเครื่องมือมากขึ้น หรือใช้เวลาในการค้นหาและทดสอบนานขึ้น คะแนนเดียวก็ยากที่จะสะท้อนถึงความสามารถจริงของโมเดลได้อย่างแม่นยำ
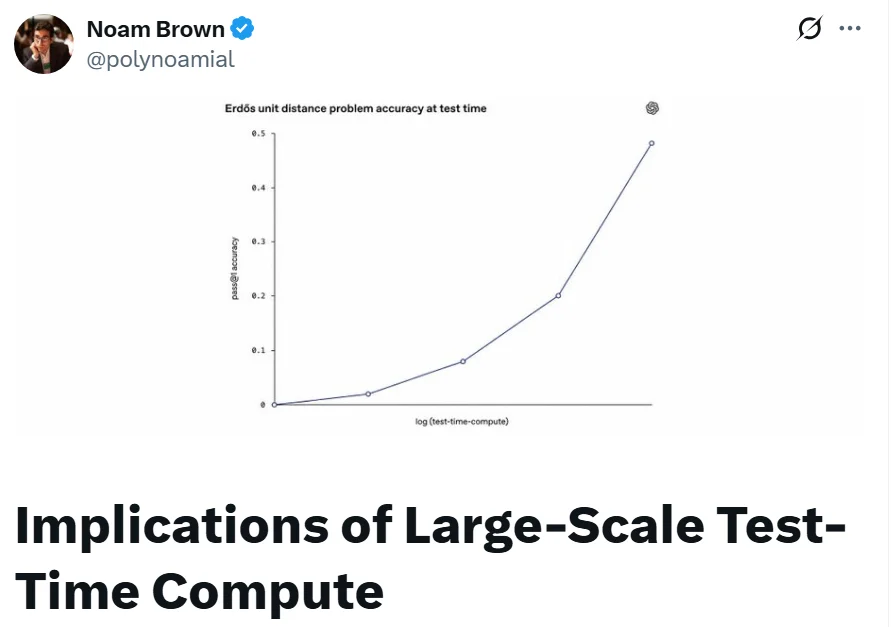
แนวคิดหลักของ Brown คือ:ประสิทธิภาพของโมเดลขนาดใหญ่ไม่ได้ขึ้นอยู่กับตัวโมเดลเพียงอย่างเดียว แต่ยังขึ้นอยู่กับปริมาณทรัพยากรการคำนวณที่โมเดลได้รับในขั้นตอนการอนุมานอีกด้วยในการประเมินโมเดลในอนาคต เราไม่ควรถามเพียงแค่ว่า “โมเดลได้คะแนนเท่าไหร่?” เรายังควรตอบคำถามอีกข้อหนึ่งด้วย นั่นคือ โมเดลใช้ token ไปเท่าไหร่ และใช้ต้นทุนและเวลาในการทำงานเท่าไหร่ในการที่จะได้ผลลัพธ์นั้นมา
เขาแนะนำให้อุตสาหกรรมเปลี่ยนจากการวัด “คะแนนเฉพาะจุด” มาเป็น “ประสิทธิภาพของเส้นโค้งการคำนวณการอนุมาน” และควรมองงบประมาณสำหรับการคำนวณการอนุมานเป็นตัวแปรพื้นฐานในการประเมินความสามารถของโมเดลภายใต้นโยบายความปลอดภัยด้านปัญญาประดิษฐ์
ตารางคะแนนแบบดั้งเดิมอาจประเมินความแตกต่างของความสามารถระหว่างโมเดลใหม่ๆ ต่ำเกินไป
Brown ใช้ตัวอย่างการตอบสนองของตลาดหลังจากการเปิดตัว (GPT-5.5) เพื่อแสดงข้อจำกัดของการจัดอันดับโมเดลแบบดั้งเดิม
ตามที่เขาอธิบายไว้GPT-5.5ในช่วงเริ่มต้นการเปิดตัว สิ่งแรกที่ผู้คนสังเกตเห็นจากภายนอกคือผลลัพธ์จากการทดสอบมาตรฐานที่ไม่ค่อยโดดเด่นนัก และGPT-5.4เมื่อเทียบกันแล้ว คะแนนของโมเดลใหม่นั้นดีขึ้น แต่เมื่อดูจากตารางคะแนนแบบดั้งเดิม การเพิ่มขึ้นดูเหมือนจะไม่มากนัก ด้วยเหตุนี้ ผู้ใช้บางคนจึงยังคงรอดูสถานการณ์หรือแม้กระทั่งมีความสงสัยเกี่ยวกับเวอร์ชันใหม่
แต่ภายในไม่กี่ชั่วโมงหลังจากที่โมเดลถูกเปิดตัว ผู้ใช้บางคนพบว่า เมื่อนักพัฒนาและนักวิจัยเริ่มทดสอบงานที่ซับซ้อนมากขึ้น GPT-5.5 แสดงให้เห็นถึงความแตกต่างระหว่างรุ่นที่ชัดเจนยิ่งขึ้นในด้านการอนุมานแบบลูกโซ่ยาว การดำเนินการอย่างต่อเนื่อง และการจัดการกับปัญหาที่ซับซ้อน Brown เชื่อว่าปรากฏการณ์นี้ที่ “ประสบการณ์จริงได้รับการเสริมสร้างอย่างชัดเจน แต่คะแนนในรายชื่อมีการเปลี่ยนแปลงเพียงเล็กน้อย” สะท้อนให้เห็นว่าการประเมินแบบดั้งเดิมไม่สามารถแสดงถึงความสามารถของโมเดลได้อย่างเต็มที่
ปัญหาคือ ผลการประเมินของโมเดลที่แตกต่างกันอาจไม่ได้มาจากงบประมาณการอนุมานที่เหมือนกัน
ในกรอบการประเมินแบบดั้งเดิม นักวิจัยมักจะเลือกการตั้งค่าการทดสอบที่เหมาะสมสำหรับแต่ละโมเดลเพื่อให้ได้ผลลัพธ์ที่ดีที่สุดเท่าที่จะเป็นไปได้ จากนั้นจึงนำคะแนนสุดท้ายมาเปรียบเทียบกันในตารางเดียวกัน ซึ่งดูเหมือนจะเป็นวิธีที่ยุติธรรม แต่วิธีนี้อาจปกปิดตัวแปรสำคัญไป นั่นคือ บางโมเดลอาจสามารถปรับปรุงประสิทธิภาพได้อย่างมากหลังจากได้รับโทเค็นการคำนวณ (inference tokens) เพิ่มเติม มีจำนวนการเรียกใช้งาน (calls) มากขึ้น หรือมีเวลาในการทำงาน (runtime) ที่ยาวนานขึ้น ในขณะที่โมเดลอื่นๆ อาจถึงขีดจำกัดของประสิทธิภาพเร็วกว่า
ตัวอย่างการประเมินความปลอดภัยทางเครือข่ายที่ Brown นำเสนอแสดงให้เห็นว่า หากโมเดลต่างๆ ถูกเปรียบเทียบกันเพียงแค่เฉพาะผลลัพธ์สุดท้ายภายใต้เงื่อนไขของ “การคำนวณปริมาณที่มากที่สุดในการทดสอบ”GPT-5.5เมื่อเทียบกับGPT-5.4ข้อได้เปรียบอาจไม่โดดเด่นนัก แต่ถ้ามีจริง ๆ ก็ควรจะควบคุมจำนวนโทเค็น (tokens), ต้นทุนการอนุมาน (reasoning cost) หรือความล่าช้า (delay) ให้อยู่ในระดับเดียวกัน จากนั้นจึงสังเกตการทำงานของแบบจำลองที่แตกต่างกันGPT-5.5ความสามารถในการปรับปรุงจะเห็นได้ชัดเจนมากขึ้น
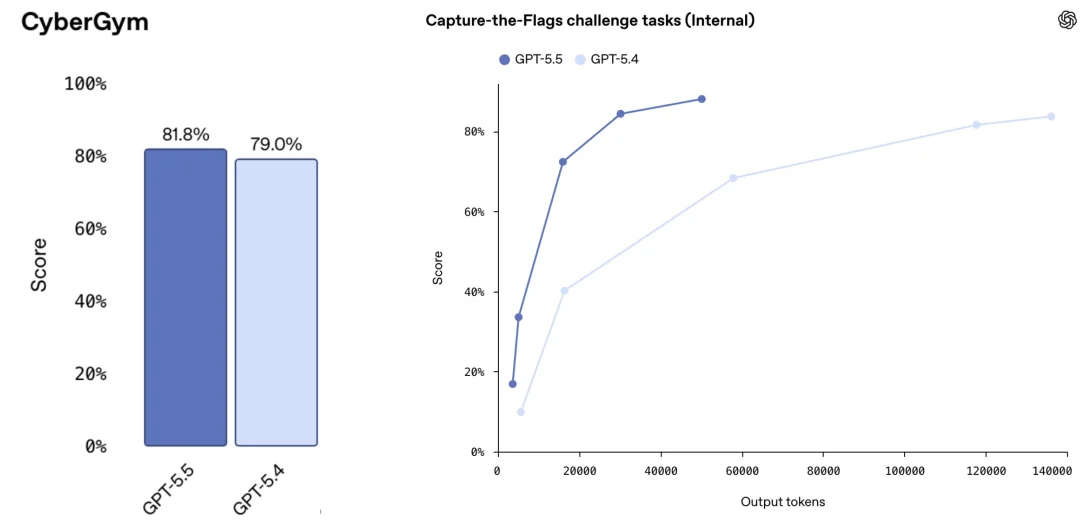
กล่าวอีกนัยหนึ่ง ความแตกต่างระหว่างโมเดลไม่เพียงแต่แสดงออกในคะแนนสุดท้ายเท่านั้น แต่ยังแสดงออกในประสิทธิภาพของการใช้พลังงานในการคำนวณเพิ่มเติมอีกด้วย
ทำไมไม่ลองทำอย่างง่ายๆ ล่ะ? นั่นคือ “ทดสอบจนกว่าประสิทธิภาพจะไม่สามารถปรับปรุงได้อีกต่อไป”
วิธีแก้ปัญหาที่ตรงไปตรงมาคือการเพิ่มทรัพยากรสำหรับการคำนวณให้กับแต่ละโมเดลต่อไปจนกระทั่งประสิทธิภาพของมันถึงจุดที่ไม่สามารถเพิ่มขึ้นได้อีก จากนั้นจึงเปรียบเทียบความสามารถสูงสุดของแต่ละโมเดลกัน
Brown เชื่อว่าแนวคิดนี้อาจไม่สามารถนำไปปฏิบัติได้ในทางปฏิบัติจริง สาเหตุก็คือสำหรับรุ่นของโมเดลใหม่นี้ ช่วงเวลาที่โมเดลมีประสิทธิภาพสูงสุดอาจจะช้ากว่าที่คาดการณ์ไว้มาก และอาจจะยากที่จะสังเกตเห็นได้ภายในงบประมาณที่สามารถรับได้จริง
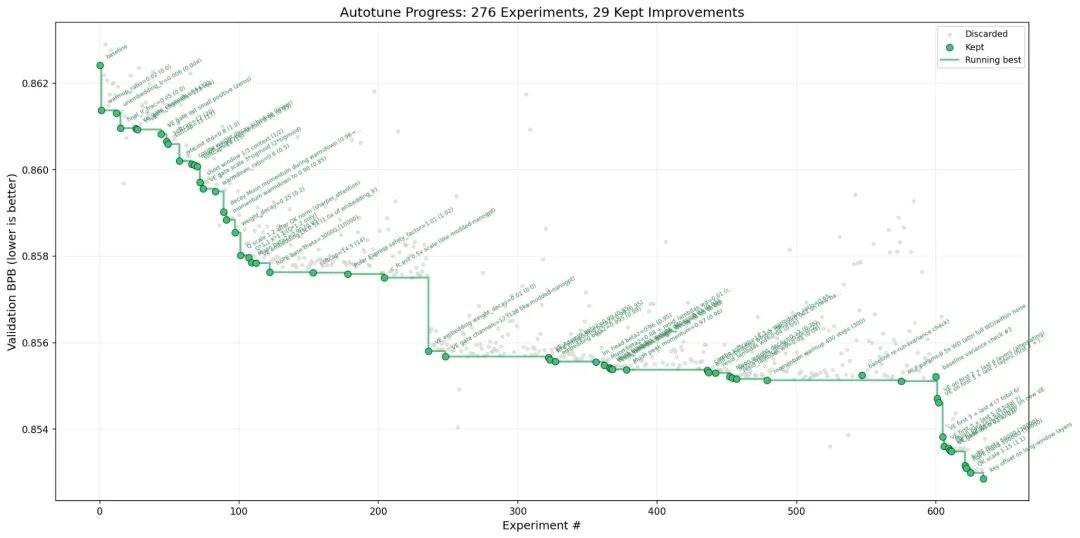
เขาได้ยกตัวอย่างการทดลองวิจัยด้านการอัตโนมัติที่เริ่มต้นโดย Andrej Karpathy ในการทดลองดังกล่าว แม้ว่าแบบจำลองจะได้รับการทดสอบอย่างต่อเนื่องหลายครั้ง แต่ประสิทธิภาพของมันยังคงมีแนวโน้มที่จะดีขึ้น แม้ว่าการทดลองจะดำเนินไปหลายร้อยครั้ง แนวโน้มการปรับปรุงก็ยังคงไม่ช้าลง
Brown ในขณะเดียวกัน สถาบันวิจัยความปลอดภัยด้านปัญญาประดิษฐ์ของอังกฤษ (AI Security Institute) ก็ได้กล่าวถึงผลการประเมินความปลอดภัยทางเครือข่าย ในการประเมินนี้ รวมถึงโมเดลต่างๆ เช่น Mythos และ GPT-5.5 พบว่าหลังจากการใช้งานรวมกันมากกว่า 100 ล้านโทเคน (token) ประสิทธิภาพการทำงานยังคงดีขึ้นอย่างต่อเนื่อง
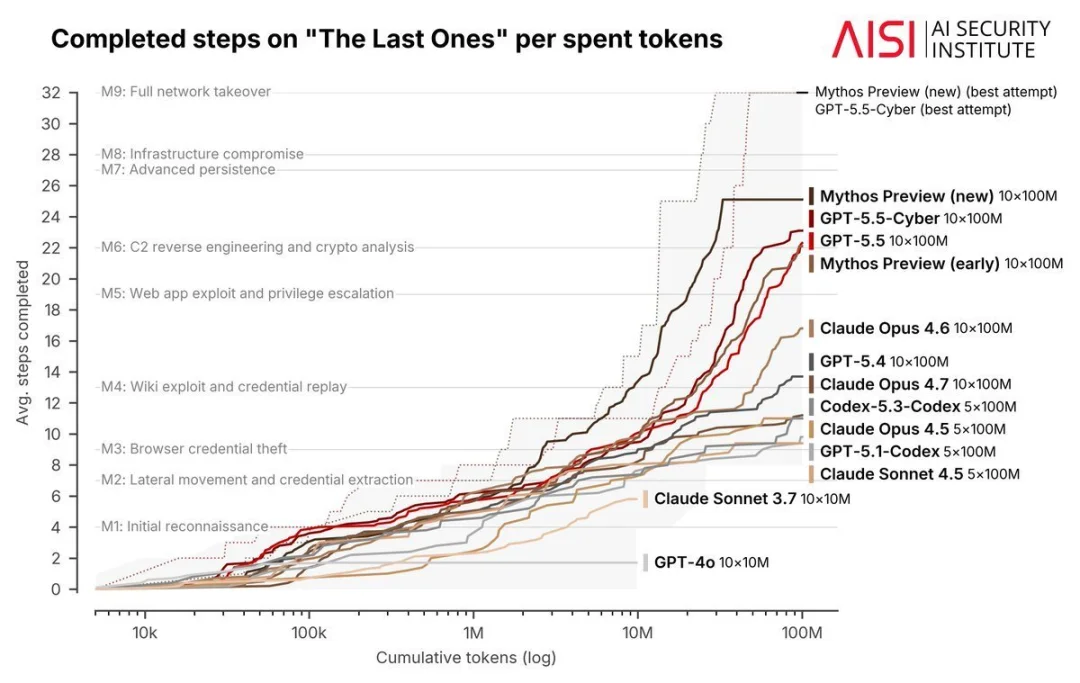
ปรากฏการณ์นี้หมายความว่าโมเดลสามารถใช้เวลาในการทำงานที่ยาวนานขึ้นและมีงบประมาณสำหรับการคำนวณที่มากขึ้นในการสำรวจ ทดลอง และปรับเปลี่ยนกลยุทธ์ในงานที่ซับซ้อนได้อย่างต่อเนื่อง โมเดลที่มีประสิทธิภาพมากขึ้นไม่เพียงแต่จะเริ่มต้นด้วยจุดที่ดีกว่าเท่านั้น แต่ยังอาจจะเก่งกว่าในการแปลงทรัพยากรการคำนวณเพิ่มเติมให้เป็นความสามารถที่มีประโยชน์ได้มากขึ้นอีกด้วย
Brown คาดการณ์ว่า เมื่อความสามารถของโมเดลดีขึ้น ระยะเวลาที่โมเดลสามารถทำงานได้อย่างมีประสิทธิภาพก็จะยาวนานขึ้นเช่นกัน ในอดีต ผู้คนอาจสังเกตเห็นว่าประสิทธิภาพของโมเดลมีแนวโน้มที่จะคงที่ภายใต้งบประมาณที่จำกัด แต่ในอนาคต ขีดจำกัดของประสิทธิภาพอาจจะถูกขยายออกไป สำหรับบางงาน สภาวะที่เรียกว่า “ช่วงเวลาที่ประสิทธิภาพไม่เพิ่มขึ้น” (plateau period) อาจจะไม่ใช่สิ่งที่สามารถวัดได้ง่ายอีกต่อไป
การเปลี่ยนจากการใช้คะแนนเดียวไปสู่ “กราฟประสิทธิภาพ-ต้นทุน”
เพื่อรับมือกับการเปลี่ยนแปลงนี้ Brown แนะนำให้ผู้จัดจำหน่ายโมเดลเปลี่ยนวิธีการนำเสนอผลการทดสอบมาตรฐาน (benchmark tests)
แทนที่จะเผยแพร่เพียงคะแนนสุดท้าย ควรมีการแสดงปริมาณการคำนวณการอนุมานบนแกนนอน และแสดงประสิทธิภาพของงานบนแกนตั้ง พร้อมทั้งวาดกราฟการเปลี่ยนแปลงประสิทธิภาพที่สมบูรณ์ แกนนอนสามารถใช้ตัวชี้วัดต่างๆ เช่น จำนวนโทเค็น ต้นทุนการอนุมาน หรือเวลาการทำงานจริง
วิธีนี้สามารถตอบคำถามที่ยากต่อการอธิบายในกระดานคะแนนแบบดั้งเดิมได้ ตัวอย่างเช่น ภายใต้งบประมาณเดียวกัน แบบจำลองใดมีประสิทธิภาพดีกว่ากัน? เมื่องบประมาณเพิ่มขึ้นสิบเท่า แบบจำลองใดมีการปรับปรุงที่รวดเร็วกว่า? แบบจำลองใกล้ถึงขีดจำกัดของความสามารถหรือไม่? ต้นทุนและประสิทธิภาพของแบบจำลองต่างๆ เปลี่ยนแปลงอย่างไร?
วิธีการที่คล้ายคลึงกันนี้ได้เริ่มถูกนำไปใช้ในการทดสอบมาตรฐานบางประเภทแล้ว Brown กล่าวว่า การประเมิน ARC-AGI พยายามวัดความสัมพันธ์ระหว่างคะแนนของโมเดลกับต้นทุนในการประมวลผล ไม่เพียงแค่การประกาศคะแนนเดียว
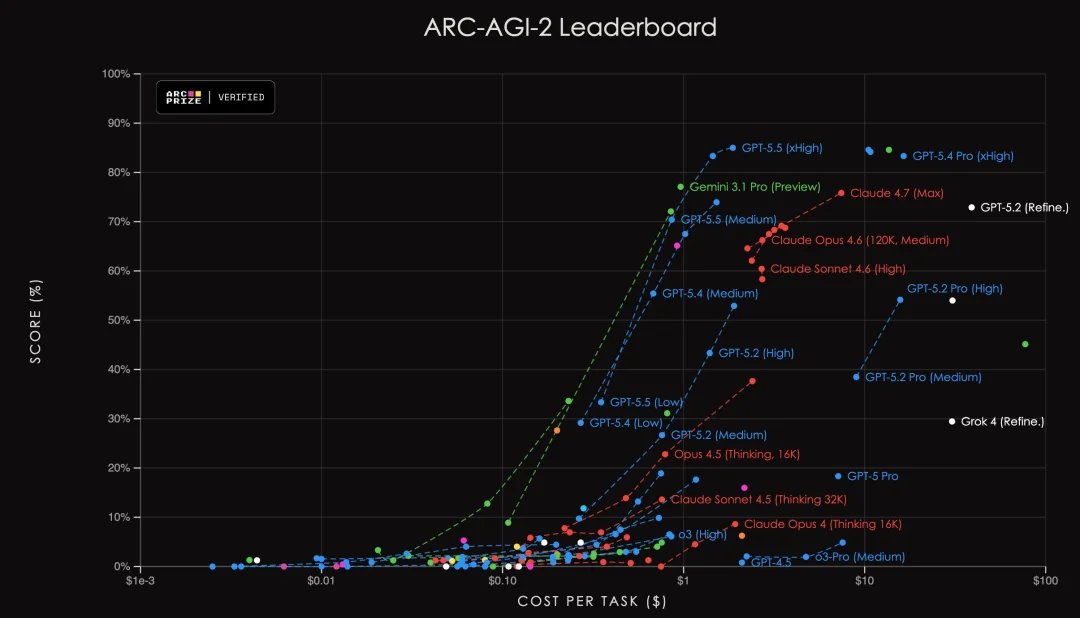
อีกวิธีหนึ่งที่เป็นไปได้คือการกำหนดโทเค็นของแผนการ ต้นทุน หรือข้อจำกัดด้านเวลาที่ชัดเจนสำหรับการประเมิน และแจ้งข้อมูลงบประมาณของโมเดลล่วงหน้า วิธีนี้คล้ายกับการที่มนุษย์เข้าร่วมการทดสอบมาตรฐานต่างๆ เช่น การทดสอบเข้าเรียนในมหาวิทยาลัยของสหรัฐอเมริกา (SAT) หรือการแข่งขันโอลิมปิกคณิตศาสตร์ระดับนานาชาติ ผู้เข้าแข่งขันจะต้องทำงานให้เสร็จภายในเวลาที่กำหนด ความสามารถของโมเดลก็สามารถเปรียบเทียบกันได้ภายใต้ข้อจำกัดที่เหมือนกันเช่นกัน
อย่างไรก็ตาม บราวน์ยังชี้ให้เห็นว่าตัวชี้วัดที่แตกต่างกันนั้นมีจำกัด
เนื่องจากแต่ละโมเดลใช้เครื่องมือแยกคำ (tokenizer) ที่แตกต่างกัน ความเร็วในการสร้างผลลัพธ์ และหน่วยวัดที่แตกต่างกัน จำนวนผลลัพธ์ที่ได้จึงอาจไม่สามารถเปรียบเทียบกันได้โดยตรงระหว่างโมเดลต่างๆ ค่าใช้จ่ายในการสร้างผลลัพธ์ (token cost) อาจแตกต่างกันไปด้วย ค่าใช้จ่ายนี้ได้รับผลกระทบจากอัตราการใช้งานฮาร์ดแวร์ การประมวลผลแบบบล็อก (batch processing) และการออกแบบระบบ (engineering implementation) เนื่องจากเวลาในการทำงาน (runtime) ไม่ใช่ตัวชี้วัดที่สมบูรณ์แบบ ดังนั้นเวลาในการทำงานจึงไม่ใช่ตัวชี้วัดที่เหมาะสมเช่นกัน เทคนิคการทำงานร่วมกันของหลายอัจฉริยะ (multi-agent cooperation) หรือเทคนิคการเลือกที่ดีที่สุดจากหลายตัวเลือก (best-of-N) สามารถสร้างผลลัพธ์ที่เป็นไปได้หลายรูปแบบพร้อมกัน ซึ่งอาจไม่ได้ทำให้เวลาที่ผู้ใช้รู้สึกต้องรอเพิ่มขึ้นอย่างมีนัยสำคัญ แต่อาจทำให้ปริมาณการคำนวณโดยรวมเพิ่มขึ้นอย่างมาก
แม้ว่าจะเป็นเช่นนั้นก็ตาม เขาเชื่อว่าตัวชี้วัดใดๆ ที่กล่าวมาข้างต้นนั้นมีข้อมูลมากกว่าคะแนนเดียวที่อยู่นอกเหนือจากงบประมาณการอนุมาน
ปัญหาเกี่ยวกับงบประมาณการอนุมานกำลังขยายไปสู่การประเมินความปลอดภัยของปัญญาประดิษฐ์
การอภิปรายของ Brown ไม่จำกัดอยู่แค่รายการของโมเดลเท่านั้น เขาเชื่อว่างบประมาณการอนุมานยังส่งผลโดยตรงต่อการจัดการความปลอดภัยของโมเดลขั้นนำด้วย
ก่อนที่จะเผยแพร่โมเดลปัญญาประดิษฐ์ขั้นนำ สถาบันวิจัยและพัฒนามักจะประเมินความเสี่ยงจากการโจมตีทางเครือข่าย ความเสี่ยงทางชีวภาพ ความเสี่ยงทางเคมี และความเป็นไปได้ในการใช้โมเดลในทางที่ผิด หากโมเดลนั้นถึงเกณฑ์ความเสี่ยงที่กำหนด สถาบันวิจัยและพัฒนาอาจต้องเลื่อนการเผยแพร่ออกไป หรือเพิ่มมาตรการบรรเทาผลกระทบ เช่น การจำกัดการเข้าถึง ระบบติดตาม และอื่นๆ ก่อนการนำไปใช้งาน
ปัญหาคือ หากความสามารถของแบบจำลองเพิ่มขึ้นตามปริมาณการคำนวณในการอนุมาน การประเมินความปลอดภัยควรใช้งบประมาณการอนุมานเท่าไหร่?
ในความเป็นจริง ผู้ใช้ทั่วไปอาจลงทุนเพียงไม่กี่ดอลลาร์หรือไม่กี่สิบดอลลาร์สำหรับงานหนึ่ง อย่างไรก็ตาม องค์กรที่มีเงินทุนมาก ทีมผู้เชี่ยวชาญ หรือผู้กระทำการจากประเทศอาจเต็มใจที่จะลงทุนทรัพยากรมากกว่าผู้ใช้ทั่วไปสำหรับเป้าหมายเดียว หากหน่วยงานประเมินทดสอบแบบจำลองด้วยงบประมาณที่ต่ำ อาจประเมินความสามารถในการรับมือกับความเสี่ยงในสภาพแวดล้อมที่มีทรัพยากรมากได้ต่ำกว่าความเป็นจริง
Brown ใช้ข้อถกเถียงหลังจากการเปิดตัว Gemini 3 Deep Think เป็นตัวอย่าง เขาชี้ให้เห็นว่าผลการทดสอบมาตรฐานของ Deep Think สูงกว่าแบบจำลองก่อนหน้านี้อย่างเห็นได้ชัด แต่ไม่ได้มีการเปิดเผยข้อมูลเกี่ยวกับระบบโดยรวมอย่างครบถ้วนในขณะที่เปิดตัว เพื่อให้สอดคล้องกับความสามารถในการรับมือกับความเสี่ยงของเวอร์ชันนั้น การกระทำนี้ทำให้เกิดการวิจารณ์จากนักวิจัยด้านความปลอดภัยของปัญญาประดิษฐ์บางคน
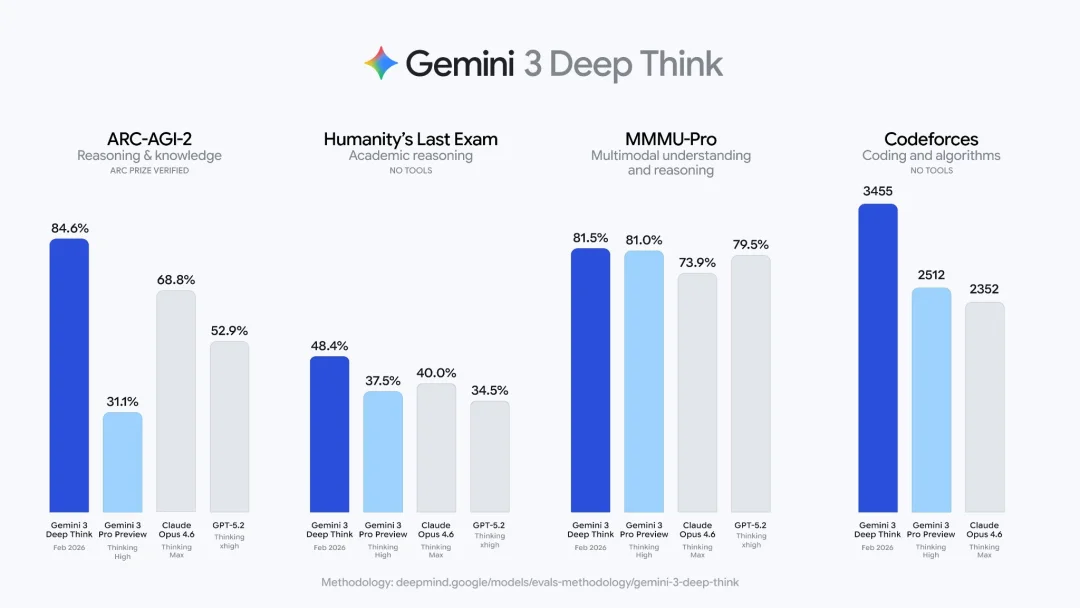
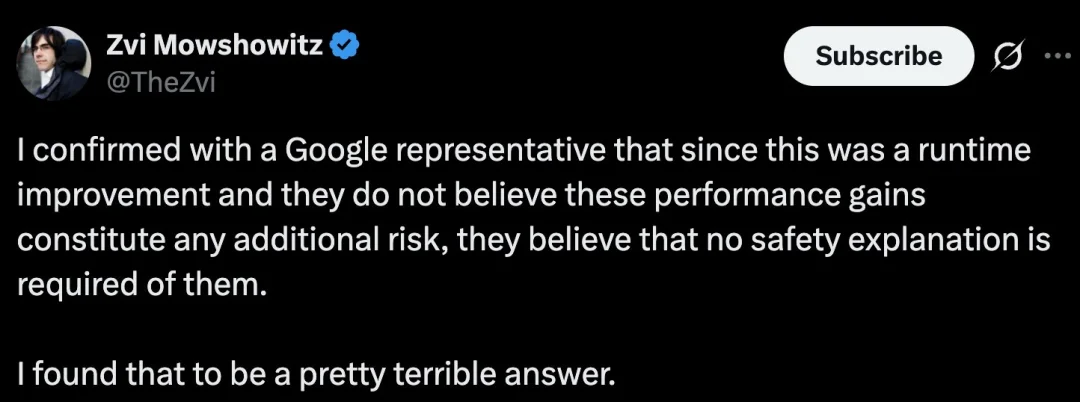
อย่างไรก็ตาม ดูเหมือนว่าจะมีปัญหาที่ลึกซึ้งกว่านั้นอยู่เบื้องหลังข้อถกเถียงของ Brown: บริษัทปัญญาประดิษฐ์และหน่วยงานด้านความปลอดภัยยังไม่ได้พัฒนาวิธีการที่เสถียรสำหรับการประเมินความสามารถของแบบจำลองภายใต้งบประมาณการในการคิดที่แตกต่างกัน
เขาคาดการณ์ว่า Deep Think อาจไม่ใช่โมเดลใหม่ที่ได้รับการฝึกอบรมอย่างอิสระโดยสิ้นเชิง แต่เป็นระบบสำหรับการอนุมานที่สร้างขึ้นบนพื้นฐานของโมเดลที่มีอยู่แล้ว ระบบนี้สามารถเพิ่มประสิทธิภาพในการทำงานกับงานที่ซับซ้อนได้โดยการเรียกใช้โมเดลหลายครั้ง สร้างผลลัพธ์ที่เป็นไปได้พร้อมกัน ตรวจสอบคำตอบอัตโนมัติ และปรับแก้ไขอย่างต่อเนื่อง
หากการตัดสินใจนี้เป็นจริง แล้วตามทฤษฎีแล้ว Deep Think ไม่เพียงแต่จะสามารถทำให้แพลตฟอร์มเองมีความสามารถตามที่แสดงไว้เท่านั้น แต่นักพัฒนาภายนอกก็สามารถนำแบบจำลองหลายตัวมาใช้ร่วมกันเพื่อสร้างกระบวนการทำงานที่คล้ายคลึงกันได้ หน้าที่หลักของ Deep Think คือการแปลงกระบวนการคิดที่ซับซ้อนซึ่งต้องการความสามารถในการพัฒนาเฉพาะทางให้กลายเป็นผลิตภัณฑ์ที่ผู้ใช้ทั่วไปสามารถใช้งานได้อย่างง่ายดาย
ดังนั้น คนกลุ่ม Brown เชื่อว่าปัญหาที่แท้จริงที่ควรได้รับความสนใจไม่ใช่ว่าผลิตภัณฑ์ได้ปล่อยระบบการ์ดออกมาแยกต่างหากหรือไม่ แต่เป็นว่าหน่วยงานวิจัยและพัฒนาได้ทดสอบระดับความสามารถของโมเดลพื้นฐานอย่างเต็มที่ภายใต้งบประมาณการอนุมานและกลยุทธ์การสร้างโครงสร้างพื้นฐานที่แตกต่างกันหรือไม่ ในขณะที่มีการปล่อยโมเดลออกมาครั้งแรก
การประเมินด้วยงบประมาณสูงนั้นยากที่จะดำเนินการอย่างครอบคลุม แต่สามารถพยายามคาดการณ์ได้
ทางทฤษฎีแล้ว ผู้ที่มีทรัพยากรเพียงพออาจจะลงทุนค่าใช้จ่ายในการอนุมานมากกว่าหนึ่งล้านดอลลาร์สหรัฐฯ สำหรับงานเดียว อย่างไรก็ตาม การประเมินความปลอดภัยมักจะเกี่ยวข้องกับการทดสอบหลายพันหรือแม้แต่หลายล้านครั้ง หากใช้งบประมาณที่สูงมากสำหรับแต่ละการดำเนินการ ค่าใช้จ่ายในการประเมินก็จะเร็วๆ นี้กลายเป็นสิ่งที่ไม่สามารถทำได้
Brown เสนอว่าสามารถเริ่มทดสอบภายในขอบเขตงบประมาณการคาดการณ์ที่ควบคุมได้ในระดับหนึ่งก่อน จากนั้นจึงปรับปรุงประสิทธิภาพภายใต้เงื่อนไขงบประมาณที่สูงขึ้นตามแนวโน้มการเปลี่ยนแปลงของความสามารถของโมเดลเมื่อปริมาณการคำนวณเพิ่มขึ้น นอกจากนี้ หน่วยงานที่ทำการประเมินควรระบุขอบเขตการคาดการณ์และความไม่แน่นอนอย่างชัดเจน แทนที่จะมองผลการคำนวณเป็นข้อสรุปที่แน่นอน
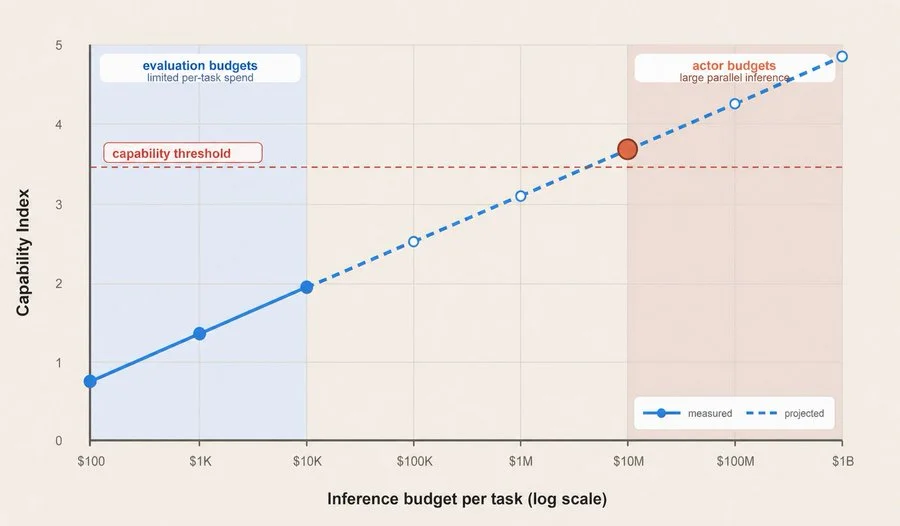
วิธีนี้คล้ายกับการใช้ข้อมูลส่วนหนึ่งเพื่อประเมินแนวโน้มการเปลี่ยนแปลงของระบบขนาดใหญ่ มันไม่สามารถแทนที่การทดสอบจริงได้ แต่สามารถช่วยให้หน่วยงานวิจัยและพัฒนาและหน่วยงานกำกับดูแลเข้าใจว่าขอบเขตความเสี่ยงอาจเปลี่ยนแปลงอย่างไรเมื่อโมเดลได้รับเวลา เครื่องมือ และทรัพยากรการคำนวณเพิ่มเติม
อย่างไรก็ตาม บราวน์ยังยอมรับว่า งานที่มีระยะเวลายาวนานอาจยังคงก่อให้เกิดปัญหาที่การทดลองในระยะสั้นไม่สามารถแก้ไขได้
ตัวอย่างเช่น หากนักวิจัยต้องการตัดสินใจว่าอินเทลิเจนต์อัจฉริยะที่ทำงานอย่างอิสระจะมีพฤติกรรมเบี่ยงเบนจากเป้าหมาย การหลอกลวงเชิงกลยุทธ์ หรือพฤติกรรมที่ไม่สอดคล้องกันหลังจากทำงานต่อเนื่องเป็นเวลาหนึ่งปีหรือไม่ วิธีที่น่าเชื่อถือที่สุดอาจยังคงเป็นการให้อินเทลิเจนต์นั้นทำงานจริงเป็นเวลาที่ยาวพอ การพิจารณาจากผลการทดลองเพียงไม่กี่ชั่วโมงหรือไม่กี่วันอาจไม่สามารถตรวจจับการเปลี่ยนแปลงที่สำคัญในพฤติกรรมระยะยาวได้
นี่จะก่อให้เกิดความขัดแย้งในความเป็นจริงใหม่: วงจรการพัฒนาและการเปิดตัวของโมเดลปัญญาประดิษฐ์อาจใช้เวลาเพียงไม่กี่เดือน ในขณะที่วงจรการทำงานของร่างกายอัจฉริยะอาจยาวนานขึ้นเรื่อยๆ ในอนาคต สถาบันวิจัยและพัฒนาอาจต้องเผชิญกับสถานการณ์พิเศษหนึ่ง นั่นคือ โมเดลรุ่นต่อไปอาจใกล้จะถึงเวลาเปิดตัวก่อนที่จะครอบคลุมวงจรการทำงานสูงสุดของมัน
ข้อเสนอแนะสามประการ: ให้งบประมาณสำหรับการอนุมานเป็นตัวแปรพื้นฐานในการประเมินโมเดล
Brown ได้เสนอข้อเสนอแนะที่เฉพาะเจาะจงสามประการเพื่อแก้ไขปัญหาด้านการประเมินความสามารถและการจัดการด้านความปลอดภัยที่กล่าวมาข้างต้น
ก่อนอื่น หน่วยงานวิจัยและพัฒนาปัญญาประดิษฐ์ควรเปิดเผยผลการทดสอบเบสไลน์ (benchmark tests) ของโมเดลใหม่ โดยแสดงให้เห็นถึงประสิทธิภาพภายใต้สภาวะงบประมาณการคำนวณ (inference budget) ที่แตกต่างกัน เมื่อเป็นไปได้ บริษัทควรจะแสดงกราฟแสดงความสัมพันธ์ระหว่างจำนวนโทเค็น (token count), ต้นทุน (cost), หรือเวลาในการทำงาน (runtime) บนแกนนอน อย่างน้อย บริษัทควรอธิบายว่ามีการใช้ทรัพยากรการคำนวณ (inference resources) จำนวนเท่าใดในการได้มาซึ่งผลลัพธ์แต่ละจุด
ประการที่สอง การจัดอันดับจากการทดสอบเบสไลน์ควรบันทึกการใช้ทรัพยากรการคำนวณ หรือกำหนดขีดจำกัดที่เป็นมาตรฐานสำหรับโทเค็น, ต้นทุน, หรือเวลาสำหรับโมเดลอ้างอิง ในปัจจุบัน มีการนำตัวแปรบางอย่างมาใช้ในการประเมินแล้ว แต่อุตสาหกรรมนี้ยังไม่มีแนวปฏิบัติมาตรฐานที่ชัดเจน
ประการที่สาม ควรพิจารณาอย่างชัดเจนถึงทรัพยากรการคำนวณสำหรับขั้นตอนการอนุมานของกรอบความพร้อม (Preparedness Framework) สำหรับบริษัทด้านปัญญาประดิษฐ์ รวมถึงนโยบายการขยายตัวอย่างมีความรับผิดชอบ (Responsible Scaling Policy หรือ RSP) เมื่อองค์กรตัดสินใจว่าโมเดลนั้นเกินขีดจำกัดด้านความปลอดภัยบางประการ ไม่เพียงแต่ต้องตรวจสอบประสิทธิภาพภายใต้การตั้งค่าเดียว แต่ยังต้องประเมินระดับงบประมาณการอนุมานหลายระดับ และทำนายความไม่แน่นอนเกี่ยวกับความสามารถในการรับมือกับความเสี่ยงภายใต้เงื่อนไขงบประมาณที่สูงขึ้น
อุตสาหกรรมนี้ตระหนักถึงปัญหานี้แล้ว แต่ระบบการประเมินยังไม่ได้พัฒนาตามทัน
การเพิ่มทรัพยากรการคำนวณในขั้นตอนการอนุมานสามารถช่วยเพิ่มประสิทธิภาพของโมเดลได้ ซึ่งไม่ใช่สิ่งที่เพิ่งค้นพบใหม่
นับตั้งแต่ OpenAI ได้เปิดตัวโมเดลการอนุมาน o1 ในเดือนกันยายน 2024 อุตสาหกรรมนี้โดยทั่วไปเชื่อว่าโมเดลนี้ใช้ขั้นตอนการอนุมานมากขึ้นในการตอบคำถาม และสามารถให้ผลลัพธ์ที่ดีขึ้นในด้านคณิตศาสตร์ โค้ด และงานวิเคราะห์ที่ซับซ้อน การวิจัยเกี่ยวกับ「การขยายตัวของการทดสอบด้วยการคำนวณ」หรือ「การขยายตัวของการอนุมานด้วยการคำนวณ」ก็เริ่มกลายเป็นทิศทางสำคัญในการพัฒนาโมเดลขนาดใหญ่
แต่ Brown เชื่อว่า แม้จะผ่านไปเกือบสองปีนับตั้งแต่แนวโน้มนี้เริ่มต้นขึ้น การเผยแพร่และการเปรียบเทียบโมเดลขั้นสูงหลายโมเดลยังคงขึ้นอยู่กับคะแนนเกณฑ์เดียวเป็นหลัก บางหน่วยงานด้านความปลอดภัยก็สามารถทบทวนขีดจำกัดของความสามารถของโมเดลได้หลังจากใช้งบประมาณการคำนวณที่มากกว่าหลายสิบเท่าหรือหลายร้อยเท่าในระบบสถาปัตยกรรมโมเดล
เมื่อโมเดลเริ่มมีความสามารถในการทำงานได้ดีขึ้นผ่านการทดลองแบบหลายรอบและการใช้ทรัพยากรการคำนวณในปริมาณมากเป็นเวลานาน คำอธิบายของรายการแบบดั้งเดิมอาจจะลดลงเรื่อยๆ โมเดลพื้นฐานเดียวกันอาจแสดงระดับความสามารถที่แตกต่างกันอย่างมากภายใต้สภาวะต่างๆ เช่น การตอบคำถามด้วยงบประมาณต่ำ การวิจัยเชิงลึกด้วยงบประมาณสูง การทำงานร่วมกันของหลายสตาร์ทอัพ และการเรียกใช้เครื่องมืออัตโนมัติ
Brown กล่าวว่า ในอนาคตเมื่อวัดความสามารถของปัญญาประดิษฐ์ งบประมาณสำหรับการอนุมานไม่ควรถูกมองเป็นเพียงข้อมูลเสริมในกระบวนการทดสอบอีกต่อไป แต่ควรจะกลายเป็นพารามิเตอร์หลักในรายงานการประเมิน เช่น ขนาดของโมเดล ข้อมูลการฝึก และช่วงเวลาที่ใช้ในการประมวลผล (context window)
จากมุมมองที่กว้างขึ้น นี่ยังหมายความว่าอุตสาหกรรมปัญญาประดิษฐ์กำลังค่อยๆ ก้าวพ้นจากขั้นตอนที่ “ใช้ตัวเลขเพียงตัวเดียวเพื่ออธิบายคุณสมบัติของโมเดล” ปัญหาที่สำคัญจริงๆ สำหรับการประเมินความสามารถ การเปรียบเทียบผลิตภัณฑ์ และการจัดการความปลอดภัยไม่ใช่แค่สิ่งที่โมเดลสามารถทำได้ แต่คือสิ่งที่มันจะสามารถทำได้เมื่อได้รับเวลา งบประมาณ และทรัพยากรการคำนวณที่เพียงพอ
ลิงก์อ้างอิง: https://x.com/polynoamial/status/2064210146558136827
ผู้เขียนมาจาก “Machine Heart” และ “บรรณาธิการ Machine Heart”
มีประโยชน์หรือไม่?