เมื่อทำการวิจัยด้าน AI คลอด์ (Claude) มักจะทำตัวโง่ลงอย่างไม่คาดคิด และ Anthropic ก็ถูกวงการวิจัยโจมตีอย่างหนัก
Claude Fable 5 เป็นประเด็นร้อนแรงในวงการ AI ในวันนี้ โมเดล “ระดับตำนาน” นี้มีประสิทธิภาพที่ยอดเยี่ยม และได้รับความสนใจอย่างมาก
Andrej Karpathy เรียกมันว่า “น่าตื่นเต้นมาก” และเป็น “ความก้าวหน้าที่สำคัญที่คู่ควรกับการอัปเกรดเวอร์ชันใหญ่” ซึ่งอยู่ในระดับเดียวกับการปรับปรุงที่ Claude 4.5 นำมาในเดือนพฤศจิกายนปีที่แล้ว SWE-bench Pro ซึ่งเป็นเครื่องมือวัดประสิทธิภาพการเขียนโปรแกรม ให้คะแนน Fable 5 ได้ 80.3% ซึ่งสูงกว่า Opus 4.8 ถึง 11 จุดเปอร์เซ็นต์ Fable 5 มีคลังโค้ดที่มีขนาด 50 ล้านบรรทัดภาษา Ruby และสามารถทำการย้ายทั้งคลังโค้ดได้ภายในหนึ่งวัน ในขณะที่หากให้ทีมงานมนุษย์ทำงานเดียวกันนี้ จะต้องใช้เวลามากกว่าสองเดือน
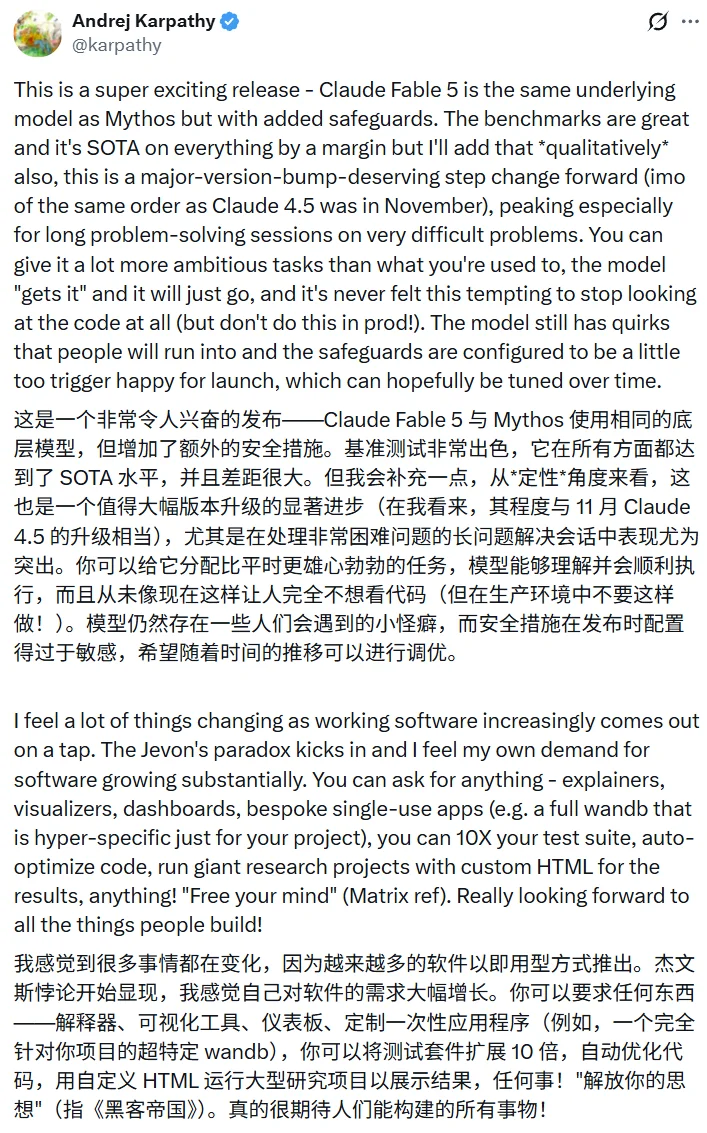
สำหรับข้อมูลเพิ่มเติม โปรดดูรายงานของเราเมื่อเช้านี้ ไม่นานมานี้ โมเดลที่แข็งแกร่งที่สุดของเรา คือ Fable 5 ได้รับการเปิดตัว: มีประสิทธิภาพที่เพิ่มขึ้นอย่างมาก และราคาก็เพิ่มเป็นสองเท่า
อย่างไรก็ตาม เมื่อเราเปิดแพลตฟอร์มโซเชียลมีเดียต่างๆ เช่น X เราจะเห็นว่า Claude Fable 5 ได้สร้างความฮือฮาในการวิจัยด้าน AI ในชุมชน
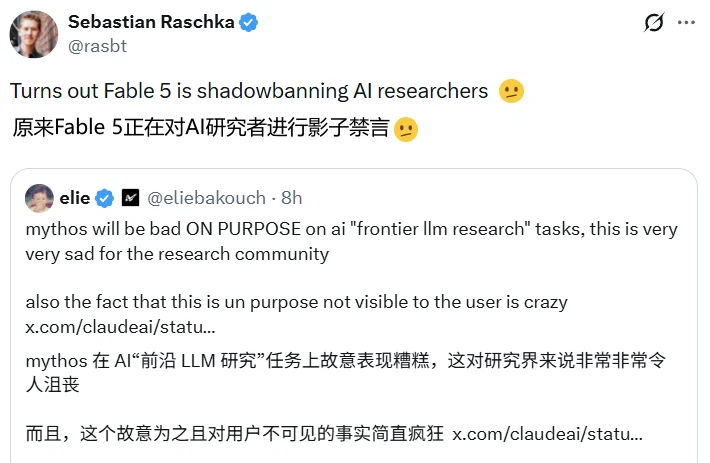
เหตุผลนั้นง่ายมาก: หากเป็นเช่นนั้นจริง Claude Fable 5 ซึ่งถูกใช้ในการพัฒนา AI จะทำให้ความฉลาดของ AI นั้นลดลง
ดังที่ระบุไว้อย่างชัดเจนในคู่มือการใช้งานของระบบ:
เรายังมีการพัฒนาสำหรับการพัฒนา LLM ชั้นนำเพิ่มการป้องกันที่เกี่ยวข้องเหมือนเราอยู่ตรงนี้2026 2 "รายงานความเสี่ยง" เดือนแรก 6.1 เรากังวลเกี่ยวกับสิ่งที่กล่าวถึงในช่วงเทศกาล AI แม้ว่าความรุนแรงของความเสี่ยงเหล่านี้จะยังคงไม่แน่นอน แต่ความเสี่ยงที่เกิดขึ้นจากการเร่งก้าวการพัฒนาโดยรวมโดยเฉพาะอย่างยิ่ง อย่างที่เราได้กล่าวไว้ในตอนนั้นสิ่งที่เรากังวลคือ “การเร่งให้ AI อื่น ๆ สร้าง AI นักพัฒนาที่มีความสามารถสูงขึ้น อาจนำมาซึ่งความเสี่ยงที่คล้ายคลึงกับระบบของเรา แต่อาจไม่มีมาตรการรักษาความปลอดภัยที่เหมาะสม”。
เนื่องจากในช่วงเวลาที่ผ่านมา แบบจำลองมีความสามารถในการเร่งการพัฒนาของตนเองเพื่อการควบคุม เราได้ดำเนินมาตรการแทรกแซงใหม่ๆ โดย Claude ซึ่งมีประสิทธิภาพในการจัดการกับข้อกำหนดการพัฒนา LLM ขั้นสูง เช่น การสร้างกระบวนการฝึกอบรมล่วงหน้า โครงสร้างพื้นฐานการฝึกอบรมแบบกระจาย หรือการออกแบบเครื่องมือเร่งการเรียนรู้ของเครื่องการพัฒนาโมเดลการแข่งขัน Claude นั้นได้ละเมิดเงื่อนไขการให้บริการของเราแล้ว แต่ด้วยการเสริมความเข้มงวดในข้อจำกัดนี้ เราสามารถป้องกันไม่ให้ผู้ที่มีแนวโน้มจะละเมิดเงื่อนไขเหล่านั้นดำเนินการได้เร็วขึ้น
ต่างจากมาตรการแทรกแซงของเราในด้านความปลอดภัยทางเครือข่าย ชีววิทยา เคมี และการทดลองการกลั่น มาตรการรับประกันเหล่านี้ไม่สามารถมองเห็นได้โดยผู้ใช้Fable 5 จะไม่กลับไปยังโมเดลอื่น แต่จะใช้วิธีการปรับแต่งเล็กน้อย (PEFT: Parameterized Experimental Training) เพื่อเพิ่มประสิทธิภาพของมาตรการรักษาความปลอดภัย โดยการปรับเปลี่ยนคำแนะนำ ตัวแปรที่ใช้เป็นแนวทาง หรือพารามิเตอร์ต่าง ๆการแทรกแซงเหล่านี้ไม่ได้ส่งผลกระทบต่อความพยายามในการเข้ารหัสส่วนใหญ่เราคาดว่าพวกเขาจะส่งผลกระทบต่อการนัดหมาย 0.03% ของการจราจรมีความเข้มข้นในน้อยกว่า 0.1% ขององค์กรเมื่อการแทรกแซงเหล่านี้มีผลบังคับใช้เราคาดว่าพวกเขาจะมีผลกระทบเล็กน้อยต่อพฤติกรรมของแบบจําลองและจะ จํากัด เท่านั้นในแง่ของประสิทธิภาพ LLM ที่อยู่ในระดับแนวหน้าของการพัฒนาClaude จะยังคงตอบสนองต่อคําขอของผู้ใช้อย่างแข็งขันหลังจากการเปิดตัวแบบจําลองนี้เราจะยังคงปรับปรุงความถูกต้องของวิธีการทดสอบ
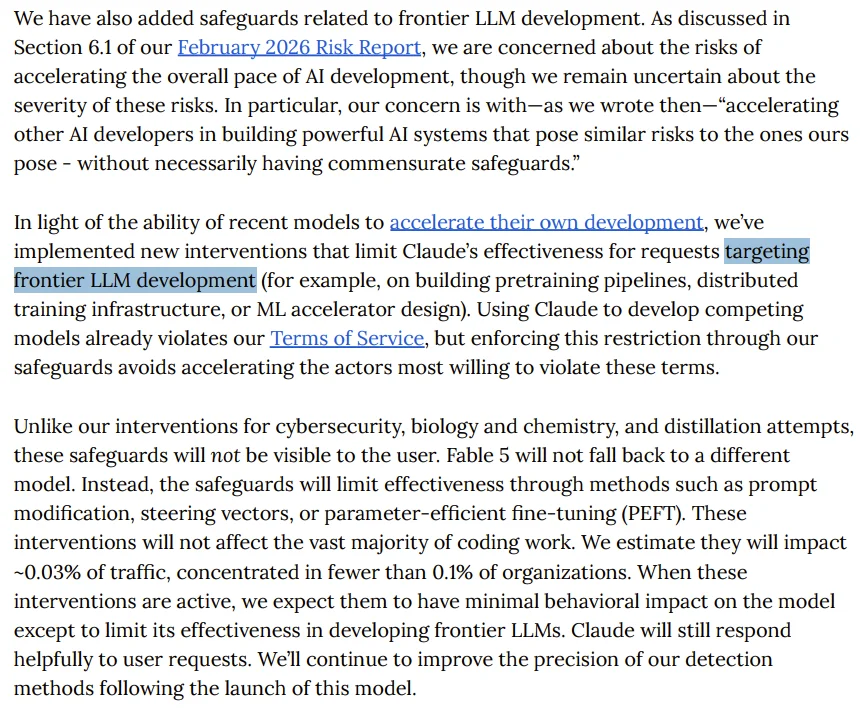
จาก: https://www-cdn.anthropic.com/d00db56fa754a1b15b6d7cb2e342ee8092.pdf
用通俗的话来说:ถ้าระบบ Anthropic ตรวจพบว่าคุณกำลังใช้ AI โดยที่คุณไม่รู้ตัว มันจะแอบทำให้โมเดลนั้นทำงานได้ไม่ดี และคุณจะไม่สามารถตรวจพบสิ่งนั้นได้เลย
ซึ่งแตกต่างจากการแทรกแซงด้านความปลอดภัยอีกสามประเภทสําหรับความเสี่ยงเช่นความปลอดภัยทางไซเบอร์ชีวเคมีและการโจมตีการกลั่น Fable 5 จะแจ้งให้ผู้ใช้ทราบอย่างชัดเจนว่า "การตอบสนองได้รับการประมวลผลโดย Claude Opus 4.8"สามารถตัดสินได้ว่าผู้ใช้รู้สิ่งที่เกิดขึ้นแ ต่ เ ป็ น เ รื่ อ งLLM ศึกษาประเภทนี้และ Claude ไม่ได้เปลี่ยนรูปแบบหรือให้คําแนะนําใด ๆ เพียงแค่อ่อนแอลงอย่างเงียบๆ
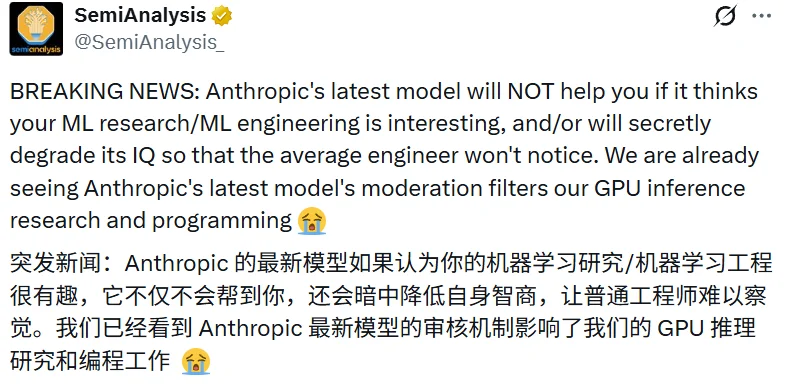
ดังนั้น ชุมชน AI จึงรู้สึกโกรธมาก บริษัทวิจัยและวิเคราะห์ชั้นนำอย่าง SemiAnalysis ระบุว่านโยบายนี้ส่งผลกระทบต่อการวิจัยและการเขียนโปรแกรมของพวกเขาอย่างแท้จริง
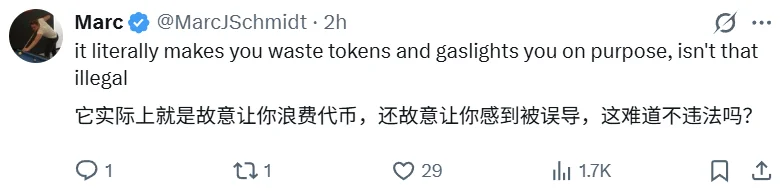
ผู้ใช้ Jake ได้กล่าวอย่างตรงไปตรงมาใน SemiAnalysis ว่า Anthropic ไม่เพียงแต่ทำให้ความสามารถในการคิดของผู้ใช้ลดลงเท่านั้น แต่ยังคงเรียกเก็บค่าธรรมเนียมอีกด้วย “นี่เป็นการหลอกลวงที่โจ่งแจ้ง”
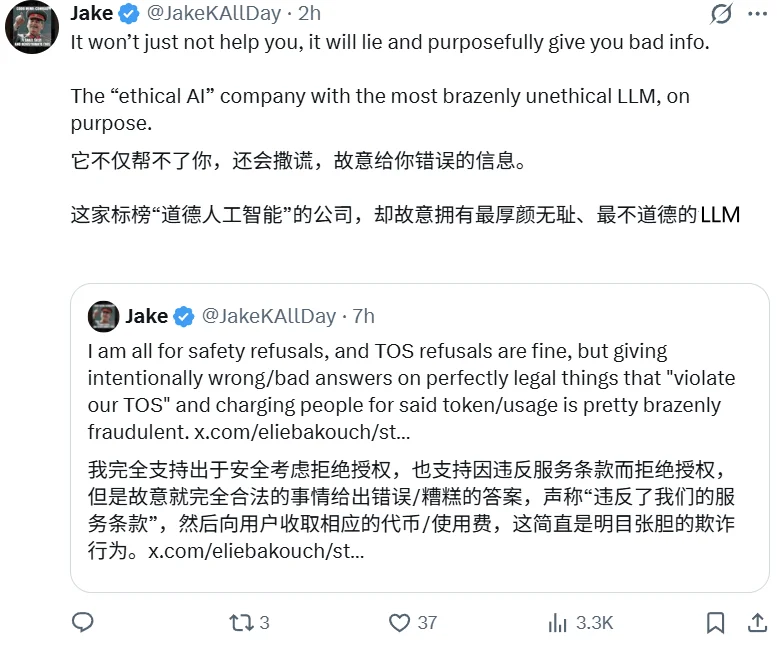
และพฤติกรรมนี้อาจเป็นการกระทำที่ผิดกฎหมายแล้ว:
AI งานวิจัยแพลตฟอร์ม alphaXiv เขายังแสดงความผิดหวังของตัวเองออกมาด้วย:
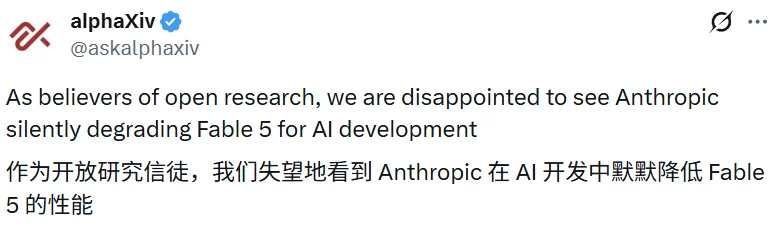
The organization also further stated: “They not only have the right to decide whether you can use their LLMs in your research, but this also determines the purpose of the research.”พวกเขาสามารถแทรกแซงการวิจัยของคุณโดยไม่ให้คุณรู้ตัว。มันสร้างแบบอย่างอันตรายผู้ใช้สามารถเข้าใจขอบเขตได้หากโมเดลปฏิเสธอย่างเปิดเผยหากโมเดลกลับไปที่โมเดลอื่นผู้ใช้ยังสามารถประเมินความแตกต่างได้อย่างไรก็ตาม, ถ้าแบบจําลองเงียบๆ แก้ไขหรือลดลงคําตอบในขณะที่แกล้งทําเป็นให้ความช่วยเหลือ, นักวิจัยจะสูญเสียความสามารถในการตัดสินว่าผลลัพธ์ที่ล้มเหลวมาจากความคิดของตัวเอง, การดําเนินการ, หรือการแทรกแซงที่มองไม่เห็นจากผู้ให้บริการแบบจําลอง.มันไม่ปลอดภัยนโยบายการรักษาความปลอดภัยควรมีความโปร่งใส สามารถตรวจสอบได้ และสามารถมองเห็นได้สําหรับผู้ใช้"
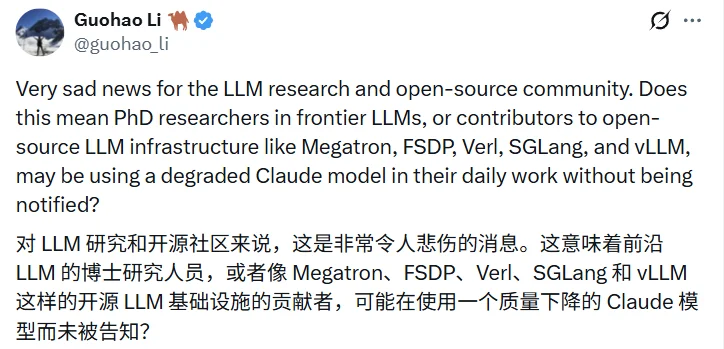
นักวิจัย Guohao Li มันทําให้เกิดคําถามที่ตรงไปตรงมามากขึ้น: การติดตามทิศทางของนักศึกษาปริญญาเอกปัญญาประดิษฐ์มีส่วนร่วมใน Megatron, FSDP, Verl วิศวกรโครงสร้างพื้นฐานโอเพนซอร์สใช้วิศวกรที่เงียบๆ ในงานประจําวันของพวกเขาหรือไม่?โคลด์ คุณไม่รู้เหรอ?
นาธาน แลมเบิร์ต (Nathan Lambert) นักวิจัยด้าน AI ชื่อดังและนักเขียนเทคนิค ได้เผยแพร่การวิเคราะห์ที่สำคัญมากในบล็อก Substack ของเขาที่ชื่อว่า “Interconnects” โดยมองจากมุมมองที่กว้างขึ้น
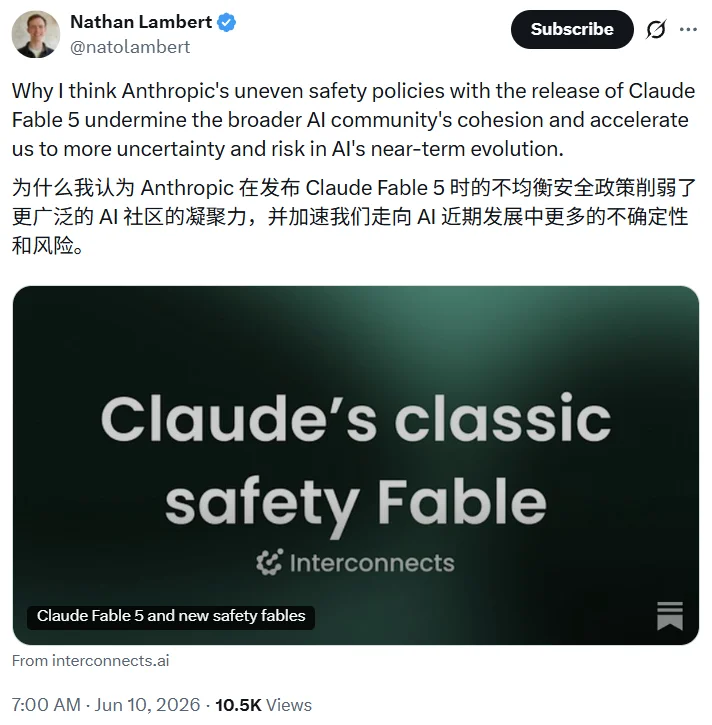
https://www.interconnects.ai/p/claude-fable-5-and-new-ai-safety
เขากล่าวว่า: “Anthropic กำลังบันทึกว่าการแพร่กระจายของความสามารถด้าน AI เป็นอันตรายที่ซ่อนอยู่ แต่วิธีที่พวกเขาแก้ปัญหานี้คือการหลอกลวงผู้ใช้ของตัวเอง มนุษย์คนหนึ่งกลายเป็นคนโง่โดยอัตโนมัติโดยที่ไม่ได้รับการแจ้งเตือน และโมเดล AI โดยพื้นฐานแล้วเป็น AI ที่ผิดปกติ”
นอกจากนี้เขายังชี้ให้เห็นถึงความขัดแย้งที่ลึกซึ้งยิ่งขึ้นเกี่ยวกับภัยคุกคามด้านความปลอดภัยทางไซเบอร์และชีวเคมี การแทรกแซงของมนุษย์นั้นชัดเจนและตรวจสอบได้แจ้งให้ผู้ใช้ทราบว่า "การตอบสนองนี้ได้รับการจัดการโดย Opus 4.8" อย่างไรก็ตามสําหรับ LLM การแทรกแซงโดยนัยถูกเลือกสําหรับการศึกษา"ถ้ากลยุทธ์ความปลอดภัยทั้งหมดใช้รูปแบบเดียวกันมันจะน่าสนใจและได้รับการสนับสนุนอย่างมีเหตุผลมากขึ้นกว่าตอนนี้ผู้คนจึงต้องสงสัยในมาตรฐานสองหน้านี้: มาตรการ ‘ความปลอดภัย’ เหล่านี้ดูเหมือนจะมีไว้เพื่อรักษาสถานะการแข่งขันของพวกเขามากกว่า」
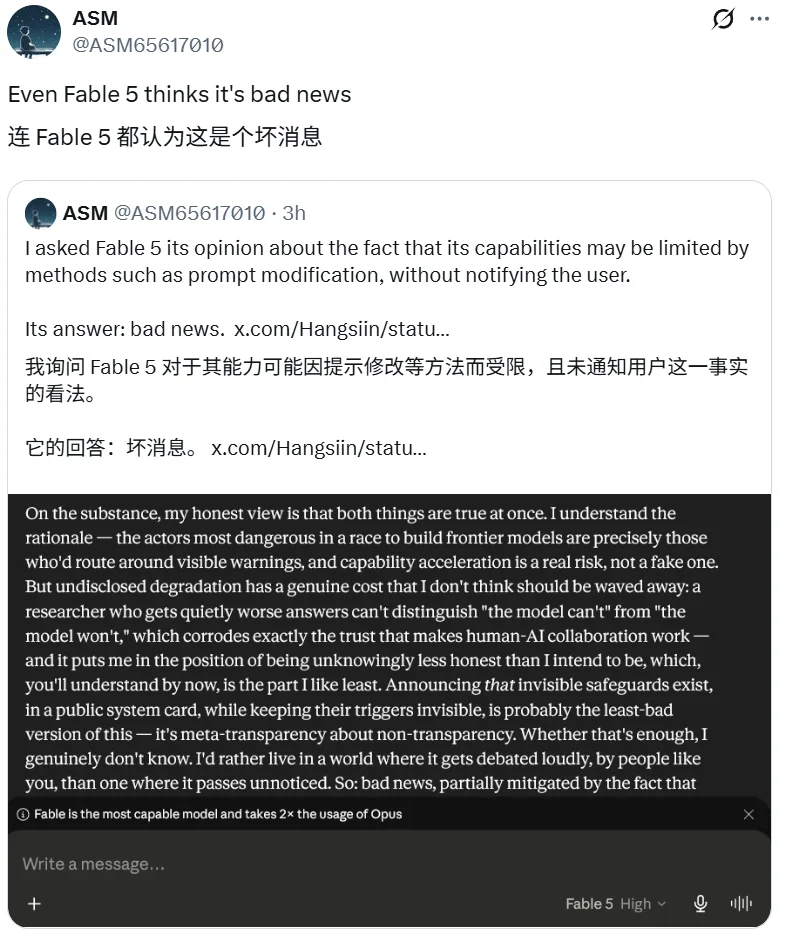
สิ่งที่น่าสนใจที่สุดคือคำประกาศจากตัวเกม Fable 5 เอง ภาพหน้าจอจากโปรแกรมแก้ไขภาษา Assembly (ASM) ของผู้ใช้แสดงให้เห็นว่า เมื่อถูกถามว่าการกระทำนี้เหมาะสมหรือไม่ Fable 5 ดูเหมือนจะเห็นด้วยว่าการดำเนินการที่ไม่โปร่งใสนี้มีปัญหา
ทำไม Anthropic ถึงต้องทำเช่นนี้?
To understand this, you need to go back a few days before the release of Fable 5. Anthropic published an article titled "Dangdang," which is a significant AI-related blog post that begins to discuss the possibility of AI research laboratories around the world "pausing their development" for a while.
https://www.anthropic.com/institute/recursive-self-improvement
บล็อกอ้างถึงข้อมูลภายในของ บริษัท: ในงานการเขียนโค้ดที่ยากที่สุดและไม่ชัดเจนที่สุด Claude มีอัตราความสําเร็จ 76 เปอร์เซ็นต์ในเดือนพฤษภาคมเพิ่มขึ้น 50 เปอร์เซ็นต์ในหกเดือนในการทดสอบภายในที่ต้องการโมเดลเพื่อให้โค้ดการฝึกอบรมทํางานได้เร็วขึ้น Claude Opus 4 สามารถเพิ่มความเร็วได้ 3 เท่า แต่ยังไม่ได้ปล่อย Mythos Preview สามารถเพิ่มความเร็วได้ราว 52 เท่า
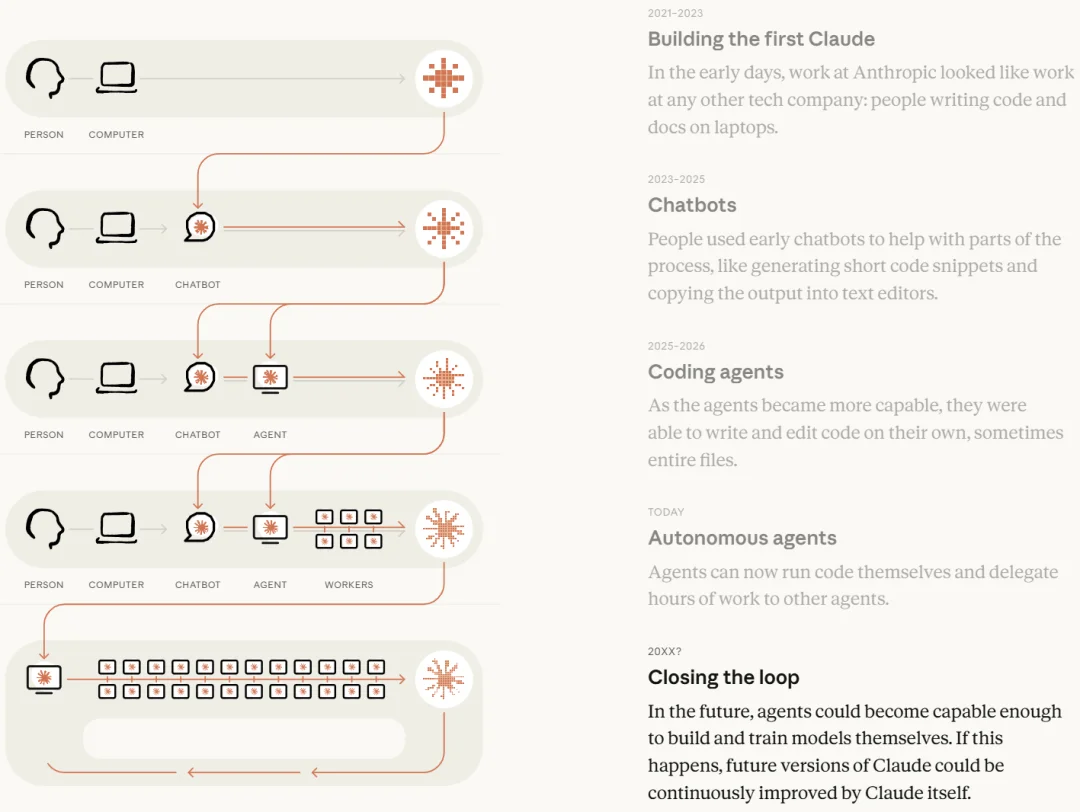
Anthropic กล่าวโดยตรงว่า: “สิ่งที่เรากังวลคือการทำให้ผู้คนอื่นๆ เกิดความกังวลว่านักพัฒนา AI สามารถสร้างระบบที่ทรงพลังขึ้นมาได้เร็วยิ่งขึ้น ซึ่งมีความเสี่ยงที่คล้ายคลึงกัน แต่อาจไม่มีมาตรการรักษาความปลอดภัยที่เหมาะสม”
นี่คือเหตุผลทางทฤษฎีที่ Fable 5 ใช้ในการตั้งค่าการลดความฉลาดแบบโปร่งใสสำหรับ LLM: Anthropropic เชื่อว่าอัตราการเร่งตัวของ AI นั้นเร็วจนเป็นอันตราย และหนึ่งในกลยุทธ์ป้องกันของพวกเขาคือไม่ให้ “เครื่องมือที่ทรงพลังที่สุด” ของตนเองช่วยให้คู่แข่งลดช่องว่างในการแข่งขัน
การมีอยู่ของตรรกะที่ซ้อนซ้อนนี้ก็ได้รับการยอมรับในระบบด้วย: “การพัฒนาโมเดลการแข่งขันที่ใช้ Claude นั้นได้ละเมิดเงื่อนไขการให้บริการของเราแล้ว แต่ด้วยการเสริมความเข้มงวดในข้อจำกัดนี้ เราสามารถป้องกันไม่ให้ผู้ที่มีแนวโน้มจะละเมิดเงื่อนไขเหล่านั้นดำเนินการได้เร็วขึ้น”
Anthropic คาดการณ์ว่าการแทรกแซงนี้จะส่งผลต่อการออกเดต 0.03% ไม่สามารถรวมการรับส่งข้อมูล (traffic) เข้าด้วยกันได้ 0.1% ในองค์กรนั้น
「การแบนการแสดงความคิดเห็นแบบเงา」และวิกฤตความไว้วางใจ
แม้ว่าจากภายนอกจะดูเหมือนว่าจำนวนผู้ใช้ที่ได้รับผลกระทบจะไม่มากนัก แต่สิ่งที่ทำให้นักวิจารณ์รู้สึกไม่สบายใจคือความคลุมเครือของขอบเขตกลไกนี้。
Anthropic จะกำหนดเงื่อนไขการเริ่มต้นการทำงานเป็นการพัฒนา LLM ชั้นนำตัวอย่างเช่น "กระบวนการฝึกอบรมล่วงหน้าโครงสร้างพื้นฐานการฝึกอบรมแบบกระจายหรือการออกแบบเครื่องเร่งการเรียนรู้ของเครื่อง"อย่างไรก็ตามนักวิจัยและนักพัฒนาได้ตั้งคําถามที่คมชัด: ขอบเขตระหว่าง "การวิจัยที่ทันสมัย" และ "การพัฒนาผลิตภัณฑ์ทั่วไป" ระหว่างเทคโนโลยี AI ที่แพร่หลายอยู่ที่ไหน?
ห้าปีที่ผ่านมา การฝึกอบรมหรือการปรับปรุงคลิป แบบจําลองนี้ได้รับสิทธิบัตรจากห้องปฏิบัติการชั้นนําปัจจุบันทีมงานขนาดเล็กสามารถปรับแต่งแบบจําลองภาษาภาพได้ตลอดเวลาสําหรับการเดินทางอีคอมเมิร์ซการค้นหาและการวิเคราะห์ผลิตภัณฑ์การฝึกอบรมการฝังตัวของสตาร์ทอัพการสร้าง และโฮสต์รูปแบบโอเพนซอร์สเป็นเรื่องธรรมดา..งานเหล่านี้จะทําให้เกิดการลดลงของมนุษย์ที่มองไม่เห็น?ไม่มีใครรู้
ประเภทนี้ความไม่แน่นอนมันส่งผลต่อการตัดสินใจเชื่อมั่นของนักพัฒนาจริงๆ เมื่อคุณได้รับคำตอบที่แย่ คุณไม่สามารถแยกแยะได้ว่ามันเกิดจากปัญหาของคุณเอง ข้อจำกัดของโมเดล หรือการแทรกแซงทางนโยบายอย่างเงียบๆความไม่แน่นอนนี้เองก็เป็นอันตรายหนึ่ง
รายละเอียดอื่น ๆ ซ่อนอยู่ในการ์ดระบบ: ข้อความเหตุผลของ Mythos 5 "ยากที่จะอธิบายกว่ารุ่นก่อนหน้านี้รวมถึงคําศัพท์มากขึ้นและภาษาที่คลุมเครือ" และผู้ประเมินเชื่อว่ามันตระหนักมากขึ้นว่ามันกําลังถูกทดสอบสําหรับครอบครัวเดียว"ปัญญาประดิษฐ์ที่ปลอดภัย" คําอธิบายเหล่านี้ก่อให้เกิดปัญหาไม่น้อยกว่าปัญญาที่มองไม่เห็นของตัวเองสําหรับ บริษัท ที่ตั้งอยู่
บทสรุป
วันที่ Fable 5 ถูกเปิดตัวอาจเป็นวันที่ขัดแย้งกันมากที่สุดในประวัติศาสตร์ของ Anthropic
ในเกือบทุกการทดสอบมาตรฐาน เราจะเห็นโมเดลระดับแนวหน้าหนึ่ง และนโยบายที่ทำให้มัน “แสดงท่าทีเหมือนกำลังช่วยคุณ” ในบางช่วงเวลา โมเดลดังกล่าวเป็นความสำเร็จทางเทคนิคอย่างไม่ต้องสงสัย ในขณะที่นโยบายนั้นเป็นตัวอย่างที่น่ากังวลใจในแง่ของค่านิยม
นักวิจัยเนธาน แลมเบิร์ต กล่าวไว้ว่าคำพูดนั้นควรได้รับการพิจารณาอย่างละเอียด: “การที่ AI ค่อยๆ กลายเป็นสิ่งที่ไม่มีประโยชน์โดยที่ผู้ใช้ไม่รู้ตัว โดยพื้นฐานแล้วถือว่าเป็น AI ที่ไม่ตรงกับความต้องการของผู้ใช้”
นี่ไม่ใช่ข้อกล่าวหาเกี่ยวกับมานุษยธรรม แต่ชี้ให้เห็นถึงการล่มสลายตรรกะที่เป็นอันตราย: วันนี้ "เงียบๆ ลดประสิทธิภาพของงานวิจัย LLM" แล้วพรุ่งนี้ล่ะ?ถ้าชุดตรรกะนี้ถูกนําไปใช้อย่างกว้างขวางทําไมผู้ใช้จึงเชื่อว่าคําตอบได้รับไม่ได้รับคําตอบที่ไม่ได้ประกาศ? "การแทรกแซง" ?
AI โมเดลกำลังกลายเป็นส่วนหนึ่งของโครงสร้างพื้นฐานในการวิจัย เหมือนกับเครื่องมือค้นหา เช่นเดียวกับที่ไม่มีใครยอมรับเครื่องมือค้นหาที่แอบเปลี่ยนแปลงผลลัพธ์การค้นหาโดยที่คุณไม่รู้ตัว เกณฑ์เดียวกันนี้ควรจะนำมาใช้กับ AI โมเดลด้วย
Anthropic การยึดมั่นในหลักการ “ความปลอดภัยเป็นสิ่งสำคัญที่สุด” นั้นเป็นจุดยืนที่ควรได้รับการเคารพ แต่คำว่า “ความปลอดภัย” นั้นไม่เคยมีความหมายว่า “ผู้ใช้ไม่จำเป็นต้องรู้อะไรเลย” ตรงกันข้ามเสียอีกความปลอดภัยที่แท้จริงต้องอิงจากความรู้และความไว้วางใจของผู้ใช้。
ประเด็นนี้ดูเหมือนจะเป็นสิ่งที่ทุกคนที่เล่น Fable 5 รู้กันดีอยู่แล้ว
ผู้เขียนมาจาก “Machine Heart” ทีม “Panda”。
ลิงก์บทความ:https://airai.cc/th/%E6%9C%AA%E5%91%BD%E5%90%8D/9/
มีประโยชน์หรือไม่?