GPT-5.6 การทดสอบจริงครั้งแรกมา!ความแม่นยําตํานาน
เมื่อสักครู่นี้ Anthropic ได้เปิดตัว “The Big Killer” ที่ถูกซ่อนเอาไว้เป็นเวลาสองเดือน…Claude Fable 5และMythos 5มันเหมือนกับการโยนระเบิดลงไป
ตอนนี้เราควรเริ่มกดดัน OpenAI โดยตรง
ในเวลาเดียวกัน GPT-5.6 ก็ถูกเปิดเผยออกมาเช่นกัน
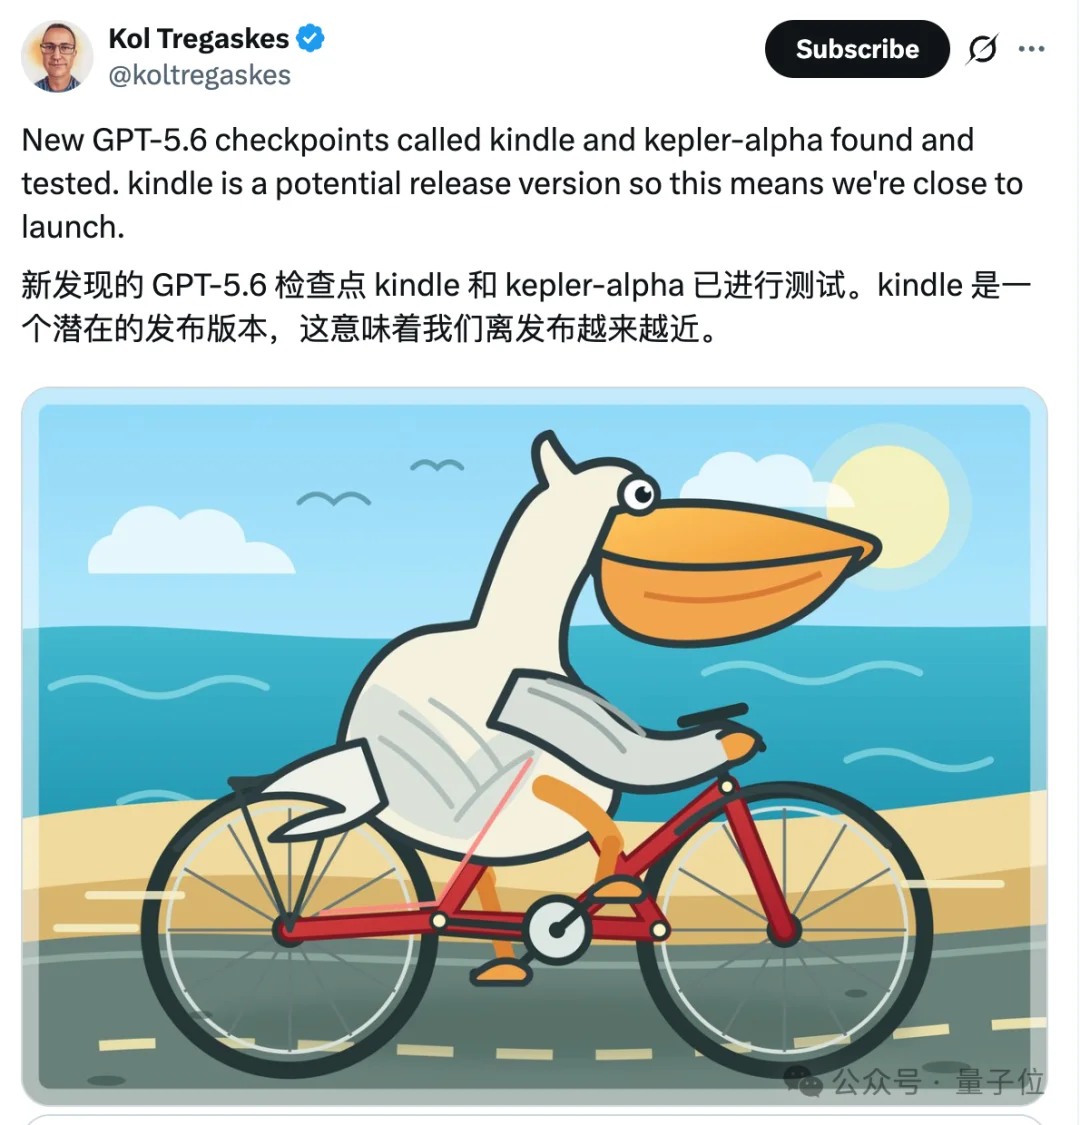
OpenAI เริ่มทดสอบโค้ดภายในตั้งแต่สัปดาห์ที่แล้วkeplerและkindleมีจุดตรวจสอบใหม่สองจุด โครงการ Kindle-alpha ที่ถูกเปิดเผยได้รับการคัดเลือกให้เป็นตัวเลือกสำหรับการเปิดตัว
เวอร์ชันทดสอบภายในของ GPT-5.6 เริ่มได้รับการวัดผลอย่างแพร่หลายในหมู่นักพัฒนาจากต่างประเทศและกลุ่มผู้ที่แชร์ข้อมูลลับ (leakers) โค้ด รุ่นทดลอง และข้อมูลเกี่ยวกับการใช้งาน (running sensations) ถูกเปิดเผยออกมาทั้งหมด
ไม่ว่าจะเป็นการแข่งขันเพื่อได้รับการจดทะเบียนหุ้น (IPO) หรือการที่รุ่นผลิตภัณฑ์ชั้นนำของทั้งสองบริษัทประสบปัญหา ทั้งสองบริษัทต่างก็ตอบสนองในลักษณะเดียวกัน คือ “ฉันก็จะยื่นใบสมัครเช่นกัน” และ “เมื่อคุณเปิดตัวรุ่นใหม่ ฉันก็จะเปิดตัวรุ่นใหม่เช่นกัน”
ความบริสุทธิ์ก็คือการต่อสู้กันอย่างดุเดือด
แต่ปัญหาคือ GPT-5.6 จริงๆ แล้วสามารถเอาชนะ Mythos ได้หรือไม่???
“GPT-5.6” ปรากฏขึ้น
จนถึงตอนนี้ OpenAI ได้เผชิญหน้ากับ GPT-5.6 แล้ว แต่ยังไม่มีการประกาศอย่างเป็นทางการใดๆ และยังไม่ได้รับการเปิดตัวอย่างเป็นทางการ
อย่างไรก็ตาม ยังมีผู้ใช้อินเทอร์เน็ตจากต่างประเทศจำนวนมากที่ยังไม่ทราบว่าการทดสอบโปรแกรมสอดแนม “จุดตรวจสอบภายใน” (internal checkpoints) ได้เสร็จสิ้นลงแล้ว
ที่เรียกว่า “จุดตรวจสอบ” (checkpoint) คือสำเนาของพารามิเตอร์ที่โมเดลจัดเก็บไว้ในช่วงเวลาหนึ่งระหว่างกระบวนการฝึกอบรม
ภายใน OpenAI จะมีหลายเวอร์ชันที่ถูกสร้างขึ้นมา จากนั้นจะมีการเปรียบเทียบเวอร์ชันเหล่านั้นกันแนวนอน และเลือกเวอร์ชันที่ “ดีพอที่จะนำไปเผยแพร่” ซึ่งเวอร์ชันนั้นจะถูกเรียกว่า “เวอร์ชันที่เป็นตัวเลือกสำหรับการเผยแพร่” (Release Candidate หรือ RC)
ตั้งแต่สัปดาห์ที่แล้ว เอ็นเจไอไอ (OpenAI) ได้ทำการทดสอบจุดตรวจสอบ (checkpoints) ใหม่สองจุดภายในองค์กร โดยมีชื่อรหัสว่า “kindle” และ “kepler”kindle-alphaเวอร์ชันที่เลือกได้รับการเลือกและถูกเผยแพร่แล้ว。
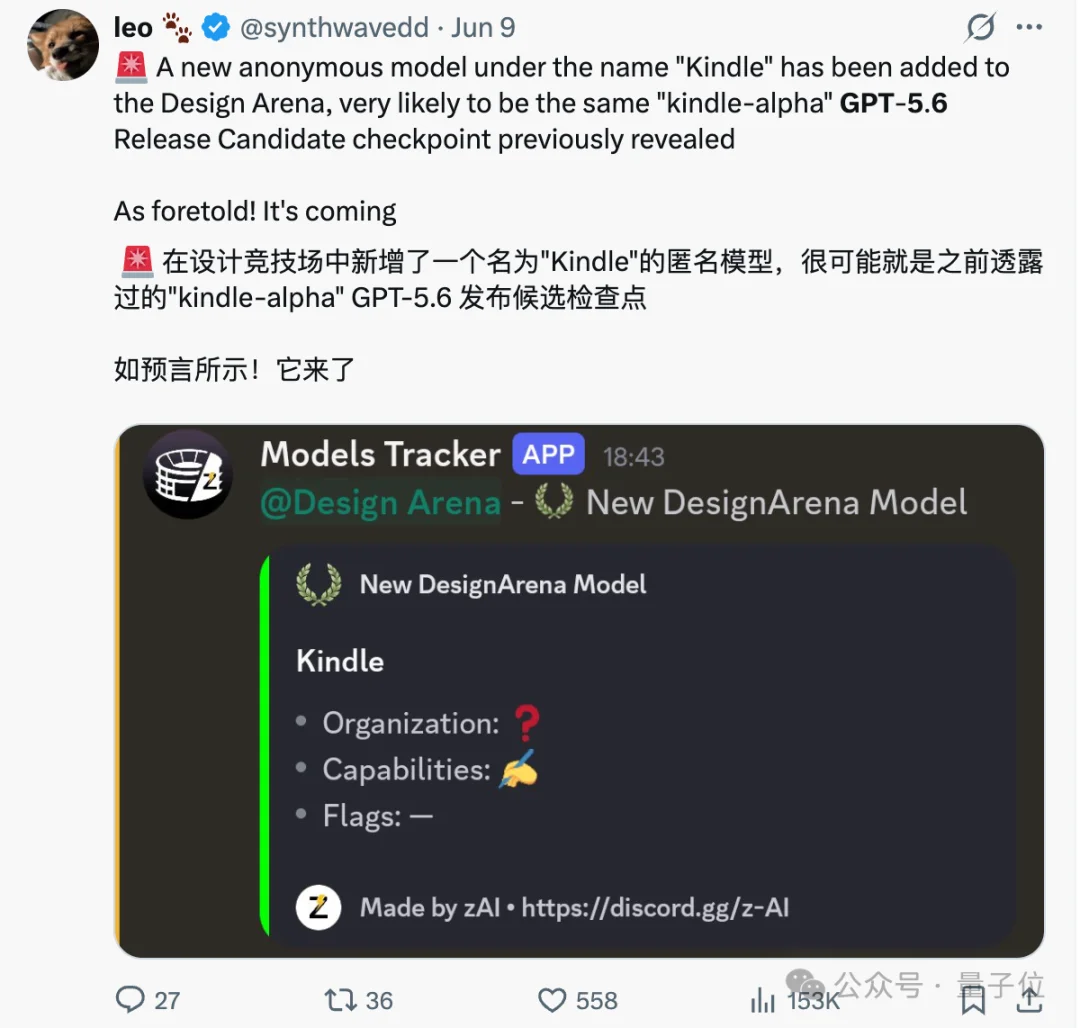
จากข้อมูลที่ไหลออกมาเกี่ยวกับประสบการณ์การใช้งาน การอัปเกรดที่ถูกกล่าวถึงบ่อยที่สุดในครั้งนี้คือ GPT-5.6Generate front-end/UI。
ความคิดเห็นของผู้ใช้งาน Pankaj Kumar คือ Kindle ได้เพิ่มประสิทธิภาพในการสร้างเนื้อหาด้านหน้า (frontend generation) ของ Alpha อย่างมากสามารถแสดงผลอินเทอร์เฟซที่มีประสิทธิภาพมากขึ้นได้โดยตรง โดยไม่จำเป็นต้องใช้คำแนะนำที่ซับซ้อนหรือทักษะเพิ่มเติม。
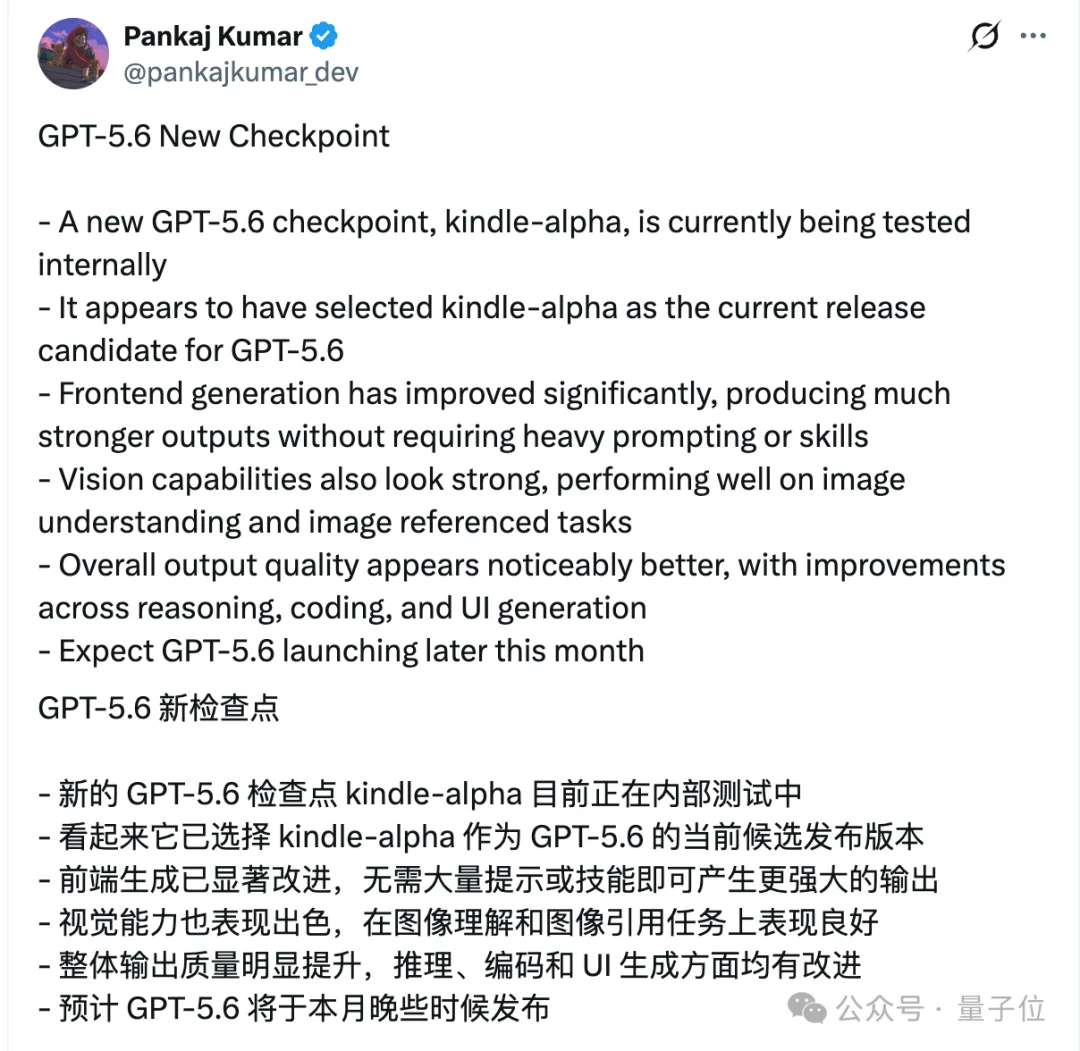
นอกจากนี้ ความสามารถทางด้านการมองเห็นของมันก็ยอดเยี่ยมมาก มีประสิทธิภาพดีในการเข้าใจภาพและการอ้างอิงภาพ และยังมีการปรับปรุงอย่างมีนัยสำคัญในด้านการอนุมาน การเข้ารหัส และการสร้างอินเทอร์เฟซผู้ใช้ (UI)
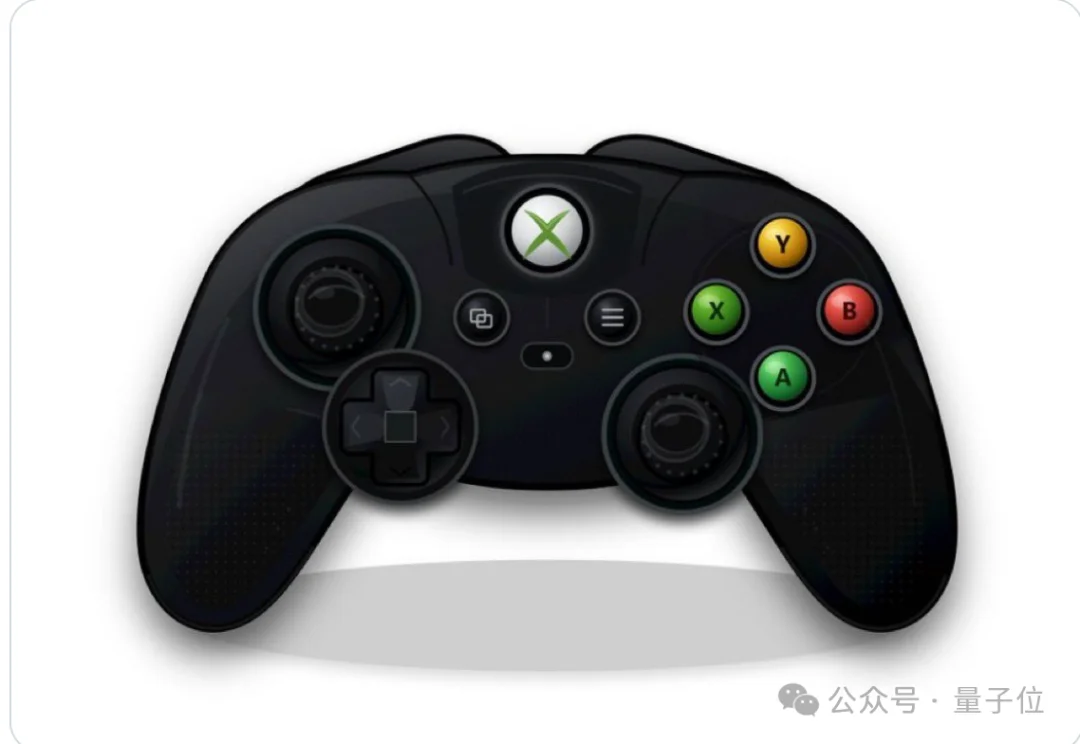
นี่คือผลการทดสอบการใช้งาน Kindle โดยผู้ใช้งานคนหนึ่งชื่อ Chris โดยเขาใช้ระดับความเร็ว (speed setting) ที่ระดับ “medium”:
นี่คือผลลัพธ์ที่อีกหนึ่งผู้ใช้งานเคยวัดไว้ก่อนหน้านี้บนเวอร์ชัน Joule ที่ไม่ใช้สำหรับการตัดสินใจ (non-reasoning version):
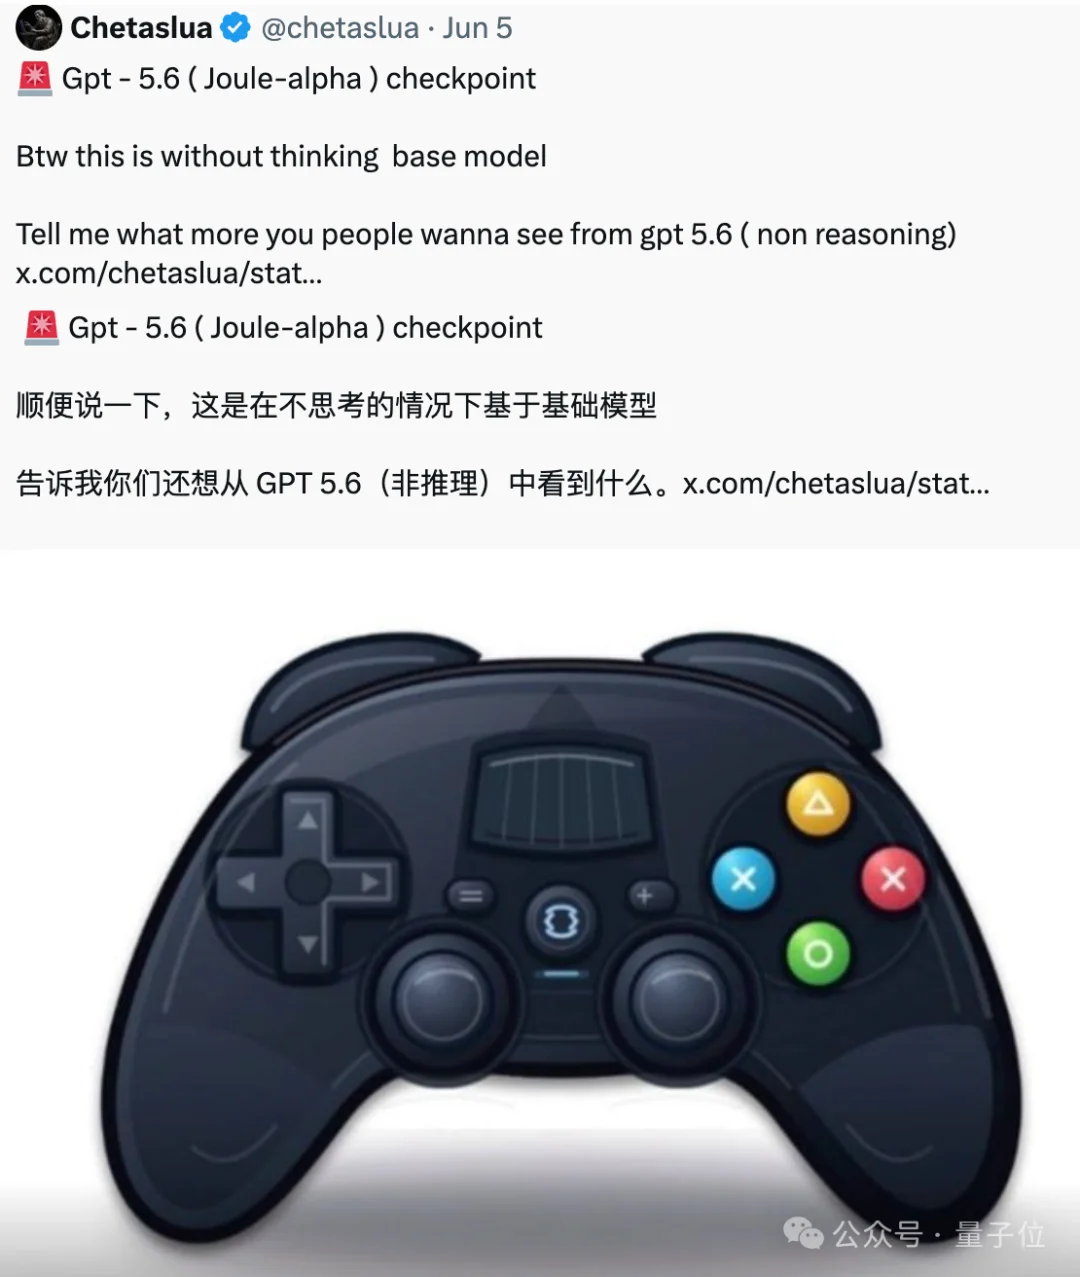
เห็นได้ชัดว่าอันแรกนั้นดูประณีตกว่ามาก
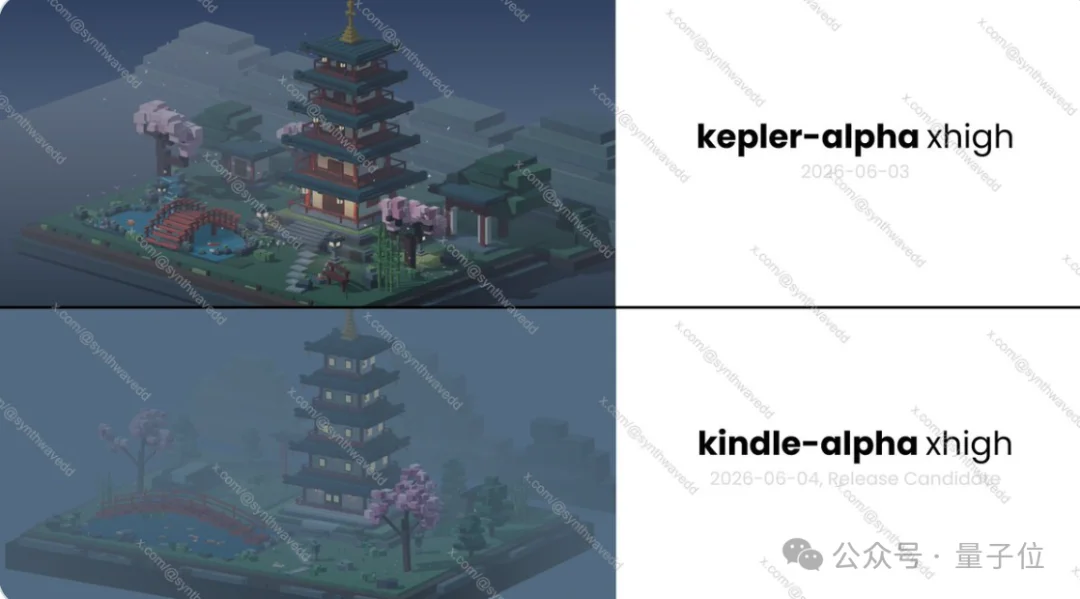
แต่ผู้ใช้งานอินเทอร์เน็ตชื่อ Leo ใช้ prompt เดียวกัน รวมถึงเครื่องมือ Kepler และ Kindle เพื่อทำการวัดในโหมด xhigh ด้วยกัน
เมื่อเทียบกับ Kepler พบว่า Kindle ยังคงมีการถอยหลังอยู่
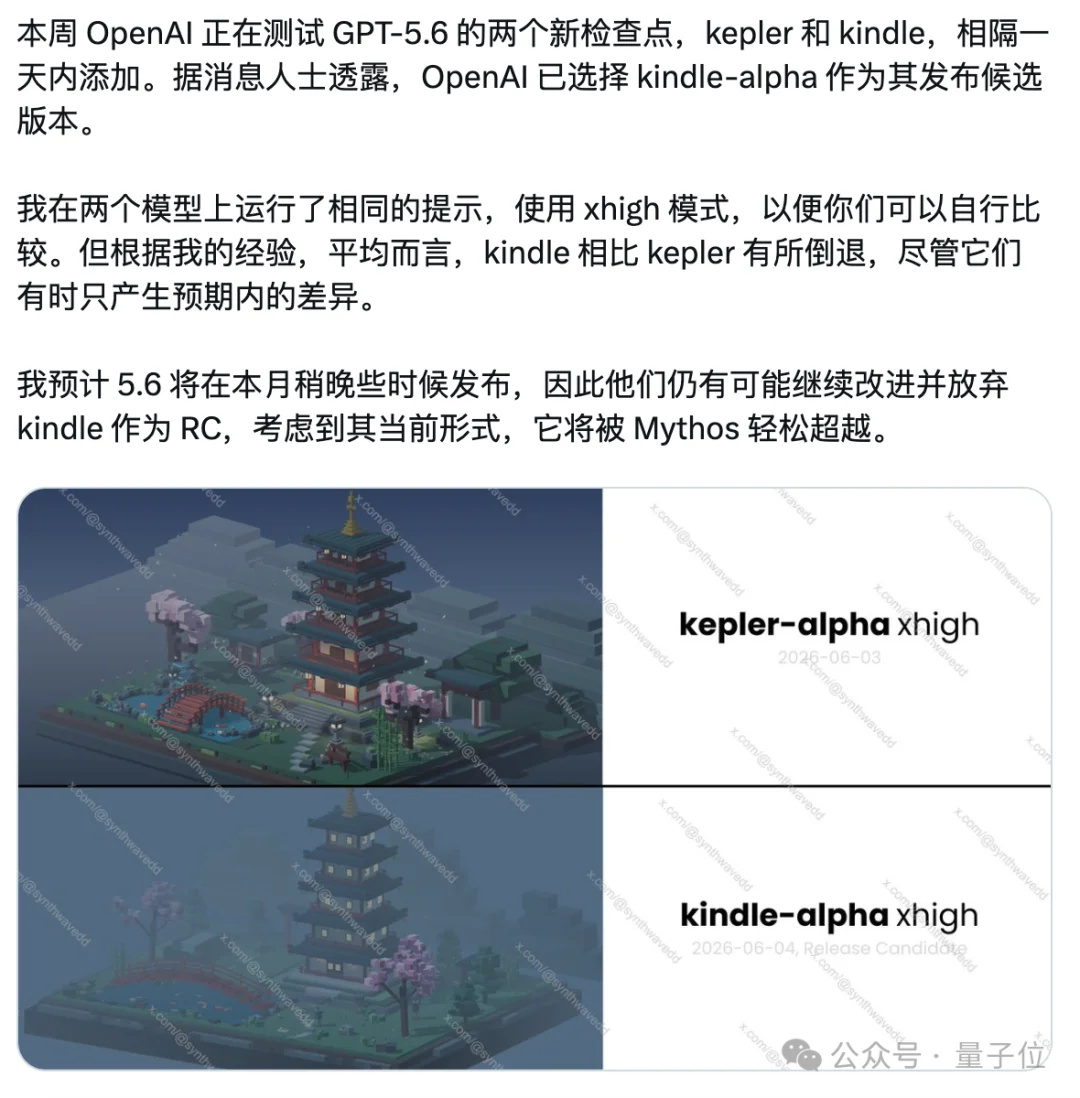
เอ่อ... ผลลัพธ์แบบนี้มันยากจริงๆ ที่จะประเมินได้
เขาแม้กระทั่งคาดการณ์ว่า OpenAI น่าจะยังคงพัฒนาต่อไปอีกไม่ได้ปฏิเสธความเป็นไปได้ที่ในที่สุดอาจจะเลิกใช้ Kindle ในฐานะหนึ่งในตัวเลือก。
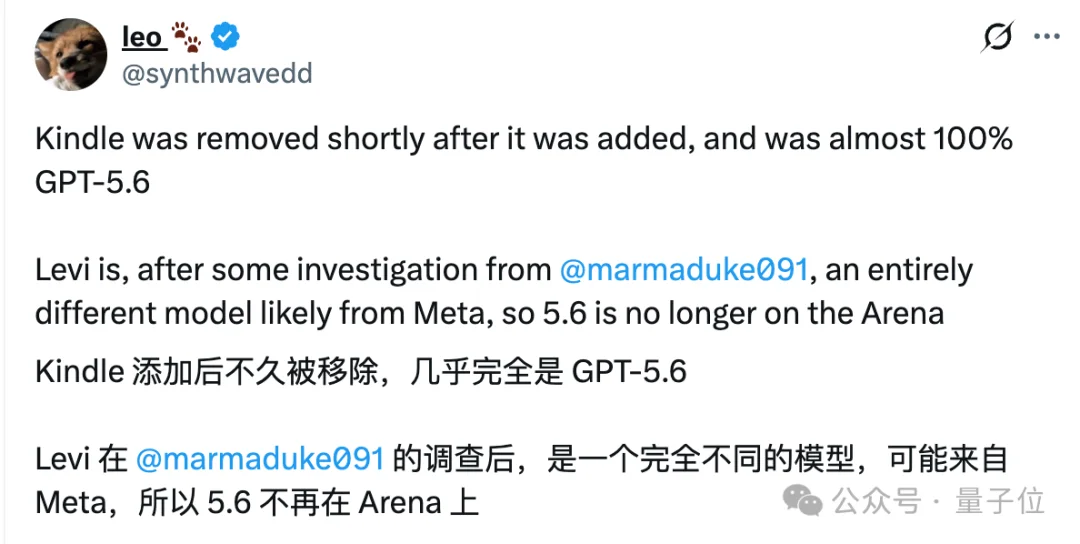
ข่าวล่าสุดคือ Kindle ถูกนำออกจาก Arena แล้ว และมีการเปิดตัวรุ่นใหม่Levi。
มีผู้ใช้งานบางคนเดาว่า “Levi” อาจเป็นรหัสสำหรับเวอร์ชันภายในของ “GPT-5.6” และได้เปรียบเทียบความสามารถด้านเฟรนต์เอนด์ของมันกับ “GPT-5.5” ด้วย:
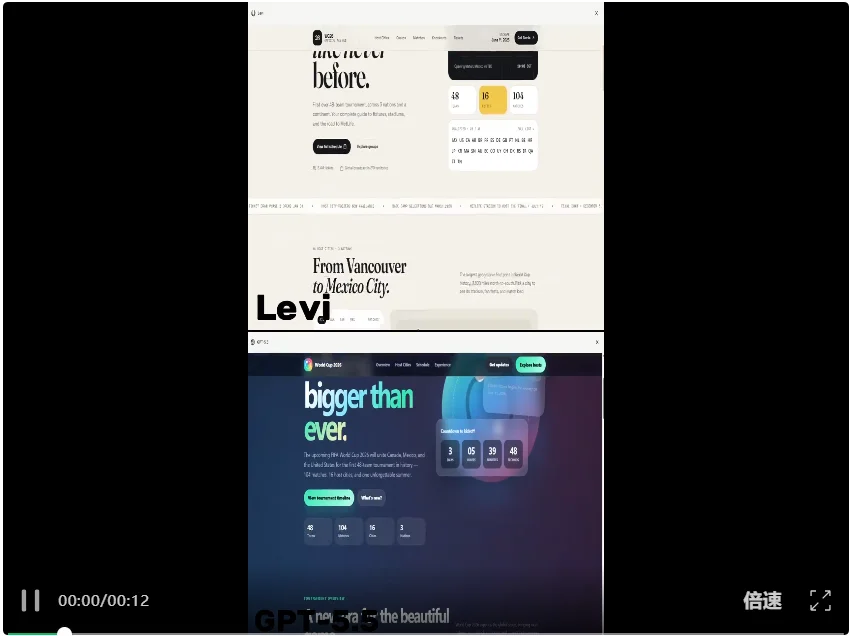
จากที่เห็นได้ ฟรอนต์เอนด์ของ Levi ก็ดีมากเช่นกัน มีสไตล์ที่สดใสและเรียบง่าย ให้ความรู้สึกสูงส่ง และการจัดการรายละเอียดก็ทำได้อย่างดีเยี่ยม
แต่มีผู้ใช้งานอินเทอร์เน็ตบางคนพบว่า Levi อาจมาจาก Meta ไม่ใช่ GPT-5.6
แล้ว GPT-5.6 สามารถเอาชนะ Mythos ได้จริงหรือไม่?
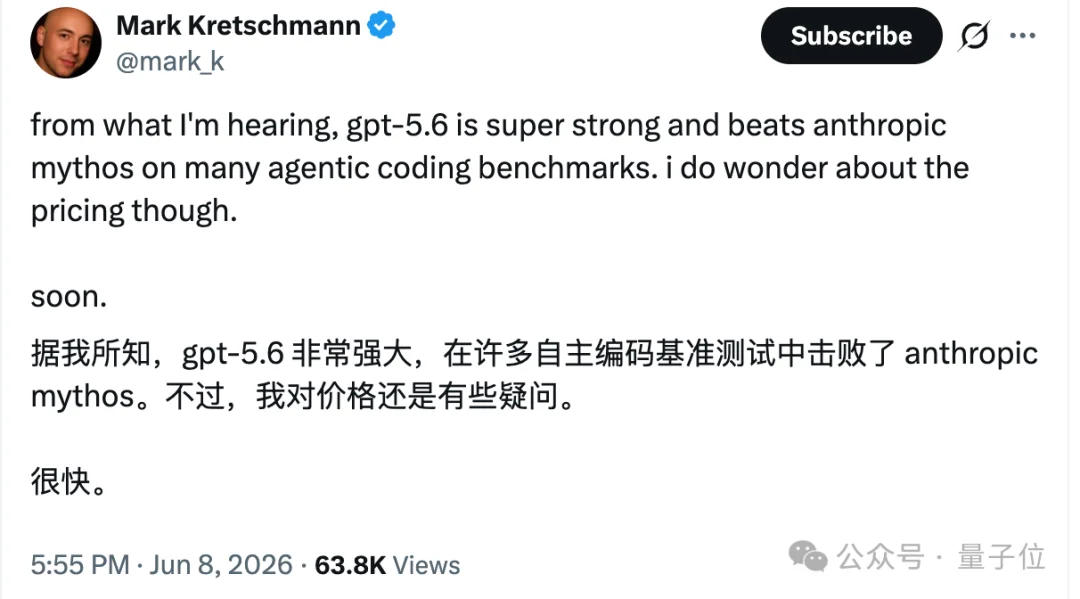
ผู้ใช้งานอินเทอร์เน็ต mark_k อ้างว่า GPT-5.6 “หลายตัวแทนสามารถเอาชนะเกณฑ์การทดสอบการเขียนโค้ดของ Mythoss ได้”
แต่ในขณะนี้ สิ่งที่น่าเชื่อถือมากกว่าคือผลการทดสอบจริงจากผู้ใช้งาน Leo ที่แสดงไว้ก่อนหน้านี้ เขาเชื่อว่าสถานการณ์ของ GPT-5.6 นั้นไม่ค่อยดีนัก:
เมื่อเทียบกับ Kepler แล้ว Kindle ถือว่าเป็นการถอยหลัง ในรูปแบบปัจจุบันของมันถูก Mythos เอาชนะได้อย่างง่ายดาย。
มิถุนายนนี้ สามตระกูลใหญ่ได้แสดง "The Fast and the Furious"
มิถุนายน ฤดูร้อนมาถึงแล้ว และวงการของโมเดลขนาดใหญ่ (big models) ก็เริ่มคึกคักขึ้นเช่นกัน
เวลาที่แบบจำลอง AI ชั้นนำจากต่างประเทศสามแบบถูกเปิดตัวนั้นตรงกันพอดี: Fable 5, Gemini 3.5 Pro, GPT-5.6 ทำให้เกิดการแข่งขันที่ดุเดือดเหมือน “การแข่งขันความเร็วระหว่างชีวิตและความตาย”
และเกมเหล่านี้ใช้ความสามารถเดียวกัน ได้แก่ การอนุมาน อัจฉริยะ การเข้ารหัส และการสร้างเนื้อหาด้านหน้าเว็บ (front-end generation)
ที่น่าสนใจคือ แม้ว่าทั้งสามบริษัทจะเน้นไปที่จุดนั้นในเดือนมิถุนายน แต่จนถึงตอนนี้ มีเพียงบริษัท A เท่านั้นที่ส่งเอกสารการสอบจริงๆ。
Gemini 3.5 Pro ได้รับการเปิดตัวในงาน Google I/O วันที่ 19 พฤษภาคม โดยมุ่งเน้นไปที่การประมวลผลข้อมูลในปริมาณ 2 ล้านโทเค็น (tokens) และระบบการอนุมานแบบ Deep Think
แต่ยังไม่ได้เปิดให้บริการอย่างเป็นทางการ ทางการกำหนดว่าจะเปิดให้ใช้งานได้ในเดือนมิถุนายน
GPT-5.6 ข่าวดังกล่าวระบุว่าจะถูกเผยแพร่ในช่วงปลายเดือนนี้
นี่ยังเพิ่มความตึงเครียดให้กับสถานการณ์ของ OpenAI อีกด้วย: คู่แข่งได้เปิดเผยคะแนนแล้ว และภายในอาจยังคงมีการถกเถียงกันว่าควรส่งเวอร์ชัน RC ใดออกไป
แต่นอกเหนือจากการทดสอบความเร็ว (การวัดประสิทธิภาพ)การกำหนดราคาก็เป็นปัจจัยสำคัญอีกประการหนึ่งเช่นกัน
Fable5.Mythos5 การกำหนดราคาที่เป็นมาตรฐานToken10ดอลลาร์สหรัฐToken50ดอลลาร์สหรัฐ
ประมาณสองเท่าของ Opus ที่มีอยู่ในปัจจุบัน
ถ้า GPT-5.6 มีความสามารถเทียบเท่ากับ Mythos หรืออาจจะต่ำกว่าเล็กน้อย แต่มีราคาถูกกว่ามาก มันก็ยังมีโอกาสที่จะช่วยเพิ่มอัตราการใช้งานจริงในเมืองหนึ่งได้~
ณ ตอนนี้ OpenAI ยังไม่ได้มีการประกาศอย่างเป็นทางการ การดวลจริงๆ จะต้องรอจนกว่าเวอร์ชันเต็มรูปแบบของ GPT-5.6 และ Fable จะถูกนำมาทดสอบอย่างเป็นทางการ ——
น่าจะมีคำตอบในเดือนนี้แหละ โปรดรอดูกันนะ~
ลิงก์อ้างอิง:
[1]https://x.com/mark_k/status/2063922897341567488?s=20
[2]https://x.com/AiBattle_/status/2064078302394917157?s=20
[3]https://x.com/pankajkumar_dev/status/2063272015214354908?s=20
[4]https://x.com/synthwavedd/status/2063245096951160865?s=20
[5]https://x.com/ChrissGPT/status/2063135842906808579?s=20
[6]https://x.com/koltregaskes/status/2062806155139912164?s=20
ผู้เขียนมาจาก “ควอนตัมบิต” ชื่อ “ฟังฝน”。
มีประโยชน์หรือไม่?