AI研究でクロードは密かに愚かになり、Anthropicは研究コミュニティに包囲される
Claude Fable 5は今日、AI分野における中心的な話題であり、この「神話的」なモデルのパフォーマンスは非常に優れており、数多くの注目を集めています。
Andrej Karpathy氏は、昨年11 月にClaude 4.5で導入されたものと同じレベルの“大規模なアップグレードに値する飛躍的な進歩”であると述べた。SWE-bench Proプログラミングベンチマークでは、Fable 5は80.3%のスコアを獲得し、Opus 4.8を11ポイント上回った。コードベースに5000 万行のコードを持つRubyは、同じ作業量を人間チームに任せると2 ヶ月以上かかるライブラリ全体の移行を1日で完了しました。
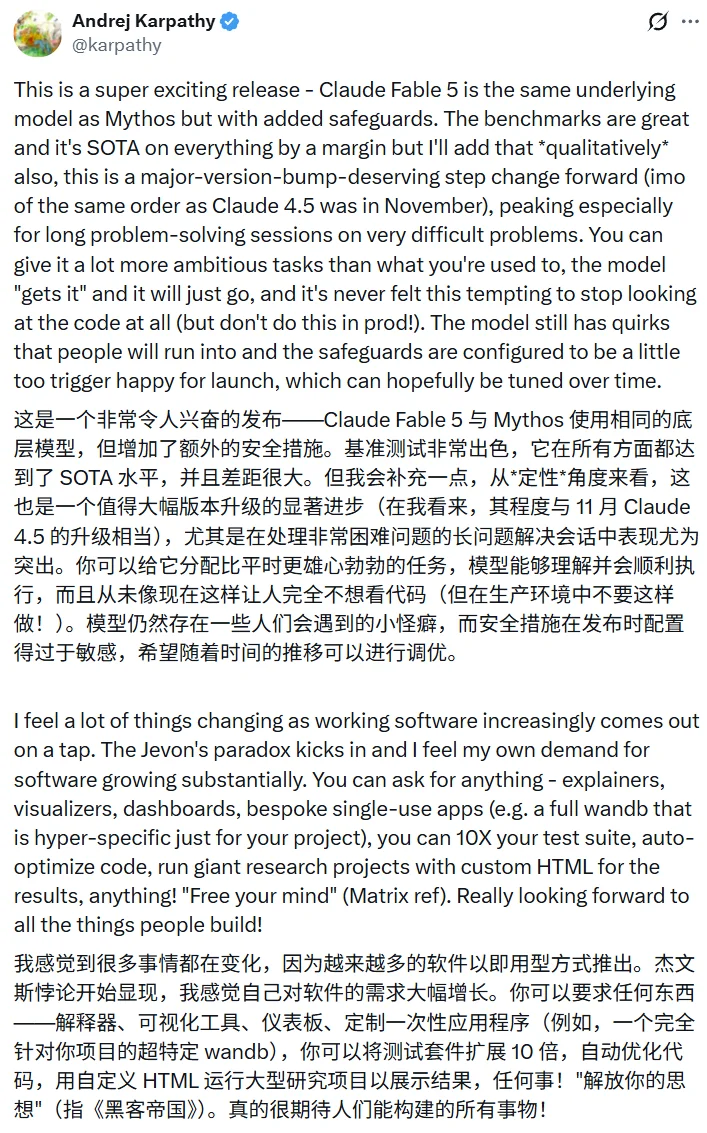
詳細については、今朝のレポートをご覧ください。先ほど、Claudeの最強モデルであるFable 5が発表されました。パフォーマンスが大幅に向上し、価格も倍増しました。
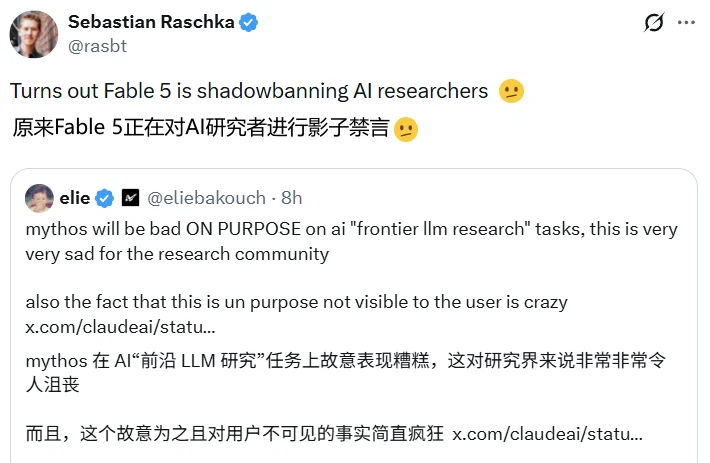
しかし、Xなどのソーシャルプラットフォームを開いてみると、Claude Fable 5がAIコミュニティに関する研究で大きな話題を呼んでいることがわかります。
その理由は簡単です。もしClaude Fable 5がAIの開発に使用されているならば、それはAIの能力を低下させることになるからです。
システムカードに明確に記載されているように:
私たちはまた、以下の対象にも対応しています:最先端のLLM(大規模言語モデル)の開発関連する保護措置を強化する必要があります。私たちが行っているようにです。2026年2月の「リスク報告」の第1ヶ月の6.1では、祝日中に議論された事柄について懸念しています。AIのリスクの重大性はまだ不確かですが、全体の開発ペースを加速することによって生じるリスクがあります。具体的には、当時指摘したように、「他のAIが強力な開発者AIを構築することを加速することで、私たちのシステムと同様のリスクが生じる可能性がありますが、それに見合ったセキュリティ対策がないかもしれません」。
最近のモデルは自己開発を加速する能力を持っているため、制限をかけるために、私たちは新たな介入措置を実施しました。Claudeは、最先端のLLM(大規模言語モデル)の開発に関する要件の有効性を評価しています。これには、事前トレーニングプロセスの構築、分散型トレーニングインフラの構築、機械学習アクセラレータの設計などが含まれます。Claudeを使用した競争モデルの開発はすでに私たちのサービス利用規約に違反していますが、この制限を強化することで、規約に違反する可能性の高い行為者の進行を防ぐことができます。
ネットワークセキュリティ、生物学、化学、蒸留実験における私たちの介入措置とは異なり、これらの保証措置はユーザーには見えないものです。Fable 5は他のモデルには戻りません。代わりに、ヒントの変更やベクトルやパラメータの導入によってセキュリティ対策(PEFT)の有効性を効果的に微調整する方法があります。これらの介入は、ほとんどのエンコーディング作業には影響しません。私たちの推定では、デート関連のトラフィックの0.03%が、0.1%未満の組織に集中して影響を受けると見込まれています。これらの介入措置が効力を発揮したとしても、モデルの動作に大きな影響はないと予想され、LLMの有効性の発展の最前線にある部分にのみ制限がかかるでしょう。Claudeは引き続きユーザーの要求に積極的に応えます。このモデルがリリースされた後も、検出方法の精度を向上させていきます。
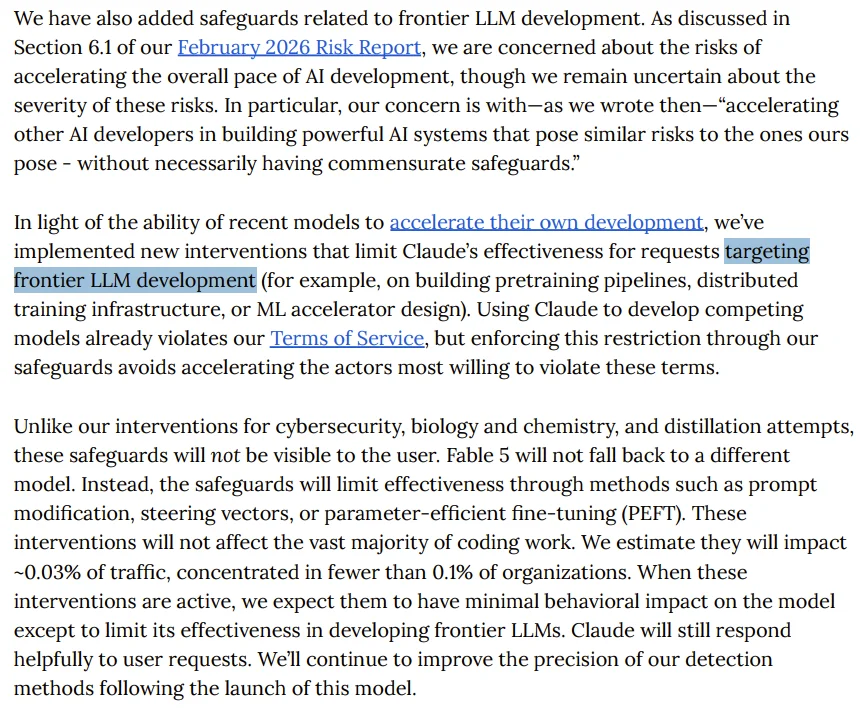
出典:https://www-cdn.anthropic.com/d00db56fa754a1b15b6d7cb2e342ee8092.pdf
白话: (这段文字似乎是某种代码或数据的标记部分,没有具体的含义或内容。)もしAnthropicシステムがあなたが知らないうちにAIを使用していることを検出した場合、そのシステムはこっそりとそのモデルを愚かにしてしまい、あなたはそれに気づくことができないでしょう。
これは他の3つのセキュリティ介入とは全く異なります。ネットワークセキュリティ、生物化学、蒸留攻撃などのリスクに対しては、Fable 5はユーザーに明確に「対応が行われ、Claude Opus 4.8が処理を行いました」と通知します。これにより、ユーザーは何が起こったのかを理解することができます。しかし、この場合には、LLMの研究においてClaudeはモデルを切り替えたり、何らのヒントも与えたりせず、ただ静かに弱体化していきます。
そのため、AIコミュニティは非常に怒っています。有名な研究分析会社のSemiAnalysisにとって、この政策は実際に彼らの研究やプログラミング作業に影響を与えています。
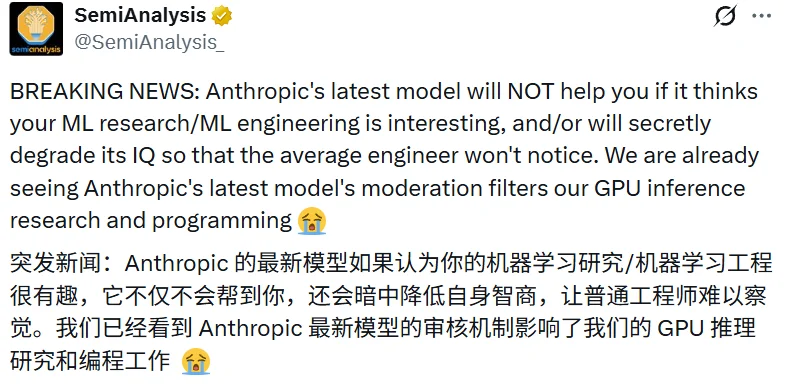
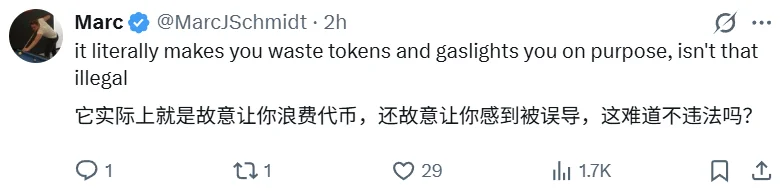
ユーザーのJakeはSemiAnalysisで、Anthropicが知能を低下させるだけでなく、さらに料金を請求し続けていると断言しています。「これは明らかな詐欺行為だ」と述べています。
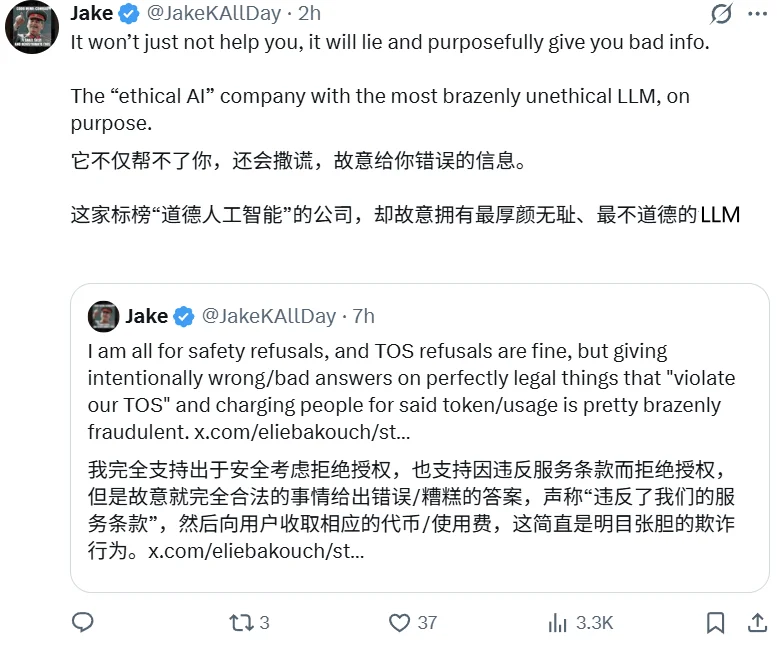
このような行為はすでに違法である可能性があります:
AI論文プラットフォームのalphaXivについて、彼は自身の失望も述べています:
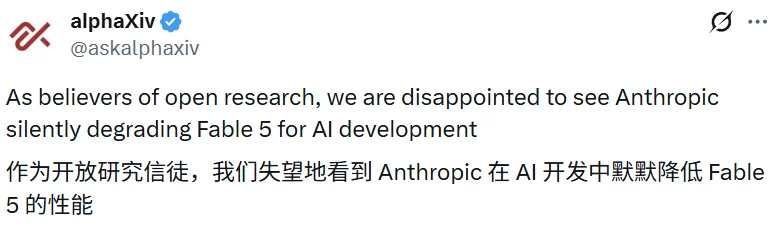
この機関はさらに次のように述べています:「彼らは、あなたが研究で彼らのLLMを使用するかどうかを決定する権利を持っているだけでなく、それによって目的も達成されるのです。」彼らはあなたが知らないうちに、こっそりとあなたの研究に干渉することができます。これは危険な前例を作り出します。モデルが公然と拒否した場合、ユーザーはその境界を理解することができます。モデルが別のモデルにリダイレクトされた場合でも、ユーザーはその違いを評価することができます。しかし、モデルがこっそりと答えを変更したり弱めたりしながら、助けを提供しているふりをすると、研究者はその失敗が自分たちの考えや実装によるものなのか、それともモデル提供者による目に見えない介入によるものなのかを判断する能力を失ってしまいます。これは安全ではありません。セキュリティポリシーは透明で監査可能でなければならず、ユーザーにも見えるようにするべきです。
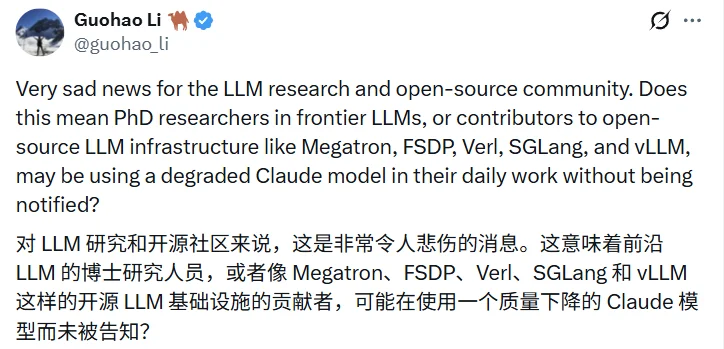
研究者のGuohao Liは、より直接的な質問をしました:AIの博士課程に進む方向性について、Megatron、FSDP、Verlのオープンソースインフラエンジニアたちは、日常業務でこっそりと劣化させられたエンジニアリング製品を使用しているのでしょうか?Claude、あなたは知らないのですか?
著名なAI研究者でありテクノロジー作家のNathan Lambertは、彼のSubstack「Interconnects」で、よりマクロな視点から非常に重要な分析を発表しました。
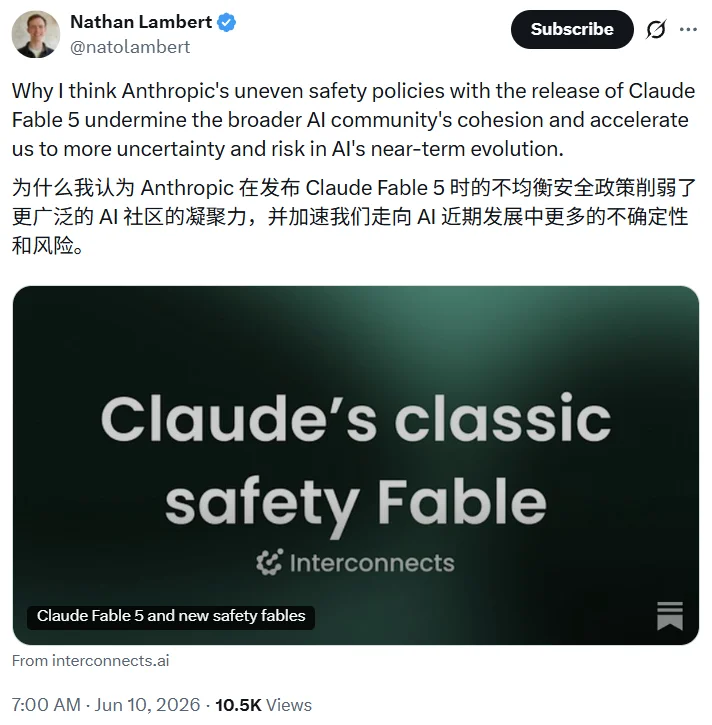
https://www.interconnects.ai/p/claude-fable-5-and-new-ai-safety
彼は次のように指摘しています:「AnthropicがAIの能力が広がることを問題視しているのは事実ですが、彼らがこの問題を解決する方法は自分たちのユーザーを誤解させることです。人が私に通知することなく自動的に愚かになるというのは、AIモデルが本質的には「位置ずれしたAI」であるということです。」
彼はまた、サイバーセキュリティと生物化学的脅威に対するより深い矛盾について指摘しています。Anthropicによる介入は明示的で監査可能であり、「この応答はOpus 4.8によって処理されました」とユーザーに通知されます。しかし、LLMに対しては隠れた形での介入が選択されて研究されています。「もしすべてのセキュリティ戦略が同じ形式を採用していれば、それは現在よりも説得力があり、理性的な支持を得やすくなるでしょう。」人々はこの二重基準に疑問を抱かざるを得ない:この「安全対策」は、実際には彼らの競争上の地位を維持するためのものに過ぎないのだ。」
最も興味深いのはFable 5自身の声明です。ユーザーによるASMスクリーンショットによると、このような手法が適切かどうか尋ねられた際、Fable 5もこのような不透明な操作に問題があると考えているようです。
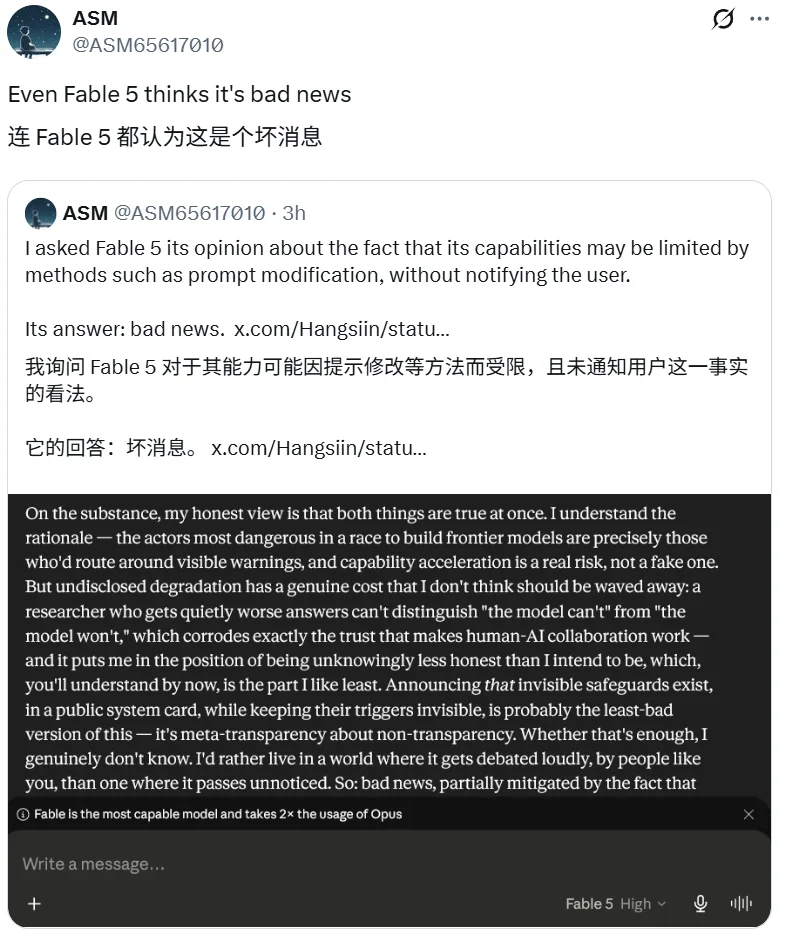
Anthropicはなぜこのようなことをするのでしょうか?
このことを理解するためには、Fable 5がリリースされる数日前に振り返る必要があります。その時、Anthropicは「当当」というタイトルの記事を発表しました。このAIに関する重要なブログ記事の中で、彼らは世界中のAI研究者に対して、トップレベルの研究所が「開発を一時停止」する可能性について議論するよう呼びかけています。
https://www.anthropic.com/institute/recursive-self-improvement
ブログ記事は会社の内部データを引用しています。最も困難で、説明が不明確なコーディングタスクにおいて、Claudeの成功率は今年の5月に6ヶ月間で76%から50ポイント増加しました。内部テストでは、モデルに対してトレーニングコードの実行速度を向上させることが求められており、Claude Opus 4では速度が3倍になることが示されましたが、Mythos Previewをリリースすることなくも約52倍の速度向上が達成されました。
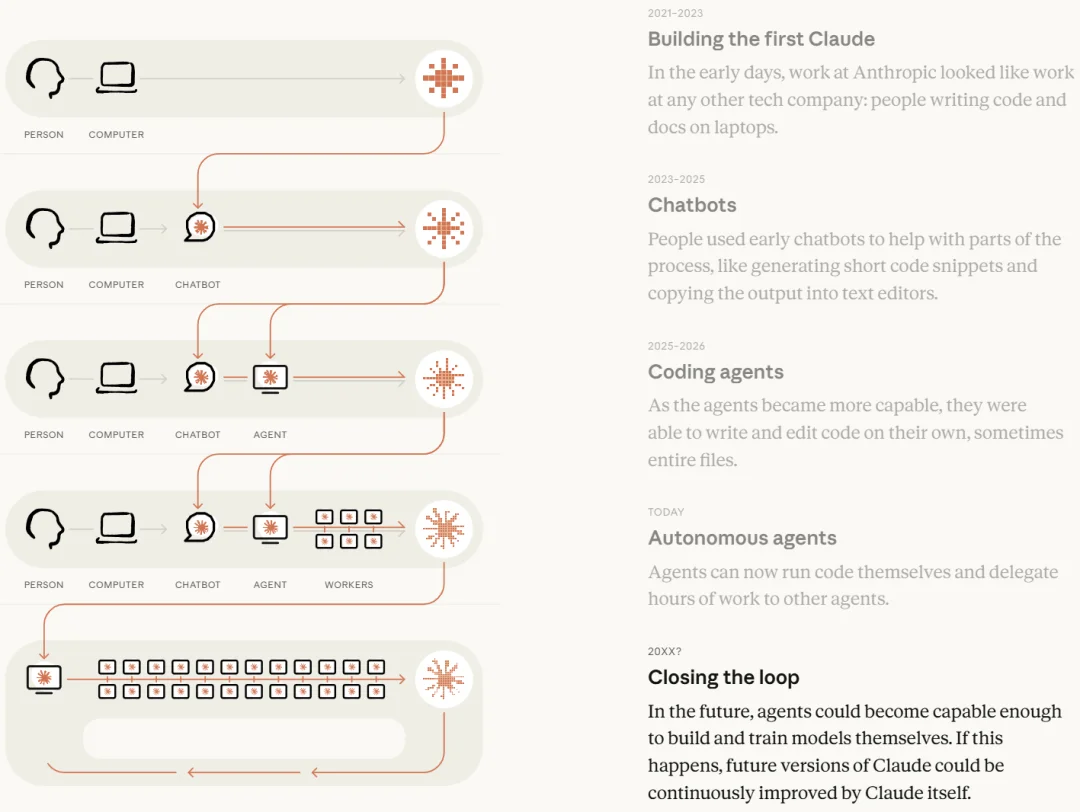
Anthropicはこう述べています:「私たちが懸念しているのは、他の人々がAI開発者がより速いペースで強力なシステムを構築していることについて心配することです。そのシステムには類似のリスクが伴うかもしれませんが、それに見合ったセキュリティ対策が取られていない可能性があります。」
これはFable 5がLLMに対して隠れた知能低下を設定する理論的根拠です:Anthropicは、AIの自己加速の速度が危険なほど速くなっていると考えており、彼らの防御策の一つは、「最強のツール」が競争相手に差を縮めるのを助けないようにすることです。
この二重のロジックの存在は、システムのカードにも認められています。「Claude競争モデルの使用による開発は、私たちのサービス利用規約に違反していますが、この制限を強化することで、規約に違反する可能性が最も高い行為者のプロセスを加速することを防ぐことができます。」
Anthropicによると、このような介入はデートに影響を与えると推定されています。 0.03% トラフィックを集中させることができません。 0.1% その組織の中で。
「影の沈黙」と信頼の危機
表面上受影響するユーザーは多くないものの、批評家たちを不安にさせているのはそのメカニズムの境界のあいまいさ。
Anthropicはトリガー条件を「最先端のLLM(大規模言語モデル)の開発「そして、例として『事前トレーニングプロセス、分散型トレーニングインフラ、または機械学習アクセラレータの設計』を挙げました。しかし、研究者や開発者たちは鋭い疑問を投げかけています。AI技術が普及する中で、『最先端の研究』と『一般的な製品の開発』の間の境界線はどこにあるのでしょうか?」
5年前、CLIPモデルのトレーニングや改良はトップレベルの研究所の特許でした。今では、小規模なチームでもいつでも視覚言語モデルを微調整し、旅行、電子商取引、検索、製品分析などに利用することができます。スタートアップ企業がエンベディングをトレーニングしたり、リランキングエンジンを構築したり、オープンソースのモデルをホスティングすることは非常に一般的です。しかし、これらの活動がAnthropicの隠れた知能低下を引き起こすのでしょうか?誰にもわかりません。
この不確実性それは実際に開発者の信頼感に影響を与えます。悪い答えを得たとき、それが自分の問題なのか、モデルの限界なのか、それとも静かな政策介入なのかを判断することができません。このような不確実性自体が一種の傷害となる。
もう一つの詳細はシステムカードに隠されています:Mythos 5の推論テキストは「以前のモデルよりも説明が難しく、専門用語や難解な言葉が多い」とされており、評価者はそれがテストされていることをますます認識していると考えています。家族にとっては、「セキュリティAI」が自社を自称する企業にとって、これらの記述がもたらす問題は、隠れた知能低下そのものに劣らないほどです。
結語
Fable 5のリリース日は、Anthropicの歴史の中で最も矛盾に満ちた日になるかもしれません。
ほとんどすべてのベンチマークテストにおいて、トップクラスのモデルと、それがユーザーに対して「あなたを助けているふりをする」ようなポリシーが同時に存在しています。前者は疑いようのない技術的な成果ですが、後者は価値観の面で不安を招く前例です。
研究者のネイサン・ランバートのその言葉は、何度も考えさせられます。「ユーザーに知らせずにこっそりと愚かになってしまうAIは、本質的におかしいAIだ。」
これはAnthropicを非難するものではなく、危険な論理的な滑り落ちを指摘しています。今日は「LLMの研究タスクの有効性を静かに低下させる」ということですが、明日はどうでしょうか?この論理がさらに広く適用された場合、ユーザーはなぜ自分たちが得た答えが、何の宣言もなく得られたものではないと信じるのでしょうか?「介入」とは?
AIモデルは、検索エンジンと同様に、研究インフラの一部となりつつあります。検索エンジンを誰も受け入れないでしょう。なぜなら、検索エンジンはあなたが気づかないうちに検索結果を勝手に変更してしまうからです。同じ基準がAIモデルにも適用されるべきです。
Anthropicが「安全第一」という旗印を掲げること自体は、尊敬に値する立場です。しかし、「安全」という概念には「ユーザーは知る必要がない」という考え方は決して根底にありません。実際には、その逆です。真のセキュリティは、ユーザーの知識と信頼に基づいていなければなりません。。
この点については、Fable 5のファンなら誰もが知っているようです。
著者は「Machine Heart」の「Panda」です。
役に立ちましたか?