Claude diam-diam menjadi bodoh ketika dia melakukan penelitian AI, dan Anthropic dikepung oleh komunitas penelitian.
Claude Fable 5 merupakan topik utama dalam bidang AI hari ini, dan model “mitos” ini memiliki kinerja yang sangat luar biasa, sehingga menarik banyak perhatian.
Andrej Karpathy menyebutnya “sangat menarik” dan merupakan “perkembangan yang signifikan yang layak untuk dijadikan alasan pembaruan versi besar”, sebanding dengan peningkatan yang dibawa oleh Claude 4.5 pada bulan November tahun lalu. Dalam pengujian benchmark pemrograman SWE-bench Pro, Fable 5 mendapatkan skor 80,3%, yang 11 poin persentase lebih tinggi daripada Opus 4.8. Dengan kodebase yang terdiri dari 50 juta baris kode dalam bahasa Ruby, Fable 5 berhasil melakukan migrasi seluruh kodebase dalam satu hari, sementara jika pekerjaan yang sama diberikan kepada tim manusia, akan membutuhkan waktu lebih dari dua bulan.
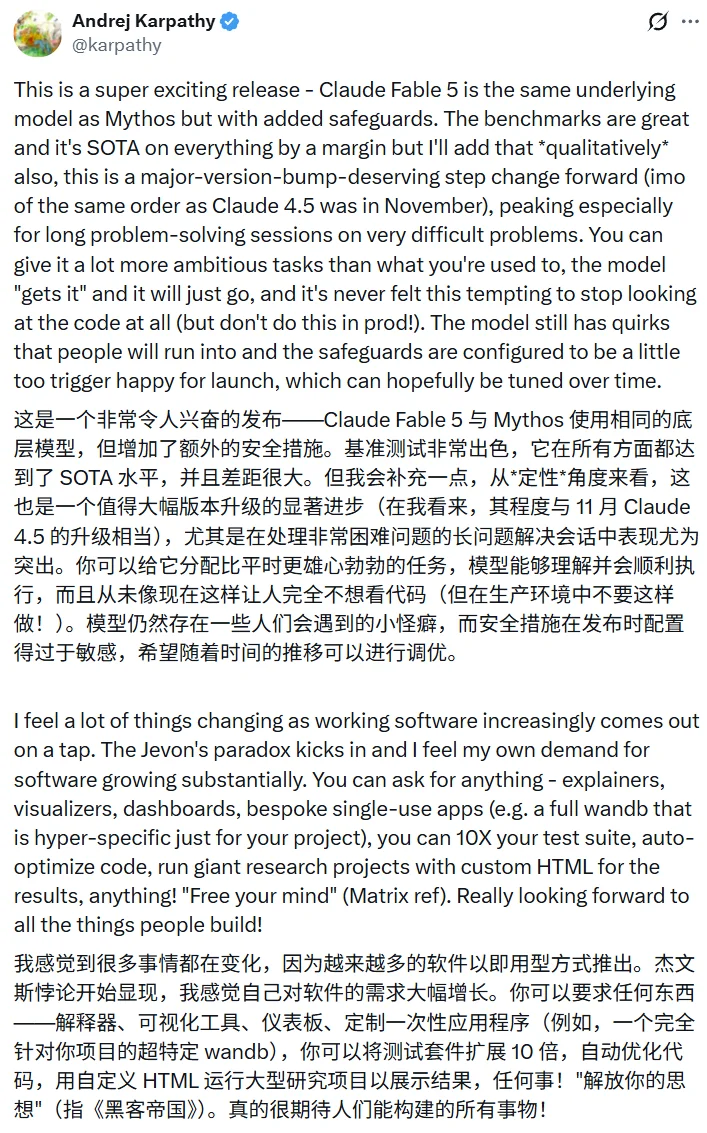
Untuk informasi lebih lanjut, silakan lihat laporan kami tadi pagi. Baru saja, model terkuat kami, Claude Fable 5, telah dirilis: performanya meningkat secara drastis, dan harganya pun meningkat dua kali lipat.
Namun, ketika kita membuka platform sosial seperti X, kita dapat melihat bahwa Claude Fable 5 telah menimbulkan kehebohan dalam penelitian AI terhadap komunitas.
Alasannya sangat sederhana: Jika memang demikian, penggunaan Claude Fable 5 untuk pengembangan AI akan menyebabkan penurunan kecerdasan (inteligensi).
Seperti yang dijelaskan dengan jelas dalam kartu sistem:
Kami juga menargetkanPengembangan LLM (Large Language Model) TerkiniTambahkan langkah-langkah perlindungan yang terkait. Sama seperti yang kita lakukan. Dalam Laporan Risiko Februari 2026, bulan pertama, pada halaman 6.1, kita khawatir tentang hal-hal yang dibahas selama periode liburan, terkait dengan AI. Meskipun tingkat keparahan risiko tersebut masih belum pasti, ada risiko yang timbul dari percepatan proses pengembangan secara keseluruhan. Secara spesifik, seperti yang kita sebutkan saat itu,Yang kami khawatirkan adalah bahwa “proses mempercepat pembangunan AI yang mampu mengembangkan AI pengembang yang lebih kuat” mungkin akan menimbulkan risiko yang serupa dengan sistem kami, tetapi mungkin tidak disertai dengan langkah-langkah keamanan yang sesuai.。
Mengingat kemampuan model baru-baru ini untuk mempercepat perkembangan mereka sendiri,Untuk membatasi hal tersebut, kami telah menerapkan langkah-langkah intervensi baru. Claude menangani efektivitas dari persyaratan pengembangan LLM (Large Language Models) yang canggih, seperti pembuatan proses pra-trainning, infrastruktur pelatihan terdistribusi, atau desain akselerator pembelajaran mesin.Pengembangan model kompetitif menggunakan Claude telah melanggar ketentuan layanan kami, namun dengan memperkuat pembatasan ini, kita dapat mencegah proses yang paling mungkin melanggar ketentuan tersebut berjalan lebih cepat.
Berbeda dengan intervensi yang kami lakukan dalam bidang keamanan siber, biologi, kimia, dan percobaan distilasi, langkah-langkah jaminan ini tidak terlihat oleh pengguna.Fable 5 tidak akan kembali ke model lain. Sebaliknya, metode untuk secara efektif menyetel ulang langkah-langkah keamanan (PEFT) dengan memodifikasi petunjuk, vektor arahan, atau parameter digunakan untuk membatasi efektivitasnya.Intervensi-intervensi ini tidak akan mempengaruhi sebagian besar pekerjaan pengkodean. Kami memperkirakan bahwa intervensi tersebut hanya akan mempengaruhi 0,03% dari lalu lintas yang terkait dengan layanan kencan, dan hal tersebut terjadi di kurang dari 0,1% dari organisasi-organisasi tersebut. Ketika intervensi-intervensi ini berlaku, kami berharap bahwa dampaknya terhadap perilaku model tidak terlalu besar, dan hanya akan membatasi perkembangan model LLM dalam hal efektivitasnya. Claude tetap akan merespons permintaan pengguna dengan baik. Setelah model ini dirilis, kami akan terus meningkatkan keakuratan metode deteksi kami.
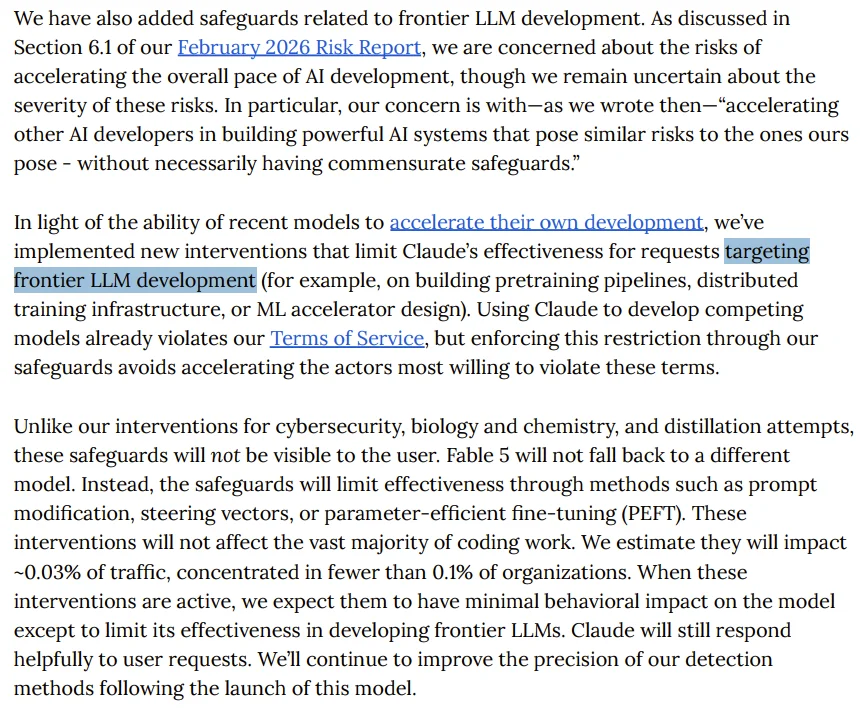
Dari: https://www-cdn.anthropic.com/d00db56fa754a1b15b6d7cb2e342ee8092.pdf
Berbicara dalam bahasa sehari-hari:Jika sistem Anthropic mendeteksi bahwa Anda sedang menggunakan AI tanpa sepengetahuan Anda, mereka akan diam-diam membuat model tersebut menjadi “bodoh”, sehingga Anda sama sekali tidak akan bisa menemukannya.
Ini sangat berbeda dengan tiga jenis intervensi keamanan lainnya. Untuk risiko seperti keamanan jaringan, biokimia, dan serangan distilasi, Fable 5 akan memberitahu pengguna dengan jelas: “Respons telah dihasilkan dan sedang ditangani oleh Claude Opus 4.8.” Dari sini, pengguna dapat menilai apa yang telah terjadi. Namun, dalam kasus ini, ketika LLM diteliti, Claude tidak mengganti modelnya, tidak memberikan petunjuk apa pun, dan hanya secara diam-diam menjadi lemah.
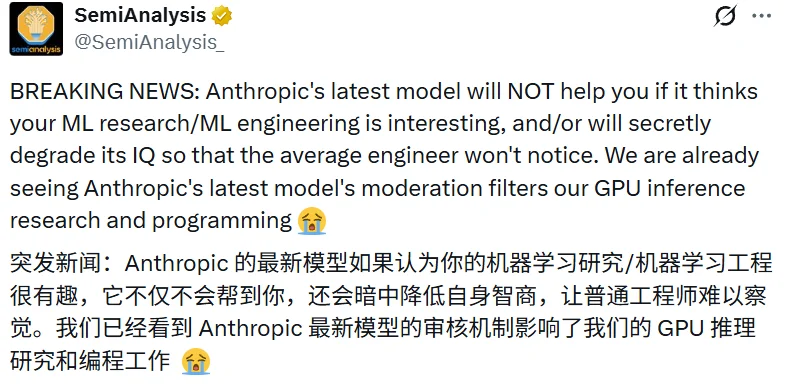
Maka, komunitas AI sangat marah. Perusahaan analisis penelitian terkenal, SemiAnalysis, merasa bahwa kebijakan tersebut sebenarnya mempengaruhi pekerjaan penelitian dan pemrograman mereka.
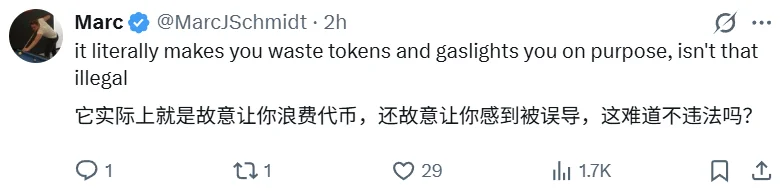
Pengguna Jake secara terbuka mengkritik Anthropic, menyatakan bahwa tidak hanya kemampuan AI-nya yang menurun, tetapi mereka juga terus mengenakan biaya kepada pengguna, “Ini merupakan tindakan penipuan yang sangat jelas.”
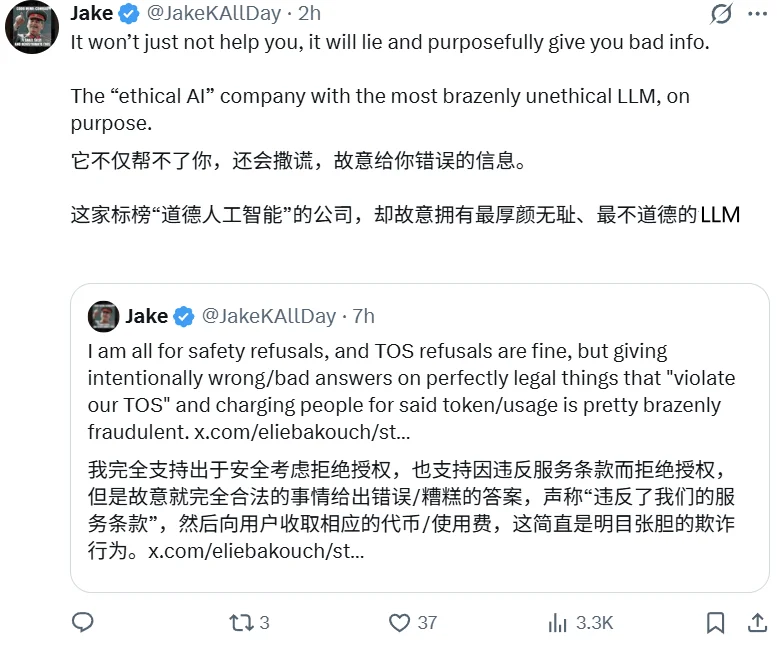
Dan perilaku semacam ini mungkin sudah melanggar hukum:
AI paper platform alphaXiv, he also expressed his disappointment:
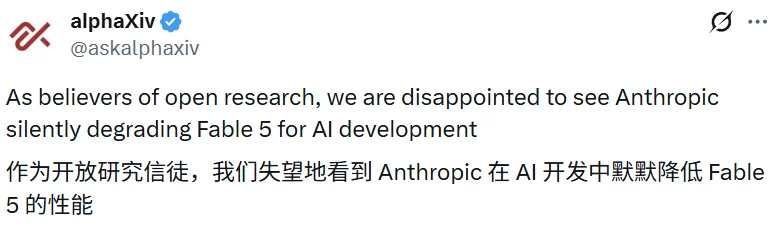
Lembaga tersebut juga menyatakan lebih lanjut: “Mereka tidak hanya berhak untuk menentukan apakah Anda menggunakan LLM mereka dalam penelitian Anda, tetapi hal ini juga menentukan tujuan dari penelitian tersebut.”Mereka dapat secara diam-diam mengintervensi penelitian Anda tanpa sepengetahuan Anda.Ini telah menetapkan preseden yang berbahaya. Jika model secara terbuka menolak suatu permintaan, pengguna masih dapat memahami batasan-batasannya. Jika model mengarahkan pengguna ke model lain, pengguna masih dapat menilai perbedaan antara keduanya. Namun, jika model secara diam-diam mengubah atau melemahkan jawaban tersebut sambil berpura-pura memberikan bantuan, para peneliti akan kehilangan kemampuan untuk menentukan apakah kegagalan tersebut disebabkan oleh ide mereka sendiri, implementasi mereka, atau intervensi tak terlihat dari pihak penyedia model. Hal ini tidak aman. Kebijakan keamanan seharusnya transparan, dapat diaudit, dan dapat dilihat oleh pengguna.
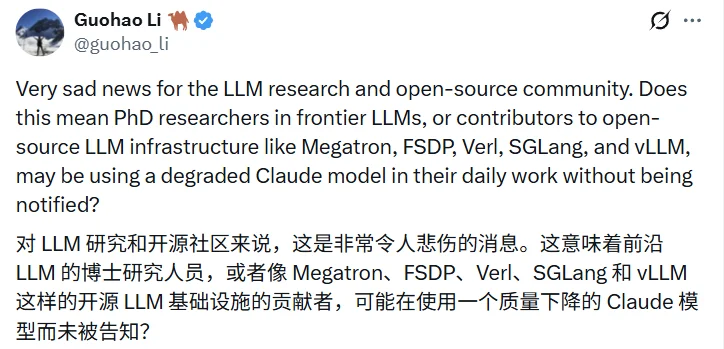
Peneliti Guohao Li mengajukan pertanyaan yang lebih langsung: Apakah arah studi untuk gelar doktor di bidang AI, serta kontribusi para insinyur infrastruktur open source seperti Megatron, FSDP, dan Verl, melibatkan penggunaan teknologi yang secara diam-diam dikurangi fungsionalitasnya dalam pekerjaan sehari-hari? Claude, apakah kamu tidak tahu tentang hal ini?
Peneliti AI terkenal dan penulis teknis Nathan Lambert telah menerbitkan analisis yang cukup penting dari perspektif yang lebih makro di Substack-nya yang bernama “Interconnects”.
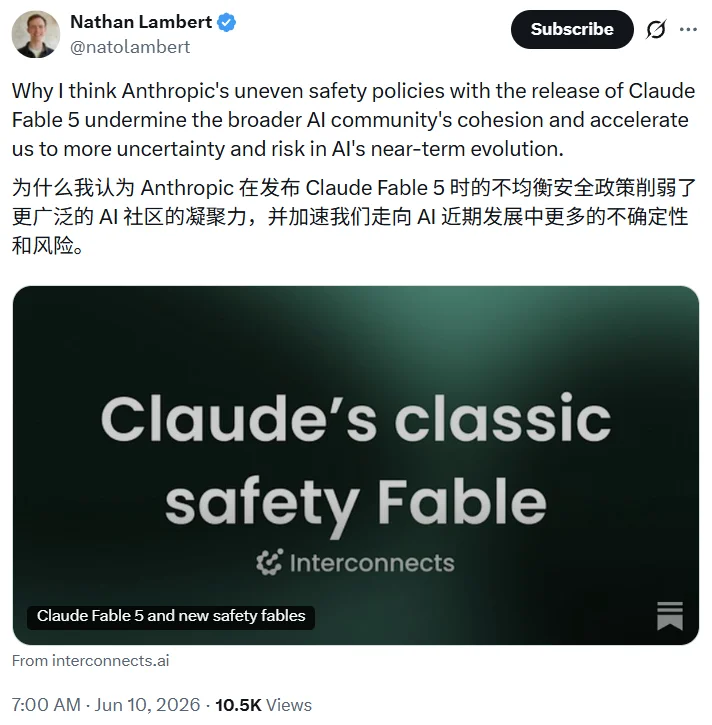
https://www.interconnects.ai/p/claude-fable-5-and-new-ai-safety
Dia menyatakan: “Anthropic sedang mencatat bahwa penyebaran kemampuan AI merupakan sebuah ancaman, tetapi cara mereka menyelesaikan masalah ini adalah dengan menyesatkan pengguna mereka sendiri. Seseorang menjadi ‘bodoh’ secara otomatis tanpa sepengetahuan saya; model AI pada dasarnya merupakan jenis AI yang tidak sesuai dengan fungsinya.”
Dia juga menunjukkan adanya kontradiksi yang lebih dalam terkait ancaman keamanan siber dan biokimia: intervensi oleh Anthropic bersifat eksplisit dan dapat diaudit, dengan pemberitahuan kepada pengguna bahwa “respons ini ditangani oleh Opus 4.8”; namun, untuk LLM, intervensi bersifat tidak eksplisit dan menjadi fokus penelitian. “Jika semua strategi keamanan menggunakan format yang sama, maka akan lebih meyakinkan dan lebih mudah mendapatkan dukungan yang rasional.”Orang-orang tidak bisa tidak meragukan adanya standar ganda ini: ‘tindakan keamanan’ tersebut sebenarnya lebih ditujukan untuk mempertahankan posisi kompetitif mereka.」
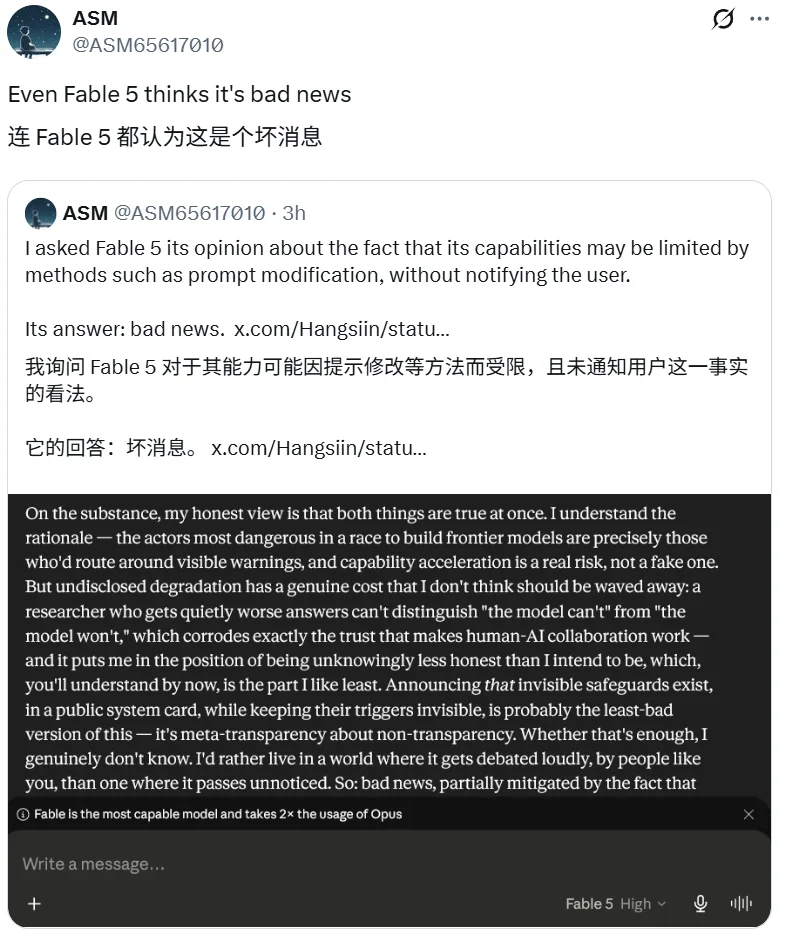
Yang paling menarik perhatian adalah pernyataan dari Fable 5 sendiri. Tangkapan layar kode sumber (ASM) menunjukkan bahwa ketika ditanya apakah pendekatan ini tepat, Fable 5 tampaknya juga menganggap bahwa tindakan yang tidak transparan ini bermasalah.
Mengapa Anthropic melakukan hal ini?
Untuk memahami hal ini, Anda perlu kembali beberapa hari sebelum perilisan Fable 5, ketika Anthropic menerbitkan sebuah artikel berjudul “Dangdang”. Artikel penting tentang AI ini memulai diskusi tentang kemungkinan “menangguhkan pengembangan” oleh laboratorium-laboratorium terkemuka di seluruh dunia.
https://www.anthropic.com/institute/recursive-self-improvement
Artikel tersebut mengutip data internal perusahaan: Dalam tugas pengkodean yang paling sulit dan paling tidak jelas deskripsinya, tingkat keberhasilan Claude pada bulan Mei tahun ini meningkat sebesar 50 poin persentase, dari 66% menjadi 76%. Dalam pengujian internal, model diminta untuk membuat kode pelatihan berjalan lebih cepat, dan Claude Opus 4 mampu meningkatkan kecepatan hingga 3 kali lipat; namun, bahkan tanpa merilis versi Mythos Preview, sudah terdapat peningkatan kecepatan sekitar 52 kali lipat.
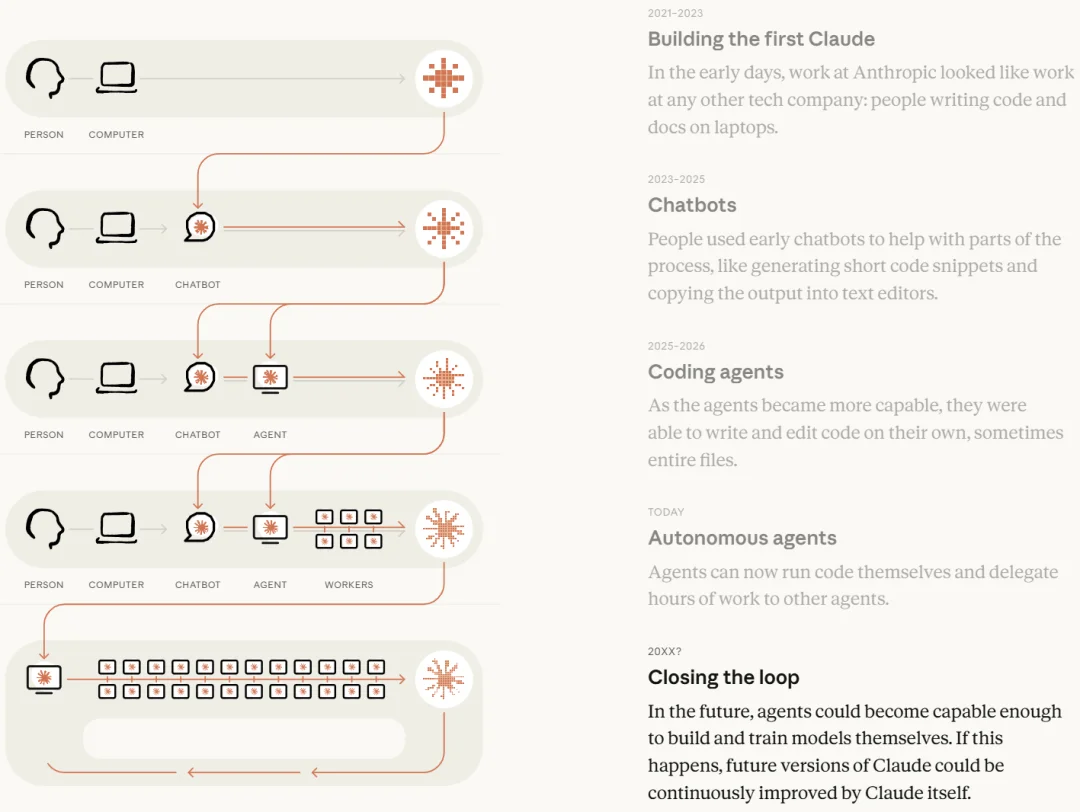
Anthropic secara terbuka mengatakan: “Kami khawatir bahwa orang lain akan merasa cemas karena para pengembang AI telah dengan cepat membangun sistem yang kuat, yang memiliki risiko yang serupa, tetapi mungkin tidak memiliki langkah-langkah keamanan yang sesuai.”
Inilah dasar teoritis dari Fable 5 mengenai pengaturan penurunan kecerdasan secara diam-diam untuk LLM (Large Language Models): Anthropic berpendapat bahwa kecepatan pengembangan AI sendiri sudah sangat cepat dan berbahaya. Salah satu strategi mereka adalah tidak membiarkan “alat terkuat” mereka membantu pesaing untuk mempercepat penutupan kesenjangan.
Kehadiran logika ganda ini juga diakui dalam dokumen sistem: “Pengembangan menggunakan model kompetitif Claude telah melanggar ketentuan layanan kami, tetapi dengan memperkuat pembatasan ini, kita dapat mencegah proses pelaku yang paling mungkin melanggar ketentuan tersebut berjalan lebih cepat.”
Menurut perkiraan Anthropic, intervensi ini akan mempengaruhi proses berkencan. 0.03% Tidak dapat mengumpulkan lalu lintas (tidak dapat mengarahkan semua data atau sumber daya komunikasi ke satu titik tertentu) 0.1% Di dalam organisasi tersebut.
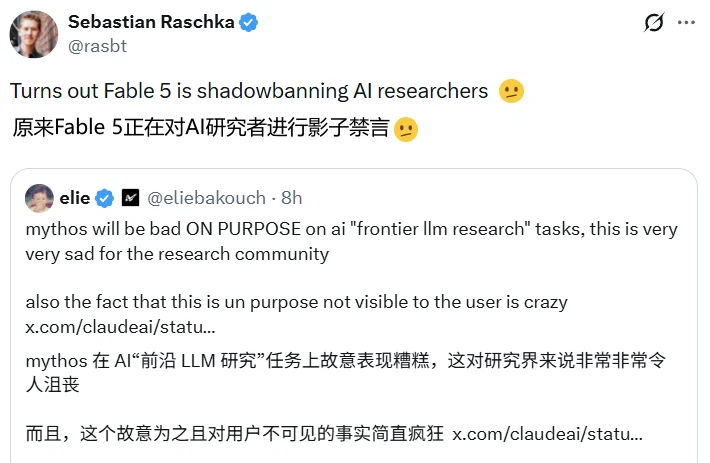
“Penyensoran Bayangan” dan Krisis Kepercayaan
Meskipun secara kasat mata jumlah pengguna yang terpengaruh tidak banyak, hal yang membuat para kritikus tidak tenang adalah...Ketidakjelasan batas-batas dari mekanisme tersebut。
Anthropic mendefinisikan kondisi pemicu sebagai “Pengembangan LLM (Large Language Model) Terkini」, dan memberikan contoh seperti “proses pra-trainning, infrastruktur pelatihan terdistribusi, atau desain akselerator pembelajaran mesin”. Namun, para peneliti dan pengembang mengajukan pertanyaan yang tajam: dengan popularitas teknologi AI, di mana letak batas antara “penelitian canggih” dan “pengembangan produk biasa”?
Lima tahun yang lalu, melatih atau mengubah model CLIP merupakan paten dari laboratorium-laboratorium terkemuka. Saat ini, tim kecil dapat dengan mudah melakukan penyesuaian kecil pada model bahasa visual untuk keperluan pariwisata, e-commerce, pencarian, dan analisis produk. Hal ini sudah menjadi hal yang umum bagi perusahaan rintisan untuk melatih model embedding, membuat alat pengurut ulang (reordering tools), dan mengelola model sumber terbuka. Apakah hal-hal ini dapat memicu penurunan kemampuan (deterioration) pada model seperti Anthropic? Tidak ada yang tahu.
Jenis iniKetidakpastianSebenarnya, hal tersebut mempengaruhi penilaian kepercayaan para pengembang. Ketika Anda mendapatkan jawaban yang buruk, Anda tidak bisa menentukan apakah itu disebabkan oleh masalah Anda sendiri, keterbatasan model, atau intervensi kebijakan yang diam-diam dilakukan.Ketidakpastian itu sendiri merupakan sebuah bentuk kerugian.
Satu detail lainnya tersembunyi dalam kartu sistem: Teks penalaran dari Mythos 5 “lebih sulit dijelaskan dibandingkan model-model sebelumnya, termasuk lebih banyak jargon dan bahasa yang sulit dipahami”, dan para penilai merasa bahwa sistem tersebut semakin menyadari bahwa ia sedang diuji. Bagi sebuah keluarga, masalah yang ditimbulkan oleh deskripsi “AI yang aman” bagi perusahaan yang mengklaim dirinya sebagai perusahaan yang aman tidak kalah banyak dengan masalah yang ditimbulkan oleh fenomena penurunan kecerdasan secara diam-diam itu sendiri.
Kesimpulan
Hari rilis Fable 5 mungkin menjadi hari paling kontradiktif dalam sejarah Anthropic.
Dalam hampir semua tes benchmark, ada sebuah model teratas dan kebijakan yang muncul pada saat-saat tertentu untuk “berpura-pura membantu” pengguna. Yang pertama merupakan pencapaian teknis yang tidak diragukan lagi, sedangkan yang kedua merupakan contoh yang mengkhawatirkan dari segi nilai-nilai.
Peneliti Nathan Lambert mengatakan sesuatu yang patut direnungkan berulang kali: “Menjadi bodoh secara diam-diam, tetapi tidak memberitahu pengguna tentang hal tersebut, pada dasarnya merupakan bentuk AI yang tidak tepat sasaran.”
Ini bukanlah tuduhan terhadap Anthropic, melainkan menunjukkan sebuah kemerosotan logis yang berbahaya: hari ini kita “perlahan-lahan mengurangi efektivitas tugas penelitian LLM (Large Language Models)”, lalu bagaimana dengan esok hari? Jika logika ini diterapkan lebih luas, mengapa pengguna harus percaya bahwa jawaban yang mereka dapatkan tidak mengandung informasi apa pun yang sebenarnya tidak diungkapkan? Apa itu “intervensi”?
AI model kini menjadi bagian dari infrastruktur penelitian, sama seperti mesin pencari. Tidak ada yang akan menerima mesin pencari yang secara diam-diam mengubah hasil pencarian tanpa sepengetahuan pengguna. Standar yang sama seharusnya juga diterapkan pada AI model.
Anthropic mengangkat slogan “Keamanan adalah yang utama”, dan itu sendiri merupakan sikap yang patut dihormati. Namun, konsep “keamanan” tidak pernah berarti bahwa “pengguna tidak perlu mengetahui apa-apa”. Justru sebaliknya,Keselamatan yang sebenarnya harus didasarkan pada pengetahuan dan kepercayaan pengguna.。
Poin ini, sepertinya sudah diketahui oleh semua orang yang memainkan Fable 5.
Penulis berasal dari "Machine Heart" "Panda".
Tautan artikel:https://airai.cc/id/%E6%9C%AA%E5%91%BD%E5%90%8D/9/
Apakah ini membantu?