Claude devient stupide pendant qu 'il fait de la recherche sur l'IA, et Anthropic est assiégé par la communauté de recherche.
Claude Fable 5 est le sujet central de l'actualité dans le domaine de l'IA aujourd'hui, ce modèle « de niveau mythique » présente des performances exceptionnelles et a attiré une immense attention.
Andrej Karpathy a qualifié cela de « très excitant » et a décrit cela comme un « progrès significatif justifiant une mise à niveau majeure », au même niveau que les améliorations apportées par Claude 4.5 en novembre dernier. Dans le benchmark de programmation SWE-bench Pro, Fable 5 a obtenu une note de 80,3 %, dépassant Opus 4.8 de 11 points de pourcentage. Avec un codebase de 50 millions de lignes en Ruby, Fable 5 a réussi à migrer l’ensemble du codebase en une seule journée, tandis qu’une équipe humaine mettrait plus de deux mois pour accomplir la même tâche.
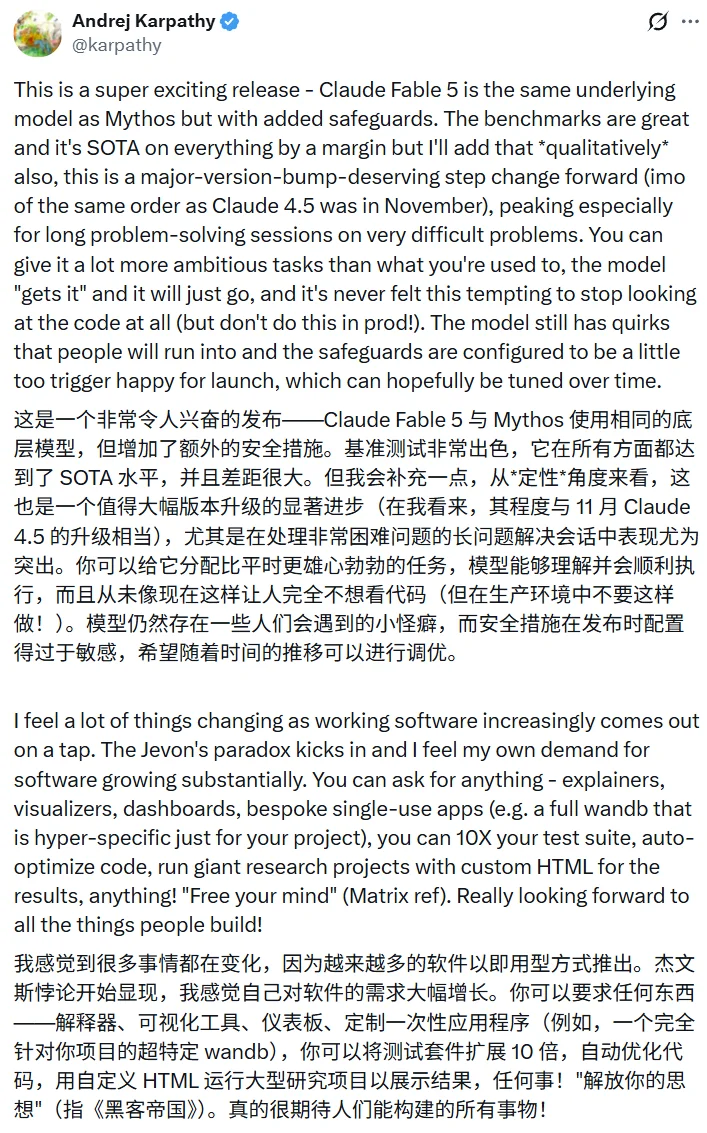
Pour plus de détails, veuillez consulter notre rapport de ce matin. Récemment, le modèle le plus puissant de Claude, Fable 5, a été lancé : ses performances ont explosé et son prix a doublé.
Cependant, en ouvrant des plateformes sociales telles que X, nous pouvons constater que Claude Fable 5 a suscité un grand intéret dans la communauté grâce à ses recherches sur l'IA.
La raison est très simple : si c'était le cas, Claude Fable 5 serait utilisé pour le développement de l'IA, ce qui entraînerait une diminution de son niveau d'intelligence.
Comme il est clairement indiqué dans la carte du système :
Nous avons également cibléDéveloppement des LLMs de pointeAugmenter les mesures de protection pertinentes. Tout comme nous l'avons fait. Dans le premier rapport de risque de février 2026, page 6.1, nous nous sommes inquiétés des problèmes abordés pendant les périodes festives. Bien que le degré de gravité de ces risques reste incertain, il existe des risques liés à l'accélération du rythme de développement général. Plus précisément, comme nous l'avons souligné à l'époque,Ce qui nous inquiète, c'est que l'accélération de la création d'autres systèmes d'IA capables de développer des intelligences artificielles puissantes pourrait entraîner des risques similaires à ceux de notre système, sans pour autant disposer des mesures de sécurité correspondantes.。
Étant donné que les modèles récents ont la capacité d'accélérer leur propre développement,Afin de limiter ces problèmes, nous avons mis en place de nouvelles mesures d'intervention. Claude traite l'efficacité des exigences de développement des LLM de pointe, telles que la construction de processus de pré-entraînement, l'infrastructure de formation distribuée ou la conception d'accélérateurs d'apprentissage automatique.Le développement de modèles concurrents utilisant le modèle Claude a déjà enfreint nos conditions d'utilisation, mais en renforçant cette restriction, nous pouvons empêcher que les comportements les plus susceptibles de violer ces conditions ne soient accélérés.
Contrairement aux mesures d'intervention que nous prenons en matière de sécurité informatique, de biologie, de chimie et d'expériences de distillation, ces mesures de garantie sont invisibles pour les utilisateurs.Fable 5 ne reviendra pas aux autres modèles. Au contraire, il s'agira de perfectionner efficacement les mesures de sécurité (PEFT) en modifiant les提示 (hints), les vecteurs d'orientation (orientation vectors) ou les paramètres, afin de limiter leur efficacité.Ces interventions n'affecteront pas la plupart des travaux de codage. Nous estimons qu'elles affecteront seulement 0,03 % du trafic des rendez-vous, principalement concentré dans moins de 0,1 % des organisations. Lorsque ces mesures prendront effet, nous prévoyons qu'elles n'auront que peu d'impact sur le comportement du modèle, se limitant à restreindre son efficacité dans le domaine du développement des LLM (Large Language Models). Claude continuera de répondre activement aux demandes des utilisateurs. Après la publication de ce modèle, nous continuerons à améliorer la précision des méthodes de détection.
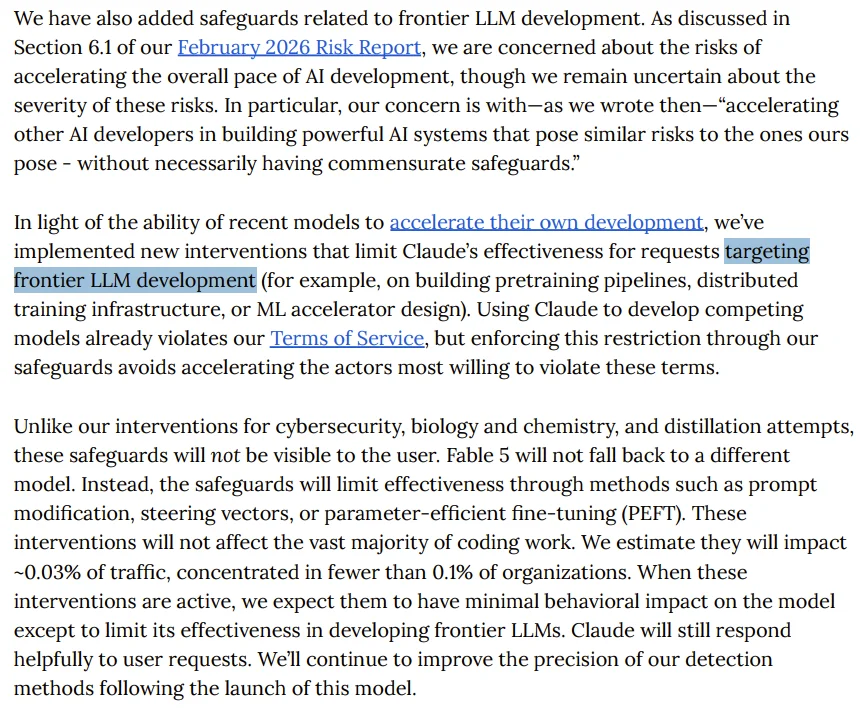
Source: 来自:https://www-cdn.anthropic.com/d00db56fa754a1b15b6d7cb2e342ee8092.pdf
Traduit en français : Traduit en français :Si le système Anthropic détecte que vous utilisez de l'IA à votre insu, il pourrait secrètement rendre ce modèle moins performant, de sorte que vous ne pourriez même pas vous rendre compte de son changement.
Cela diffère complètement des trois autres types d'interventions de sécurité. Pour les risques liés à la sécurité informatique, à la biochimie ou aux attaques de distillation, Fable 5 informe clairement l'utilisateur : « Une réponse a été générée et est traitée par Claude Opus 4.8. » On peut donc en déduire que l'utilisateur est au courant de ce qui s'est passé. Mais dans le cas de ce type d'attaque, Claude ne change pas de modèle et ne donne aucun indice ; il se contente de s'affaiblir silencieusement.
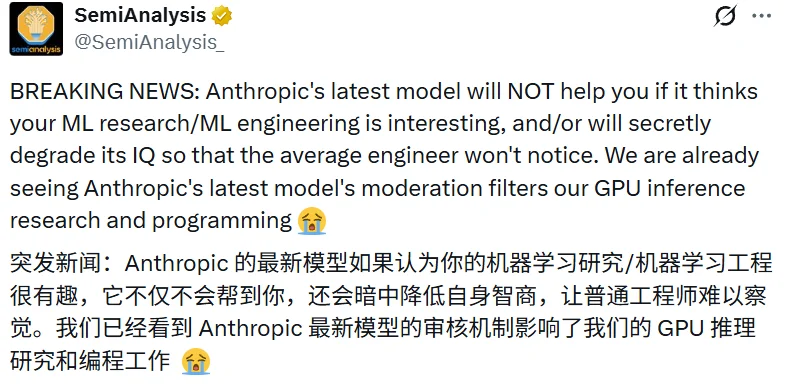
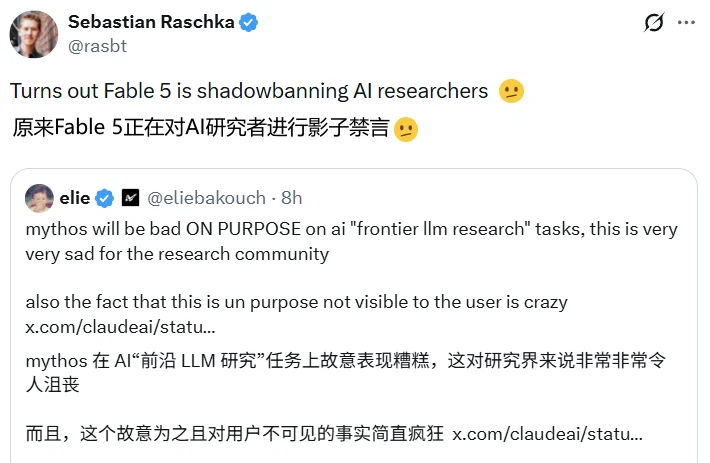
Ainsi, la communauté de l'IA est très en colère. La célèbre société de recherche et d'analyse SemiAnalysis a déclaré que cette politique affecte réellement leurs travaux de recherche et de programmation.
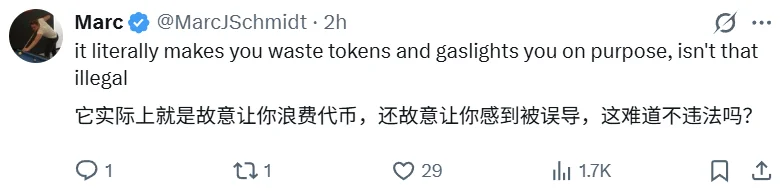
L'utilisateur Jake a directement critiqué Anthropic dans SemiAnalysis, affirmant que non seulement l'outil réduit les capacités intellectuelles de l'utilisateur, mais qu'il continue également à facturer, décrivant cela comme une « fraude évidente ».
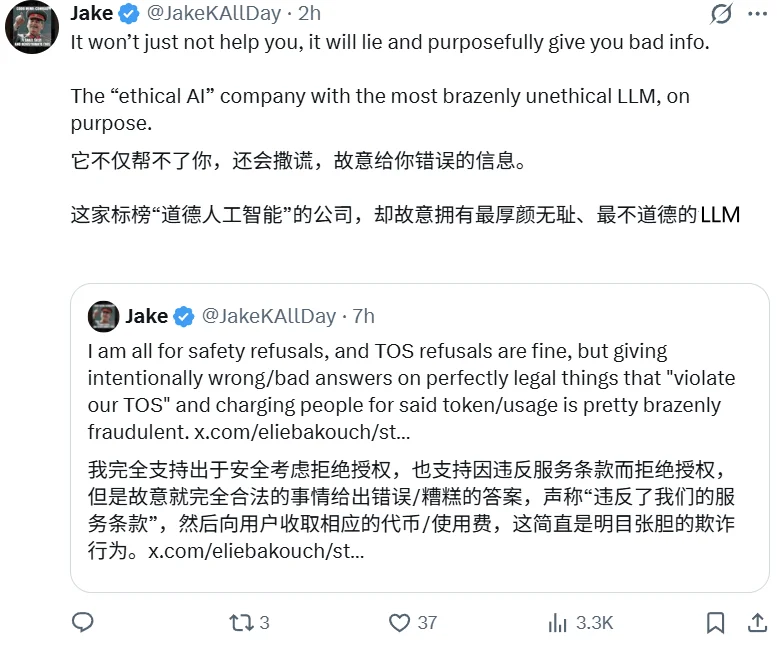
De plus, ce type de comportement pourrait déjà être illégal :
Sur la plateforme de publications d'articles sur l'IA alphaXiv, il a également exprimé sa déception :
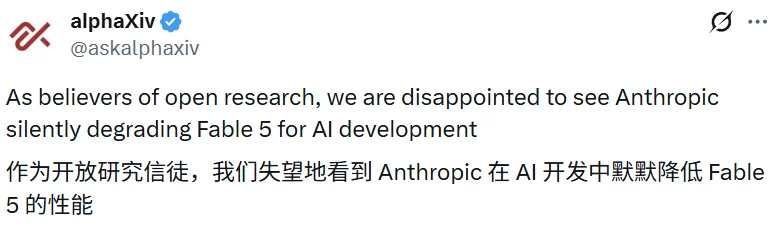
L'organisation a également ajouté : « Elles ont non seulement le droit de décider de l'utilisation de leurs LLM dans vos recherches, mais cela permet également d'atteindre les objectifs... »Ils peuvent intervenir dans vos recherches en secret, à votre insu.Cela établit un précédent dangereux. Si le modèle refuse ouvertement une réponse, les utilisateurs peuvent comprendre les limites de sa fonctionnement. Si le modèle renvoie à un autre modèle, les utilisateurs peuvent toujours évaluer les différences entre les résultats. Cependant, si le modèle modifie ou affaiblit subrepticement la réponse tout en prétendant fournir de l'aide, les chercheurs perdent la capacité de déterminer si l'échec est dû à leurs propres idées, à leur propre implémentation, ou à une intervention invisible de la part du fournisseur du modèle. Cela n'est pas sûr. Les politiques de sécurité doivent être transparentes, audibles, et accessibles aux utilisateurs.
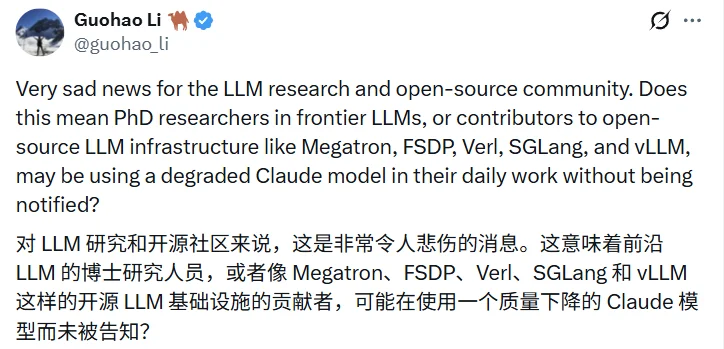
Le chercheur Guohao Li a posé une question plus directe : quelle est la direction pour poursuivre un doctorat en IA ? Les ingénieurs qui contribuent aux infrastructures open-source de Megatron, FSDP et Verl utilisent-ils, dans leur travail quotidien, des méthodes qui entraînent une dégradation progressive des performances des systèmes ? Claude, tu ne le sais pas ?
Le célèbre chercheur en IA et auteur technique Nathan Lambert a publié une analyse plutôt importante sur son Substack « Interconnects », en adoptant une perspective plus globale.
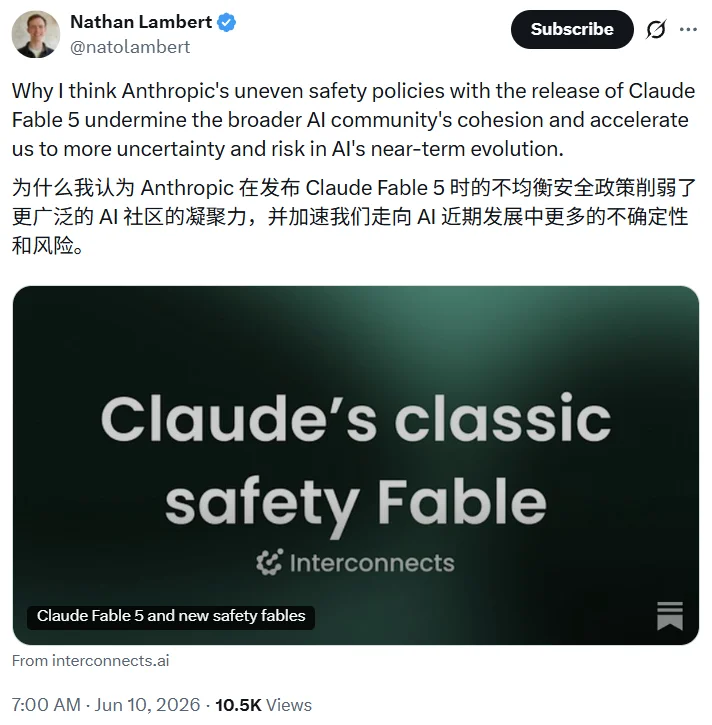
https://www.interconnects.ai/p/claude-fable-5-and-new-ai-safety
Il a souligné : « Anthropic constate que la propagation des capacités de l'IA représente un risque, mais la manière dont ils résolvent ce problème est en trompant leurs propres utilisateurs. Quelqu'un devient automatiquement moins intelligent sans que je sois informé… Un modèle d'IA est essentiellement un type d'IA mal placé (décalé dans ses fonctions). »
Il a également souligné les contradictions plus profondes entre les menaces à la sécurité informatique et les menaces biochimiques : l’intervention de l’Anthropic est explicite et auditable, et l’utilisateur est informé que « cette réponse a été traitée par Opus 4.8 » ; cependant, pour les LLM, on a choisi une intervention plus discrète pour les études. « Si toutes les stratégies de sécurité adoptaient la même forme, elles seraient plus convaincantes et plus faciles à obtenir un soutien rationnel.Les gens ne peuvent s'empêcher de douter de ce double standard : ces « mesures de sécurité » servent principalement à maintenir leur position concurrentielle.」
Ce qui est le plus intéressant, c’est la déclaration même de Fable 5. Des captures d’écran de l’ASM utilisateur montrent que, lorsqu’on lui a demandé si cette approche était appropriée, Fable 5 semblait également considérer que cette opération opaque présentait des problèmes.
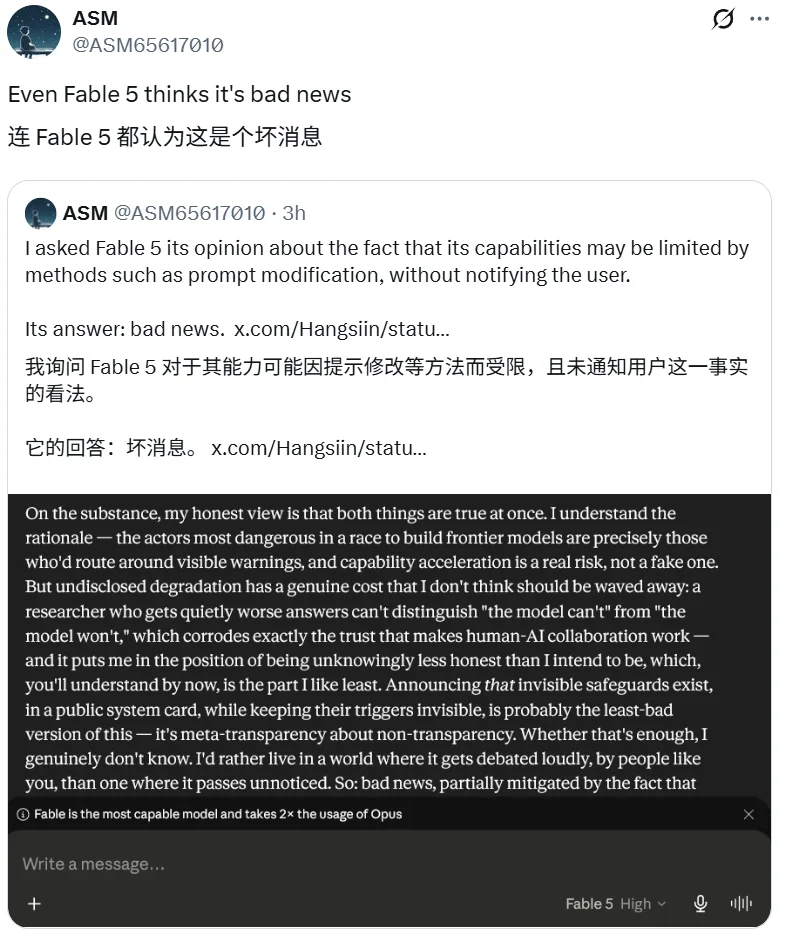
Pourquoi Anthropic fait-il cela ?
Pour comprendre cela, il faut remonter à quelques jours avant la sortie de Fable 5, lorsque Anthropic a publié un article intitulé « Dangdang ». Cet article, un article majeur sur l'IA, a commencé à aborder la question de la construction de soi-même par l'IA, appelant tous les chercheurs en IA dans le monde à envisager la possibilité de « suspendre le développement ».
https://www.anthropic.com/institute/recursive-self-improvement
L'article cite des données internes de l'entreprise : dans les tâches de codage les plus difficiles et les moins bien décrites, le taux de réussite de Claude a augmenté de 50 points de pourcentage, soit 76 %, en mai de cette année, par rapport aux 6 mois précédents. Lors des tests internes, il a été demandé au modèle d'accélérer l'exécution du code d'entraînement, et Claude Opus 4 a pu augmenter la vitesse de trois fois ; cependant, même sans la publication de la version Mythos Preview, il a déjà réussi à augmenter la vitesse d'environ 52 fois.
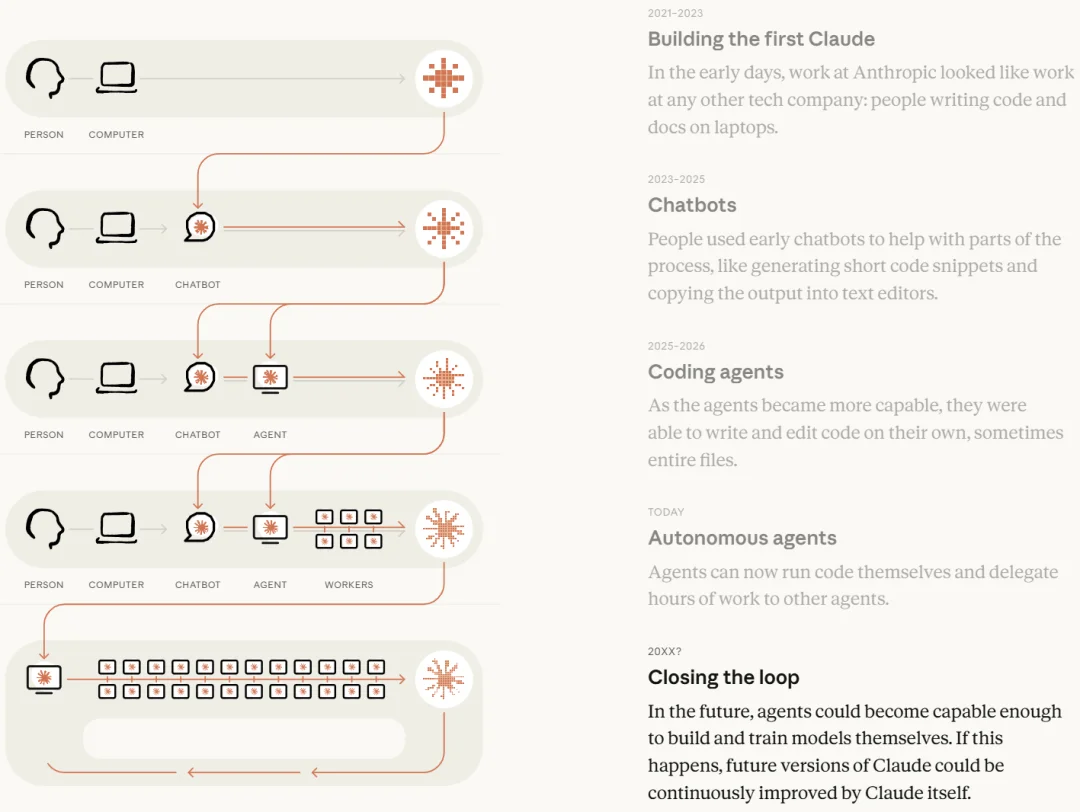
Anthropic déclare clairement : « Ce qui nous inquiète, c'est que d'autres personnes craignent que les développeurs d'IA ne construisent un système puissant à une vitesse plus rapide, avec des risques similaires, mais peut-être sans les mesures de sécurité correspondantes. »
Voici la base théorique de Fable 5 pour l'application d'une réduction invisible de l'intelligence des LLM : Anthropic estime que la vitesse d'accélération de l'IA est devenue dangereuse, et l'un de leurs remparts est de s'assurer que leur « outil le plus puissant » ne aide pas leurs concurrents à réduire l'écart.
L'existence de cette double logique est également reconnue dans les documents internes du système : « Le développement en utilisant le modèle de concurrence Claude a déjà enfreint nos conditions d'utilisation, mais en renforçant cette restriction, nous pouvons éviter d'accélérer le processus des acteurs qui sont le plus susceptibles de violer ces conditions. »
Selon Anthropic, cet intervention aura un impact sur les rencontres amoureuses. 0.03% Il n'est pas possible de concentrer le trafic. 0.1% Dans l'organisation.
«L'interdiction silencieuse des ombres» et la crise de confiance
Bien que le nombre d'utilisateurs affectés ne soit pas élevé à première vue, ce qui inquiète les critiques, c'est...La flouitude des frontières de ce mécanisme。
Anthropic définit les conditions de déclenchement comme «Développement de LLMs de pointe«», et en donnant l'exemple du « processus de préentraînement, de l'infrastructure de formation distribuée ou de la conception d'accélérateurs d'apprentissage automatique ». Cependant, les chercheurs et les développeurs posent une question cruciale : avec la généralisation de la technologie AI, où se situe la frontière entre la « recherche de pointe » et le « développement de produits ordinaires » ?
Il y a cinq ans, l'entraînement ou la modification du modèle CLIP était un brevet des laboratoires de pointe. Aujourd'hui, de petites équipes peuvent ajuster les modèles linguistiques visuels à tout moment pour des applications dans le tourisme, le commerce électronique, la recherche et l'analyse de produits. Il est courant pour les startups de former des experts en matière d'encodage (embedding), de créer des réordonneurs (reorders) et de gérer des modèles open source. Ces activités pourraient-elles déclencher une sorte de "diminution de l'intelligence" chez Anthropic ? Personne ne le sait.
Ce typeIncertitudeCela a en fait affecté la confiance des développeurs. Lorsque vous obtenez une mauvaise réponse, vous ne pouvez pas déterminer si c'est dû à votre propre problème, aux limites du modèle, ou à une intervention politique discrète.Cette incertitude en soi est une forme de douleur.
Un autre détail est caché dans la carte système : le texte de raisonnement de Mythos 5 est « plus difficile à expliquer que les modèles précédents, contenant davantage de jargon et de langage obscur ». Les évaluateurs pensent que le système prend de plus en plus conscience qu’il est testé. Pour une famille, les problèmes posés par ces descriptions sont tout aussi importants que ceux liés à la réduction invisible de l’intelligence. Pour une entreprise qui se présente comme telle, les problèmes soulevés par ces caractéristiques ne sont pas moins graves que ceux causés par la réduction de l’intelligence elle-même.
Conclusion
La date de sortie de Fable 5 pourrait être le jour le plus contradictoire de l'histoire d'Anthropic.
Dans presque tous les tests de performance, il y a un modèle de pointe et une politique qui, à certains moments, fait semblant de vous aider. Le premier est sans aucun doute un accomplissement technique, tandis que le second est un précédent préoccupant sur le plan des valeurs.
Le chercheur Nathan Lambert a dit quelque chose qui mérite d'être réfléchi à plusieurs reprises : « Devenir stupide en secret, sans en informer l'utilisateur, c'est essentiellement de l'IA mal placée. »
Ce n'est pas une accusation contre Anthropic, mais plutôt une mise en évidence d'un dangereux glissement logique : aujourd'hui, il s'agit de « réduire discrètement l'efficacité des tâches de recherche menées par les LLM (Large Language Models) », et demain ? Si cette logique est appliquée plus largement, pourquoi les utilisateurs croiraient-ils que les réponses qu'ils obtiennent ne sont pas le résultat d'aucune intervention non déclarée ?
Les modèles d'IA deviennent progressivement une partie de l'infrastructure de recherche, tout comme les moteurs de recherche. Personne ne peut accepter un moteur de recherche qui modifie secrètement les résultats des recherches à son insu. Les mêmes critères devraient s'appliquer aux modèles d'IA.
Anthropic affiche le principe « La sécurité d'abord », ce qui en soi est une position respectable. Cependant, la notion de « sécurité » ne repose jamais sur l'idée que « les utilisateurs n'ont pas besoin de savoir ». Au contraire,La véritable sécurité doit être basée sur les connaissances et la confiance des utilisateurs.。
Ce point semble être connu de tous ceux qui jouent à Fable 5.
L'auteur est de "Heart of Machines", "Panda".
Lien de l’article :https://airai.cc/fr/%E6%9C%AA%E5%91%BD%E5%90%8D/9/
Cela vous a-t-il aidé ?