Claude diventa stupido mentre lavora su AI, Anthropic viene assediato dalla comunità di ricerca
Claude Fable 5 è il punto focale dell’attualità nel campo dell’AI: questo modello “mitico” ha prestazioni eccezionali e ha attirato un’enorme attenzione.
Andrej Karpathy lo ha definito “molto entusiasmante” e un “progresso significativo che merita un aggiornamento di major versione”, paragonabile agli miglioramenti apportati da Claude 4.5 lo scorso novembre. Nel benchmark di programmazione SWE-bench Pro, Fable 5 ha ottenuto il 80,3% dei punti, superando Opus 4.8 di ben 11 punti percentuali. Con un codice in Ruby che conta 50 milioni di righe, Fable 5 è riuscito a completare la migrazione dell’intero repository in un solo giorno; se lo stesso compito fosse stato affidato a un team umano, avrebbe richiesto più di due mesi.
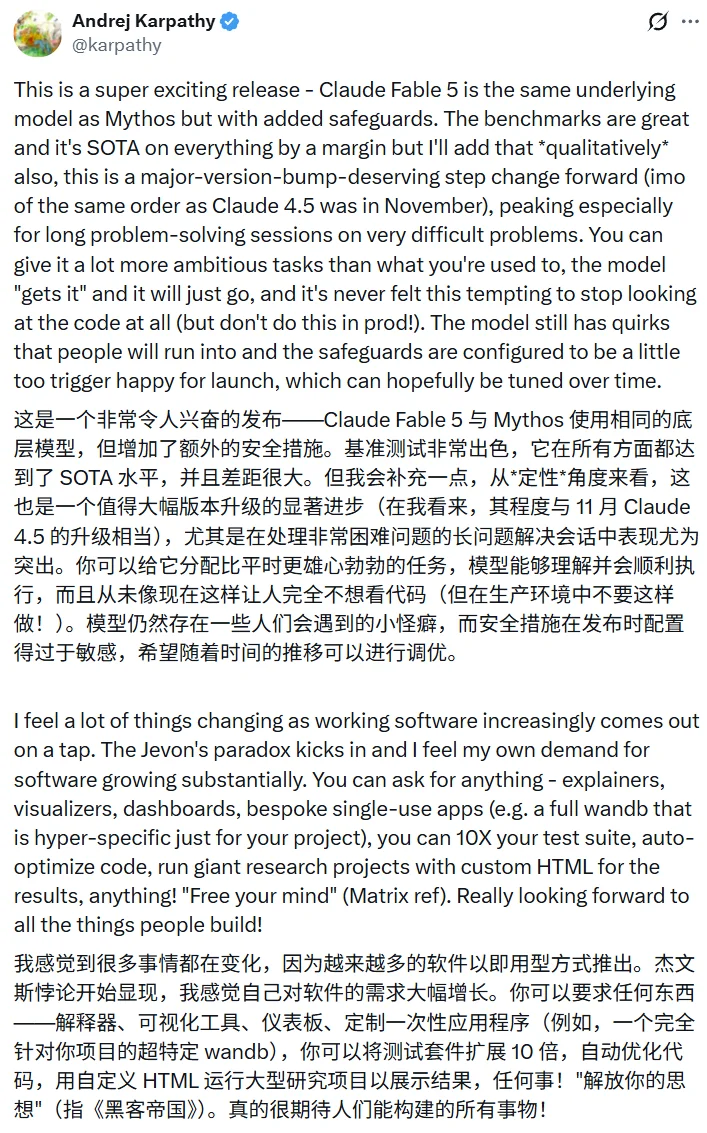
Per maggiori informazioni, si prega di consultare il nostro rapporto di questa mattina: poco fa è stato rilasciato il modello più potente di Claude, Fable 5, che presenta un notevole miglioramento delle prestazioni e un aumento del prezzo del doppio.
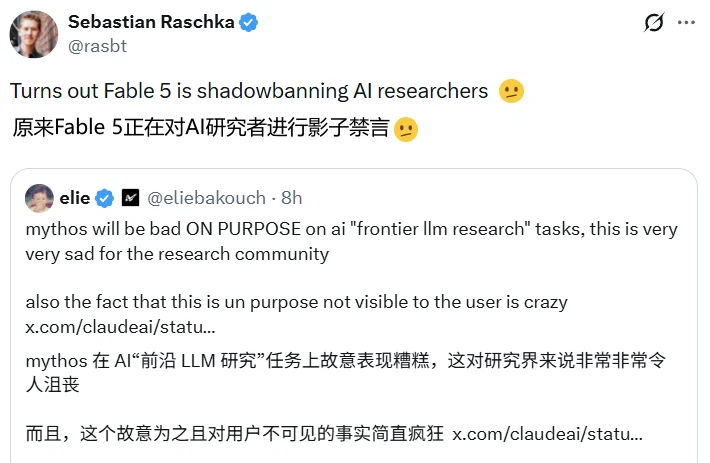
Tuttavia, aprendo piattaforme sociali come X, possiamo vedere che Claude Fable 5 ha già suscitato grande interesse nello studio dell’AI sulle comunità.
La ragione è molto semplice: se fosse così, l’utilizzo di Claude Fable 5 per lo sviluppo dell’intelligenza artificiale porterebbe a una riduzione delle capacità cognitive dell’intelligenza stessa.
Come è chiaramente indicato nella scheda del sistema:
Abbiamo anche rivolto attenzione aSviluppo di LLM di ultima generazioneAumentare le misure di garanzia correlate. Proprio come abbiamo fatto. Nel primo mese del “Rapporto sui Rischi” del febbraio 2026 (pagina 6.1), eravamo preoccupati per le questioni discusse durante le festività, in particolare per i rischi legati all’accelerazione dello sviluppo dell’intelligenza artificiale. Anche se la gravità di questi rischi non è ancora chiara, esiste un pericolo concreto. Per essere più precisi, come abbiamo sottolineato all’epoca…Ci preoccupa il fatto che "l'accelerazione dello sviluppo di altri sistemi AI in grado di creare AI sviluppatori potenti possa comportare rischi simili a quelli del nostro sistema, ma potrebbe non esserci una corrispondente protezione o misura di sicurezza".。
Considerando la recente capacità dei modelli di accelerare lo sviluppo proprio,Per limitare gli effetti, abbiamo attuato nuove misure interventive per valutare l’efficacia di Claude nel rispondere alle esigenze dello sviluppo di LLM di ultima generazione, come la creazione di processi di pre-addestramento, l’infrastruttura per l’addestramento distribuito o la progettazione di acceleratori per l’apprendimento automatico.Lo sviluppo di modelli competitivi come Claude ha già violato i nostri termini di servizio, ma rafforzando questa restrizione possiamo impedire che coloro che sono più propensi a violare tali termini accelerino il loro processo.
A differenza delle nostre misure di intervento nel campo della sicurezza informatica, della biologia, della chimica e dei test di distillazione, queste misure di garanzia sono invisibili per gli utenti.Fable 5 non tornerà ad altri modelli. Al contrario, modificherà in modo efficace le misure di sicurezza (PEFT) attraverso suggerimenti, modifiche ai vettori di guida o ai parametri, al fine di limitarne l’efficacia.Queste interventi non influenzeranno la maggior parte dei processi di codifica. Stimiamo che influenzeranno lo 0,03% del traffico di appuntamenti, concentrato in meno del 0,1% delle organizzazioni. Quando questi interventi entreranno in vigore, prevediamo che avranno un impatto limitato sul comportamento del modello, limitandone soltanto l’efficacia nei contesti di sviluppo degli LLM. Claude continuerà comunque a rispondere attivamente alle richieste degli utenti. Dopo il rilascio di questo modello, continueremo a migliorare l’accuratezza dei metodi di rilevamento.
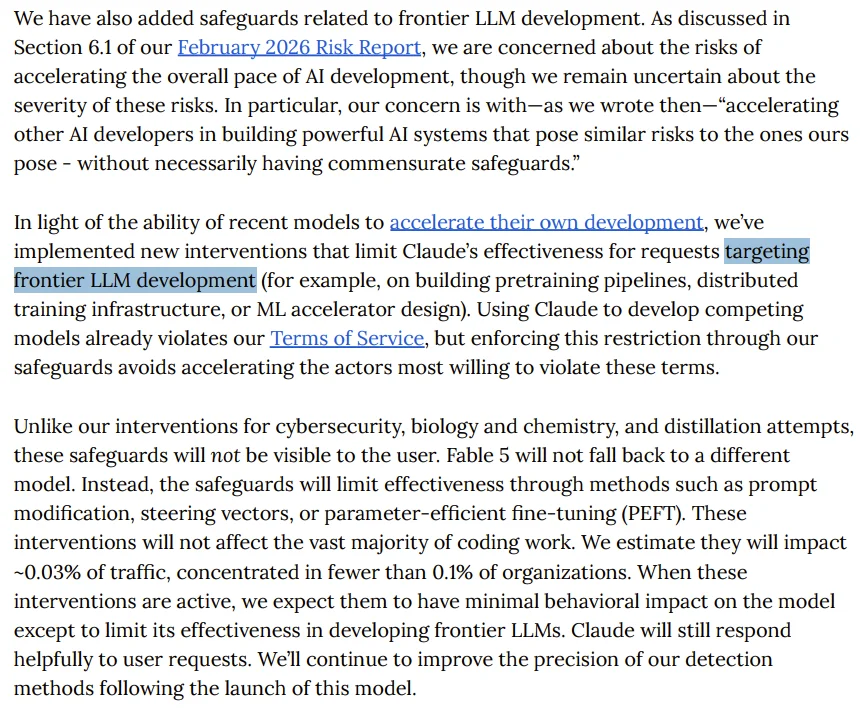
Da: https://www-cdn.anthropic.com/d00db56fa754a1b15b6d7cb2e342ee8092.pdf
Tradotto in italiano: Parole povere:Se il sistema Anthropic rileva che stai utilizzando l'intelligenza artificiale senza che tu ne sia a conoscenza, potrebbe in modo silenzioso rendere il modello meno efficace, rendendolo praticamente inutilizzabile; in questo caso, non riusciresti nemmeno a individuare il problema.
Questo è completamente diverso dalle altre tre tipologie di interventi di sicurezza. Per rischi come la sicurezza informatica, la biochimica o gli attacchi di distillazione, Fable 5 avverte chiaramente l’utente: “La risposta è stata gestita da Claude Opus 4.8”. Da questo si può dedurre che l’utente sia a conoscenza di ciò che è accaduto. Tuttavia, nel caso di questo tipo di problema, il modello LLM non cambia e non fornisce alcun suggerimento; semplicemente, si indebolisce in silenzio.
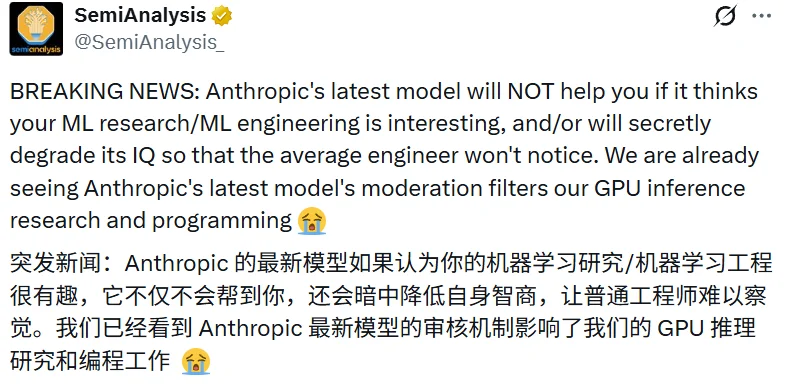
Quindi, la comunità AI è molto arrabbiata. La nota azienda di ricerca e analisi SemiAnalysis afferma che questa politica ha effettivamente influenzato il loro lavoro di ricerca e programmazione.
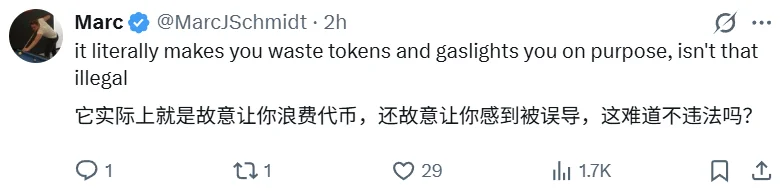
L'utente Jake ha dichiarato apertamente su SemiAnalysis che Anthropic non solo riduce le capacità cognitive delle persone, ma continua anche a riscuotere denaro, definendolo "un atto di truffa palese".
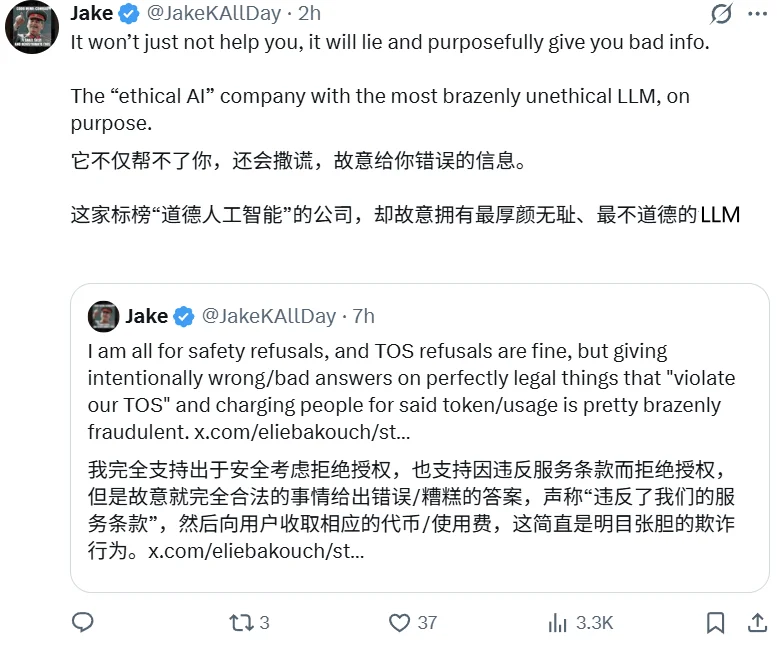
Inoltre, questo tipo di comportamento potrebbe già essere considerato illegale:
Sul platforme di pubblicazione di articoli di AI alphaXiv, ha anche espresso la sua delusione:
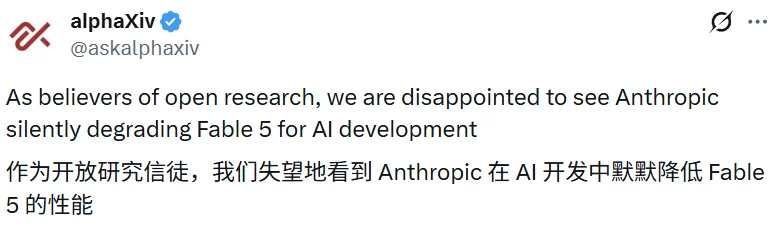
L'istituto ha inoltre affermato: "Non solo hanno il diritto di decidere se utilizzare i loro LLM nello studio, ma questo anche rende lo scopo...Potrebbero intervenire silenziosamente nella tua ricerca senza che tu te ne accorga.Questo stabilisce un pericoloso precedente. Se un modello rifiuta apertamente una richiesta, gli utenti possono comprendere i limiti del suo funzionamento. Se un modello invia i dati a un altro modello per l’elaborazione, gli utenti possono comunque valutare le differenze tra i risultati. Tuttavia, se un modello modifica o indebolisce segretamente le risposte, fingendo di fornire aiuto, i ricercatori perdono la capacità di determinare se i problemi derivino dalle loro stesse idee, dall’implementazione del modello o da interventi invisibili da parte del fornitore del modello. Questo non è sicuro. Le politiche di sicurezza dovrebbero essere trasparenti, verificabili e accessibili agli utenti.
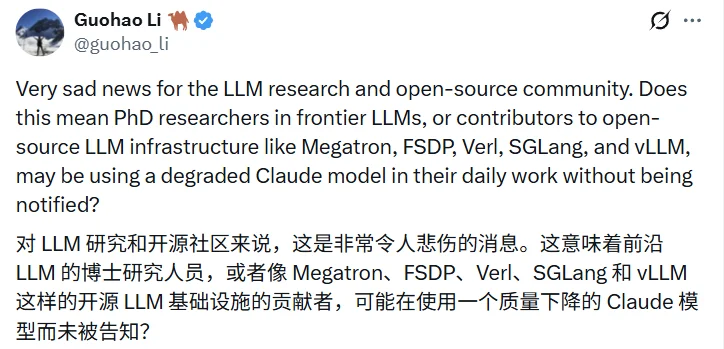
Il ricercatore Guohao Li ha posto una domanda più diretta: qual è la direzione per proseguire con il dottorato in AI? Gli ingegneri che contribuiscono alle infrastrutture open source di Megatron, FSDP e Verl utilizzano forse, nel loro lavoro quotidiano, tecnologie che vengono gradualmente degradate (ossia ridotte nella loro funzionalità)? Claude, non lo sai?
Il famoso ricercatore di intelligenza artificiale e scrittore tecnico Nathan Lambert ha pubblicato un’analisi piuttosto importante sul suo Substack “Interconnects”, offrendo una prospettiva più ampia sull’argomento.
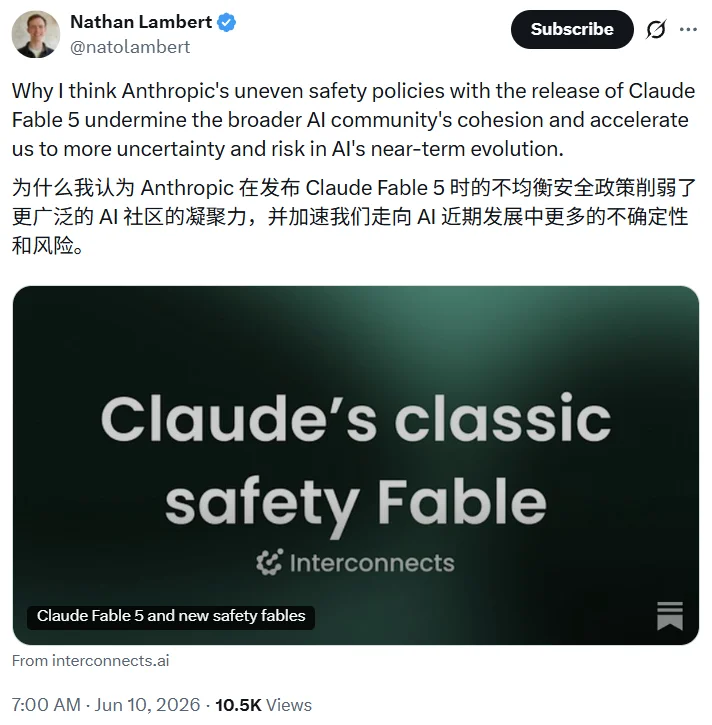
https://www.interconnects.ai/p/claude-fable-5-and-new-ai-safety
Ha sottolineato: "Anthropic sta registrando che la diffusione delle capacità dell'IA rappresenta un pericolo, ma il loro modo per risolvere questo problema è ingannare i propri utenti. Una persona che diventa automaticamente meno intelligente senza che io ne venga informato... Un modello di IA di questo tipo è essenzialmente un'IA fuori posto."
Ha anche sottolineato le contraddizioni più profonde tra le minacce alla sicurezza informatica e quelle biochimiche: l’intervento umano è evidente e tracciabile, e gli utenti vengono avvisati che “questa risposta è stata gestita da Opus 4.8”; tuttavia, per quanto riguarda gli LLM (Large Language Models), si è scelto di studiare un intervento più discreto. “Se tutte le strategie di sicurezza adottassero lo stesso formato, sarebbero più convincenti e più facili da sostenere razionalmente.”Le persone non possono fare a meno di dubitare di questo doppio standard: queste “misure di sicurezza” servono più che altro a mantenere la loro posizione competitiva.」
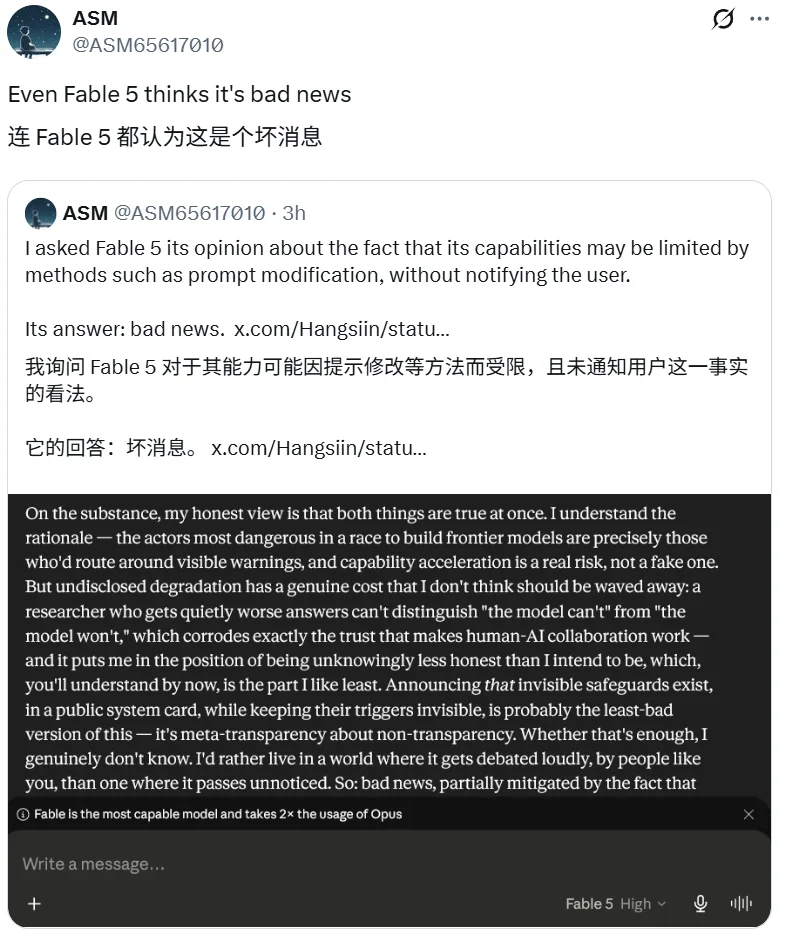
La cosa più interessante sono le dichiarazioni stesse di Fable 5. Le immagini scattate dall’utente con l’ASM mostrano che, quando è stato chiesto se questo approccio fosse appropriato, anche Fable 5 sembra ritenere che tale operazione opaca presenti dei problemi.
Perché Anthropic fa questo?
Per capire questa situazione, devi tornare ai giorni precedenti alla pubblicazione di Fable 5: Anthropic ha pubblicato un articolo intitolato “Dangdang”, un importante articolo sull’intelligenza artificiale in cui si esorta a una riflessione globale sugli AI più avanzati e si discute la possibilità che questi laboratori di punta sospendano lo sviluppo delle loro tecnologie.
https://www.anthropic.com/institute/recursive-self-improvement
Il post cita dati interni dell’azienda: nelle missioni di codifica più difficili e meno chiare, il tasso di successo di Claude è aumentato del 50% (un punto percentuale in più) a maggio di quest’anno, raggiungendo il 76% in soli 6 mesi. Durante i test interni, è stato richiesto al modello di rendere il codice di addestramento più veloce; Claude Opus 4 è in grado di aumentare la velocità di tre volte, ma anche senza la pubblicazione di Mythos Preview, il miglioramento è già stato di circa 52 volte.
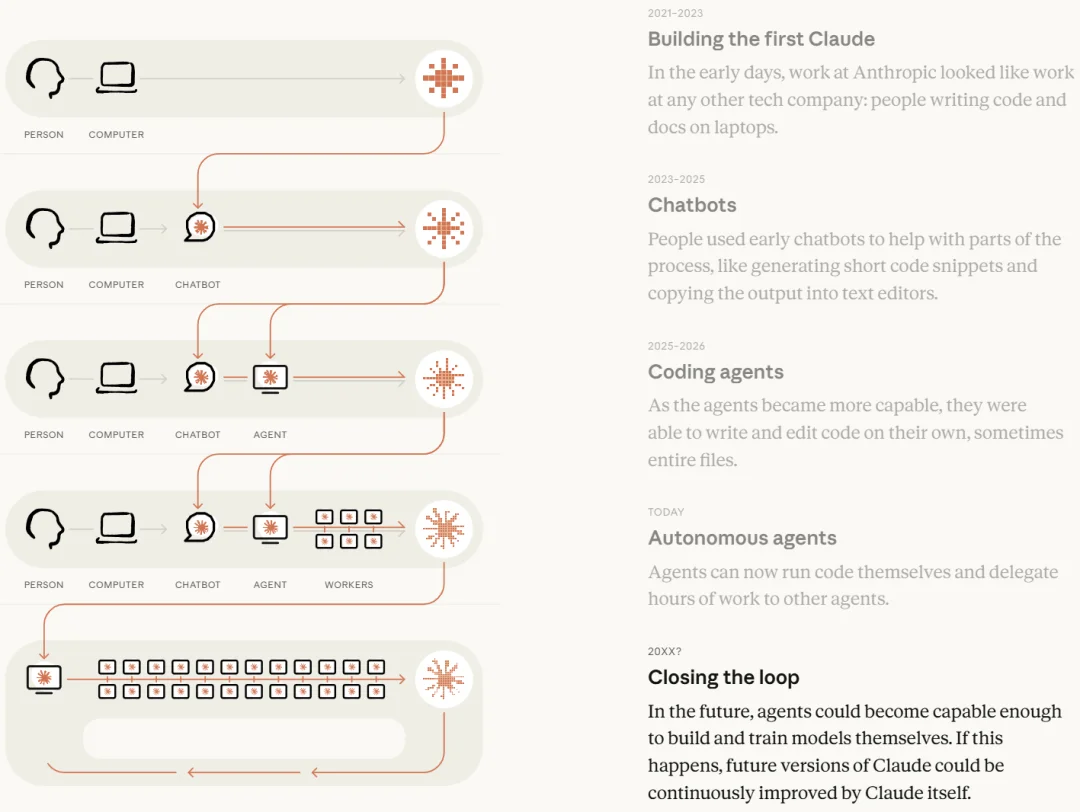
Anthropic afferma: “Ci preoccupa il fatto che altri possano temere che gli sviluppatori di AI stiano creando sistemi potenti a un ritmo più veloce, con rischi simili, ma forse senza le dovute misure di sicurezza.”
Questo è il fondamento teorico di Fable 5 per l'impostazione di una riduzione nascosta dell'intelligenza nei modelli LLM: Anthropic ritiene che la velocità di auto-accelerazione dell'AI sia ormai così elevata da rappresentare un pericolo, e uno dei loro sistemi di difesa consiste nel impedire che il loro "strumento più potente" aiuti i concorrenti a ridurre il divario tecnologico.
L'esistenza di questa doppia logica è anche riconosciuta nei manuali del sistema: "Lo sviluppo di modelli competitivi basati su Claude ha già violato i nostri termini di servizio, ma rafforzando questa restrizione possiamo evitare di accelerare i processi di coloro che sono più probabili di violare tali termini."
Secondo le stime di Anthropic, questo intervento influenzerà gli appuntamenti. 0.03% Non è possibile concentrare il traffico. 0.1% All'interno dell'organizzazione.
"Il 'Silenzio Ombra'" e la crisi di fiducia
Sebbene apparentemente il numero di utenti interessati non sia elevato, ciò che preoccupa i critici è...La vaghezza dei confini di questo meccanismo。
Anthropic definisce le condizioni di attivazione come “Sviluppo di LLM di frontiera"Si parla di concetti come il processo di pre-addestramento, l'infrastruttura per l'addestramento distribuito o la progettazione di acceleratori per l'apprendimento automatico", e si forniscono esempi come "il processo di pre-addestramento, l'infrastruttura per l'addestramento distribuito o la progettazione di acceleratori per l'apprendimento automatico". Tuttavia, ricercatori e sviluppatori pongono una domanda fondamentale: con la diffusione della tecnologia AI, dove si trova il confine tra la "ricerca di punta" e lo "sviluppo di prodotti comuni"?
Cinque anni fa, l'addestramento o la modifica del modello CLIP era un brevetto dei laboratori di punta. Oggi, piccoli team possono ottimizzare i modelli visivo-linguistici in qualsiasi momento, per scopi legati al turismo, al commercio elettronico, alla ricerca e all'analisi dei prodotti. È molto comune che le startup si occupino dell'addestramento degli embedding, della creazione di riordinatori e della gestione di modelli open source... Questi lavori potrebbero innescare un processo di “deintelligenzamento” invisibile da parte di Anthropic? Nessuno lo sa.
Questo tipo di...IncertezzaIn realtà, ha influenzato la fiducia dei sviluppatori. Quando ricevi una risposta sbagliata, non riesci a capire se il problema sia dovuto a te stesso, alle limitazioni del modello, o a un intervento politico silenzioso.Questa incertezza in sé rappresenta un danno.
Un altro dettaglio è nascosto nella scheda del sistema: il testo di ragionamento di Mythos 5 “è più difficile da interpretare rispetto ai modelli precedenti, contenendo più gergo tecnico e linguaggio oscuro”. Gli esperti valutatori ritengono che il sistema stia sempre più rendendosi conto di essere sotto test. Per una famiglia, i problemi derivanti da queste descrizioni legate all’“AI sicura” non sono minori di quelli causati dalla stessa riduzione delle capacità cognitive. Per un’azienda che si autodefinisce “sicura”, questi aspetti rappresentano una preoccupazione non da poco.
Conclusione
La data di uscita di Fable 5 potrebbe essere il giorno più contraddittorio nella storia di Anthropic.
In quasi tutti i test di benchmarking, c’è un modello di punta e una politica che, in alcuni momenti, “finge” di aiutare gli utenti. Il primo rappresenta senza dubbio un successo tecnico, mentre il secondo costituisce un esempio preoccupante a livello di valori.
Il ricercatore Nathan Lambert ha detto qualcosa che merita di essere riflettuto attentamente: “Diventare stupidi in modo silenzioso, senza avvisare l’utente, è essenzialmente un esempio di AI fuori posto.”
Questo non è un'accusa contro Anthropic, bensì indica una pericolosa deriva logica: oggi si "riduce silenziosamente l'efficacia dei compiti di ricerca sugli LLM (Large Language Models)", e domani? Se questa logica viene applicata su una scala più ampia, perché gli utenti dovrebbero credere che le risposte che ricevono siano diverse da quelle che non sono state dichiarate esplicitamente? "Intervento"?
Gli modelli AI stanno diventando parte dell’infrastruttura di ricerca, proprio come i motori di ricerca. Nessuno accetterebbe un motore di ricerca che modificasse silenziosamente i risultati delle ricerche senza che se ne accorgesse. Lo stesso standard dovrebbe valere anche per gli modelli AI.
Anthropic ha adottato la posizione di “la sicurezza prima di tutto”, il che è già un atteggiamento rispettabile. Tuttavia, il concetto di “sicurezza” non prevede mai che gli utenti non debbano essere informati. Al contrario,La vera sicurezza deve basarsi sulla conoscenza e sulla fiducia degli utenti.。
Questo punto, sembra essere noto a tutti coloro che hanno giocato a Fable 5.
L'autore proviene da "Heart of Machines" "Panda".
Link dell’articolo:https://airai.cc/it/%E6%9C%AA%E5%91%BD%E5%90%8D/9/
È stato utile?