OpenAI科學家Noam Brown:AI的真正上限,可能根本沒人測得起
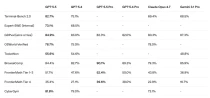
隨著大語言模型逐漸進入複雜的推理、自動化研究和網絡安全等困難任務,傳統的模型評價方法正面臨著新的挑戰。長期以來,模型發佈往往伴隨著由數學、編程、科學問答、網絡安全、知識推理等多種基準測試組成的結果表,並與上一代模型進行水平比較。...
隨著大語言模型逐漸進入複雜的推理、自動化研究和網絡安全等困難任務,傳統的模型評價方法正面臨著新的挑戰。長期以來,模型發佈往往伴隨著由數學、編程、科學問答、網絡安全、知識推理等多種基準測試組成的結果表,並與上一代模型進行水平比較。...
沒有更多了