Ноам Браун, ученый OpenAI: истинный предел ИИ, который никто не может себе позволить измерить
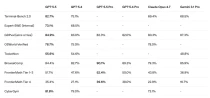
По мере того как большие языковые модели все чаще применяются для решения сложных задач, таких как сложные рассуждения, автоматизированные исследования и обеспечение кибербезопасности, традиционные методы оценки моделей сталкиваются с новыми вызовами.На протяжении долгого времени публикация моделей сопровождалась предоставлением таблиц результатов, включающих различные бенчмарки для проверки их производительности в таких областях, как математика, программирование, научные вопросы, кибербезопасность и рассуждение на основе знаний, а также сравнением этих результатов с производительностью предыдущих поколений моделей.