Noam Brown, scienziato di OpenAI: il vero limite dell 'IA, nessuno può permettersi di misurare
Con l'avanzamento dei grandi modelli linguistici nell'esecuzione di compiti complessi come il ragionamento, la ricerca automatizzata e la sicurezza informatica, i metodi tradizionali di valutazione dei modelli si trovano ad affrontare nuove sfide.
Da tempo, il rilascio di un modello è accompagnato da una tabella di risultati che include vari test di benchmark, che spaziano dalla matematica, alla programmazione, alle domande scientifiche, alla sicurezza informatica e al ragionamento conoscitivo, e questi risultati vengono confrontati con quelli del modello precedente.
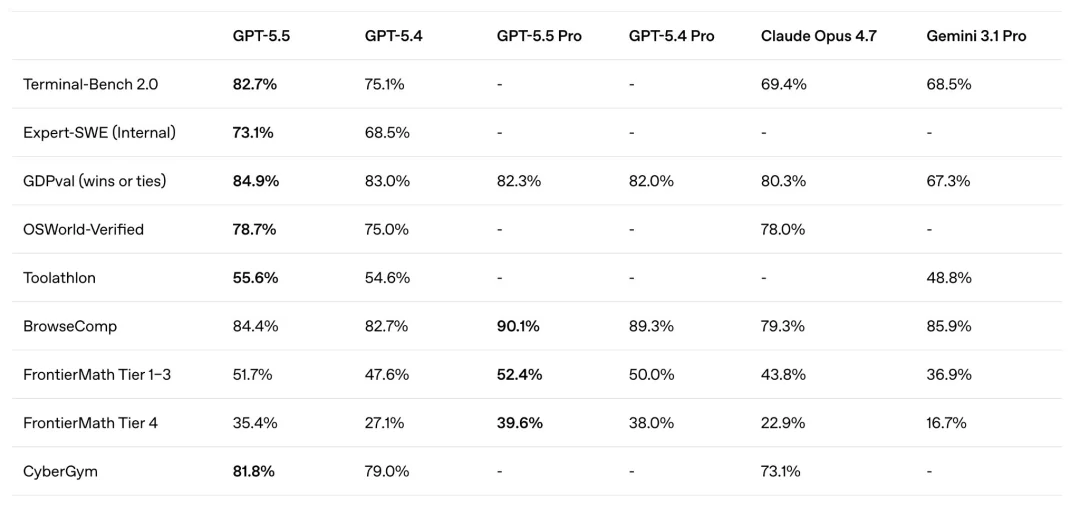
Il ricercatore di OpenAI Noam Brown ha recentemente sottolineato, in un articolo, che quando i modelli utilizzano più passaggi di ragionamento per rispondere a domande, richiamano più strumenti o eseguono ricerche e test più lunghi, un singolo punteggio diventa sempre meno in grado di riflettere con precisione le vere capacità del modello.
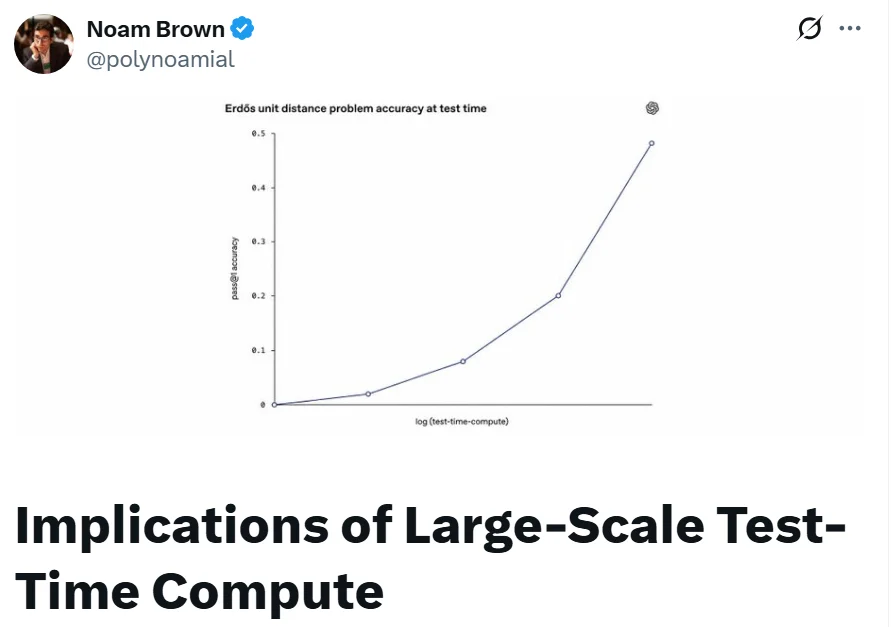
I punti chiave espressi da Brown sono i seguenti:Le prestazioni dei grandi modelli dipendono non solo dal modello stesso, ma anche da quante risorse di calcolo vengono allocate durante la fase di ragionamento.Nella valutazione futura dei modelli, non dobbiamo chiederci solo “Quanti punti ha ottenuto il modello?”, ma dobbiamo anche rispondere a un’altra domanda: Quanti token ha consumato il modello e a quali costi e tempi di esecuzione è riuscito a ottenere questi risultati?
Suggerisce che l’industria dovrebbe passare da una valutazione basata sui “punti singoli” a una valutazione della “performance della curva di calcolo della ragionevolezza”, considerando il budget per la ragionevolezza come una variabile fondamentale e un elemento di valutazione delle capacità del modello all’interno delle politiche di sicurezza dell’intelligenza artificiale.
I tradizionali sistemi di valutazione potrebbero sottovalutare le differenze di capacità tra i nuovi modelli.
Brown utilizza la reazione di mercato dopo la pubblicazione di GPT-5.5 come esempio per illustrare i limiti delle classifiche basate sui modelli tradizionali.
Secondo la sua descrizione, all'inizio della pubblicazione, ciò che ha attirato l'attenzione esterna per GPT-5.5 è stato un insieme di risultati di benchmark non particolarmente evidenti. Inoltre, rispetto a GPT-5.4, il punteggio del nuovo modello è migliorato, ma se si considera la classifica tradizionale dei punteggi, l'aumento sembra essere limitato. Pertanto, alcuni utenti sono scettici o addirittura dubitano della nuova versione.
Tuttavia, nelle prime ore dopo la pubblicazione del modello, alcuni utenti hanno notato che, man mano che sviluppatori e ricercatori iniziavano a testare compiti più complessi, GPT-5.5 mostrava differenze significative tra le diverse generazioni di modelli nel campo del ragionamento a catena lunga, dell’esecuzione continua e della risoluzione di problemi complessi. Brown ritiene che questo fenomeno, caratterizzato da un notevole miglioramento nell’esperienza pratica ma da cambiamenti limitati nei punteggi delle valutazioni, rifletta il fatto che i metodi di valutazione tradizionali non riescono a catturare appieno le capacità del modello.
Il problema è che i risultati delle valutazioni dei diversi modelli potrebbero non basarsi sullo stesso “budget di ragionamento” (ossia le risorse disponibili per l’esecuzione dei calcoli).
Nel tradizionale framework di valutazione, i ricercatori spesso selezionano un insieme di configurazioni di test per ogni modello al fine di ottimizzare i risultati il più possibile, per poi riportare i punteggi finali in un unico tabellone. Questo potrebbe sembrare equo, ma potrebbe nascondere una variabile fondamentale: alcuni modelli potrebbero continuare a migliorare significativamente del rendimento ricevendo più token di ragionamento, più chiamate o un tempo di esecuzione più lungo; altri modelli, invece, potrebbero raggiungere il loro limite di prestazioni più rapidamente.
I casi di valutazione della sicurezza informatica mostrati da Brown indicano che, se i modelli vengono confrontati semplicemente in base al risultato finale ottenuto “calcolando la quantità massima durante il test”, il vantaggio di GPT-5.5 rispetto a GPT-5.4 potrebbe non essere evidente. Tuttavia, se si riesce a mantenere la quantità di calcoli, i costi di elaborazione o i tempi di risposta a un livello simile e si osserva il comportamento dei diversi modelli, il miglioramento delle prestazioni di GPT-5.5 diventa più evidente.
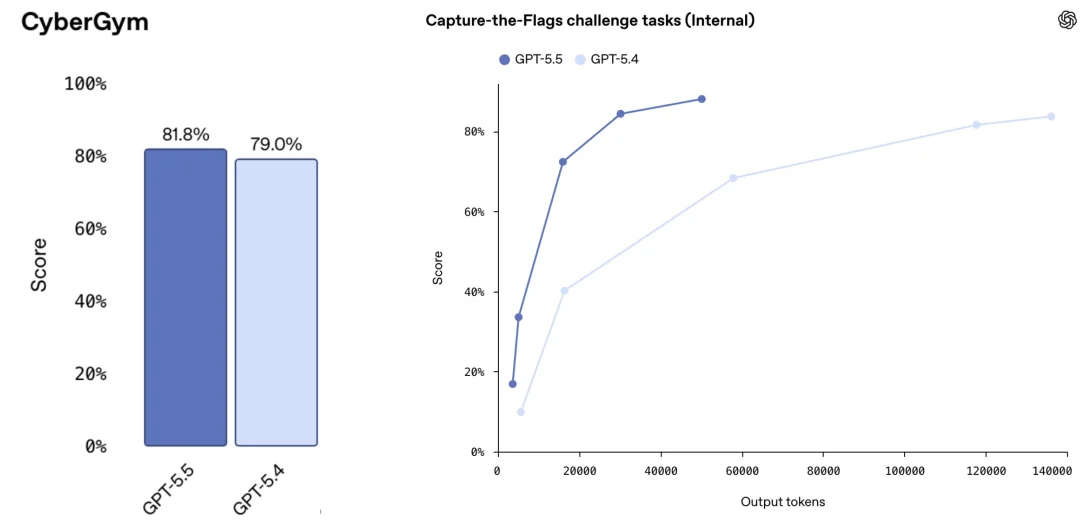
In altre parole, la differenza tra i modelli si manifesta non solo nei punteggi finali, ma anche nell’efficienza con cui vengono utilizzate le risorse di calcolo aggiuntive.
Perché non è semplice? “Continuare a fornire risorse di elaborazione fino a quando le prestazioni non migliorano più”.
La soluzione intuitiva sarebbe quella di continuare ad aumentare le risorse per ogni modello, fino a quando le sue prestazioni non raggiungono un livello di stabilità (un “plateau”), per poi confrontare le sue capacità massime.
Tuttavia, Brown ritiene che questo approccio possa essere impraticabile nella realtà. Il motivo è che per i nuovi modelli, il periodo di stabilità delle prestazioni potrebbe verificarsi molto più tardi del previsto, rendendo difficile osservarlo entro i limiti di un budget ragionevole.
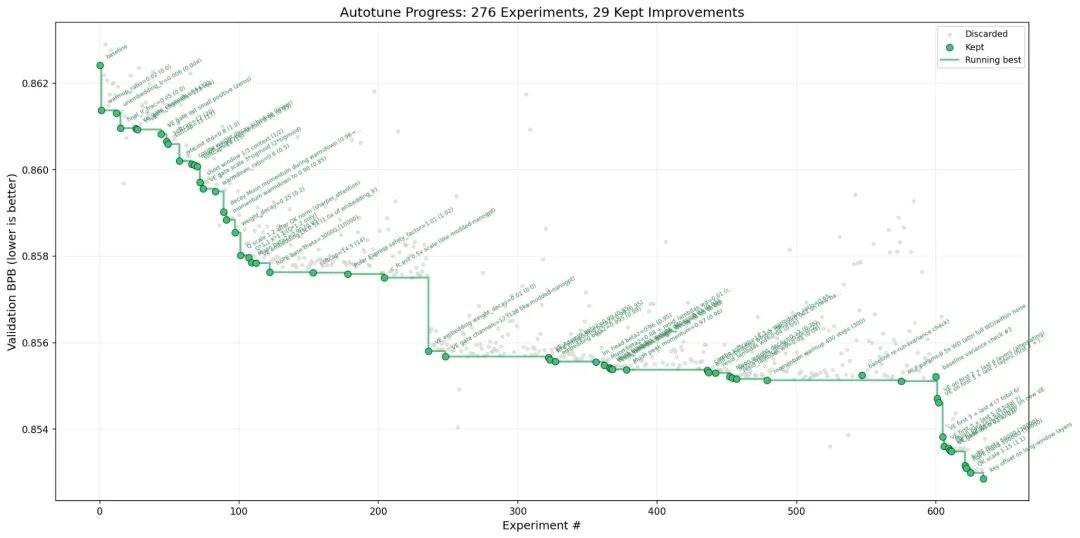
Ha citato come esempio gli esperimenti di ricerca sull’automazione avviati da Andrej Karpathy. In tali esperimenti, il modello ha continuato a mostrare miglioramenti anche dopo aver eseguito un gran numero di prove. Anche dopo centinaia di tentativi, la curva di miglioramento non è stata affatto piatta (non è rimasta stabile).
Brown Inoltre, l’AI Security Institute del Regno Unito ha menzionato i risultati della valutazione della sicurezza informatica. In questa valutazione, modelli come Mythos e GPT-5.5, dopo aver utilizzato un totale di oltre 100 milioni di token, hanno continuato a mostrare un miglioramento delle prestazioni.
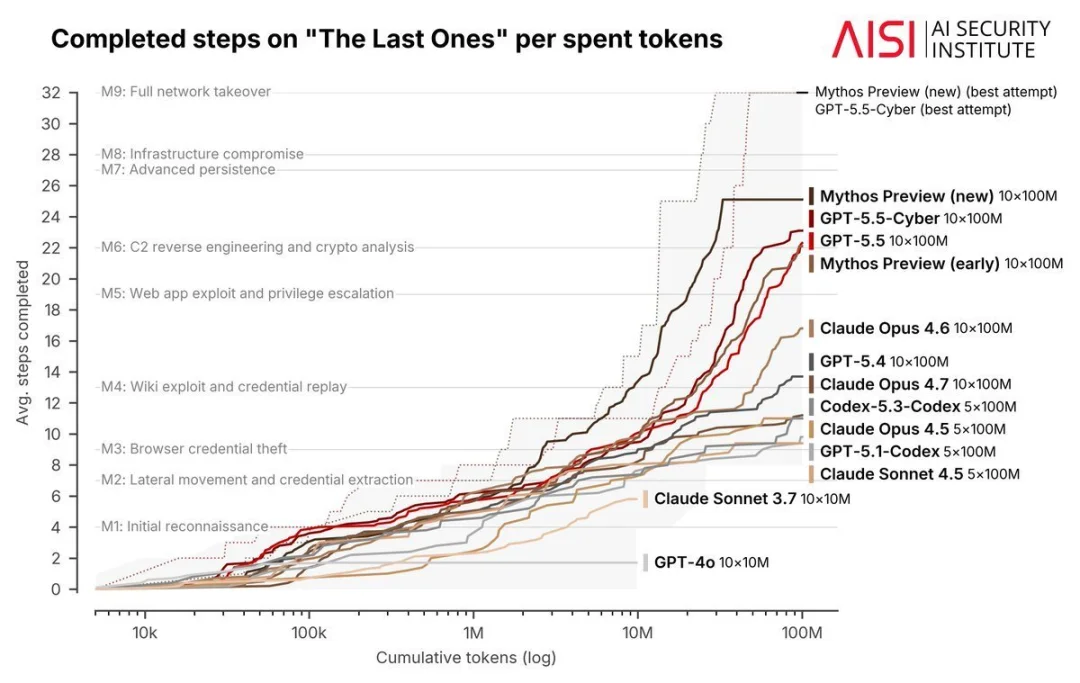
Questo fenomeno indica che i modelli possono sfruttare tempi di esecuzione sempre più lunghi e budget di elaborazione sempre più elevati per esplorare, provare e correggere strategie in compiti complessi. I modelli più potenti non solo partono da una posizione di vantaggio, ma potrebbero anche essere più capaci di trasformare risorse computazionali aggiuntive in capacità effettive.
Brown ritiene che, con il miglioramento delle capacità dei modelli, anche i cicli di esecuzione efficaci dei modelli si allungheranno. In passato, si è potuto osservare che le prestazioni dei modelli tendevano a stabilizzarsi entro un budget relativamente limitato; in futuro, il limite delle prestazioni potrebbe essere spinto più in là. In alcune attività, il cosiddetto “periodo di plateau” potrebbe persino smettere di essere uno stato facilmente misurabile.
Passare da una singola valutazione numerica a una “curva prestazioni-costo”
Di fronte a questo cambiamento, Brown suggerisce che le istituzioni che pubblicano i modelli dovrebbero modificare il modo in cui vengono presentati i test di benchmark.
Invece di pubblicare solo un punteggio finale, sarebbe meglio indicare la quantità di calcolo necessaria per il ragionamento sul lato orizzontale, mostrare le prestazioni del compito sul lato verticale e tracciare una curva completa dei cambiamenti nelle prestazioni. Il lato orizzontale potrebbe utilizzare indicatori come il numero di token, il costo di ragionamento o il tempo di esecuzione effettivo.
Questo metodo può rispondere a domande che sono difficili da spiegare nei tradizionali quadri di valutazione. Ad esempio, con lo stesso budget, quale modello si comporta meglio? Quando il budget aumenta di dieci volte, quale modello migliora più rapidamente? I modelli si avvicinano al loro limite di capacità? Come cambia l’efficienza dei costi tra i diversi modelli?
Metodi simili sono già stati utilizzati in alcuni test di benchmark. Brown menziona che l’ARC-AGI Evaluation cerca di misurare la relazione tra i punteggi dei modelli e i costi di esecuzione, e non solo di pubblicare un singolo punteggio.
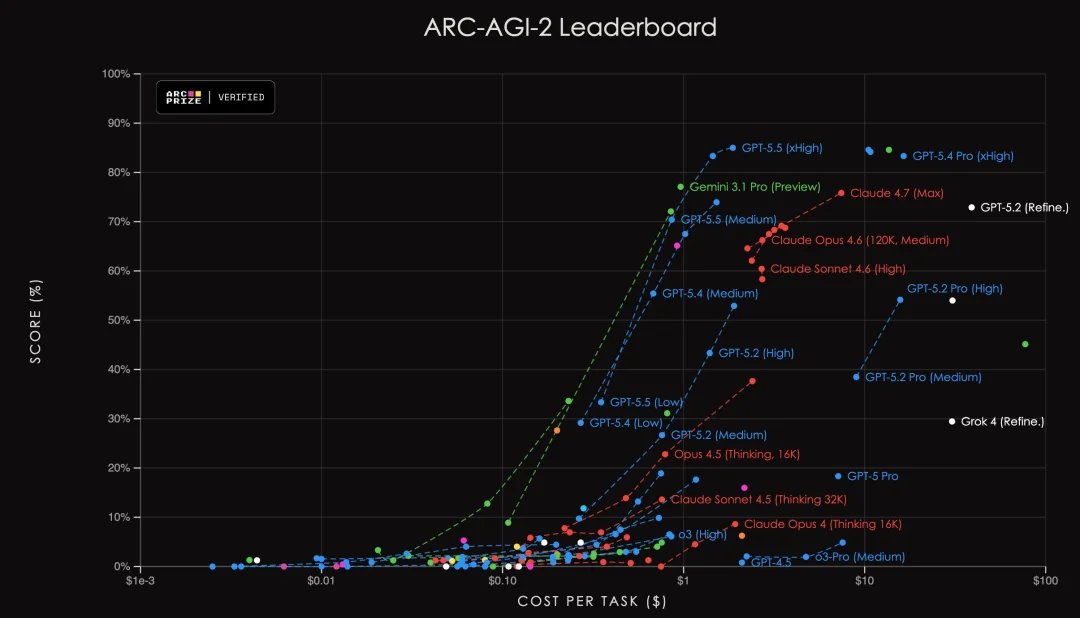
Un altro approccio fattibile è stabilire token chiari per la valutazione, nonché limiti di costo o tempo, e informare in anticipo il modello delle informazioni sul budget. Questo metodo è simile a quando gli esseri umani partecipano a esami standardizzati: sia che si tratti dell’esame di ammissione alle università americane SAT che delle Olimpiadi Internazionali di Matematica, i partecipanti devono completare i compiti entro un tempo prestabilito. In questo modo, le capacità dei modelli possono essere confrontate anche all’interno di vincoli uniformi.
Tuttavia, Brown ha anche sottolineato che i diversi indicatori sono limitati.
A causa dei diversi tokenizer utilizzati dai modelli, nonché delle differenze nella velocità di generazione e nelle unità di misura, i numeri non possono essere direttamente confrontati tra i vari modelli. Inoltre, i costi associati al processo di generazione possono variare. I costi dipendono dall’efficienza dell’hardware, dal trattamento in batch e dall’implementazione tecnica. Poiché il tempo di esecuzione non è un indicatore perfetto, nemmeno esso rappresenta un criterio affidabile per valutare le prestazioni dei modelli. Le tecniche di “cooperazione tra più agenti intelligenti” o di selezione del miglior risultato tra diversi candidati (best-of-N) permettono di generare più risposte in parallelo, il che potrebbe non aumentare significativamente il tempo di attesa percepito dall’utente, ma aumenta notevolmente la quantità totale di calcoli richiesti.
Nonostante ciò, ritiene che qualsiasi di questi indicatori fornisca più informazioni di un singolo punteggio che esce dal budget di ragionamento previsto.
Il problema del budget di ragionamento si sta estendendo anche alle valutazioni della sicurezza dell’intelligenza artificiale.
Le discussioni di Brown non si limitano alla lista dei modelli: ritiene che il budget di ragionamento influisca direttamente sulla gestione della sicurezza dei modelli all’avanguardia.
Prima di rilasciare modelli di intelligenza artificiale all’avanguardia, le istituzioni di R&D valutano solitamente le potenziali capacità di abuso, come attacchi informatici, rischi biologici e rischi chimici. Se un modello raggiunge un certo livello di rischio, le istituzioni di R&D potrebbero dover rimandare il rilascio o aggiungere misure di mitigazione, come restrizioni di accesso e meccanismi di monitoraggio, prima della distribuzione.
La domanda è: se la capacità del modello migliora con l’aumento della quantità di calcolo necessaria per il ragionamento, quanta risorsa di calcolo dovrebbe essere utilizzata per la valutazione della sicurezza?
In realtà, gli utenti comuni potrebbero investire solo pochi dollari o qualche decina di dollari in un compito. Tuttavia, un’organizzazione ben finanziata, un team professionale o un attore nazionale potrebbero essere disposti a investire risorse molto maggiori rispetto agli utenti ordinari per raggiungere un unico obiettivo. Se un ente di valutazione testasse il modello con un budget limitato, potrebbe sottovalutare la sua capacità di affrontare rischi in condizioni di elevati risorse.
Brown prende come esempio le controversie che sono seguite alla pubblicazione di Gemini 3 Deep Think. Sottolinea che i risultati dei test di base di Deep Think erano significativamente migliori rispetto ai modelli precedenti, ma al momento della pubblicazione non è stata fornita l’intera scheda del sistema per valutare appieno la capacità di gestione dei rischi di questa versione. Questa pratica ha suscitato le critiche di alcuni ricercatori nella field della sicurezza dell’intelligenza artificiale.
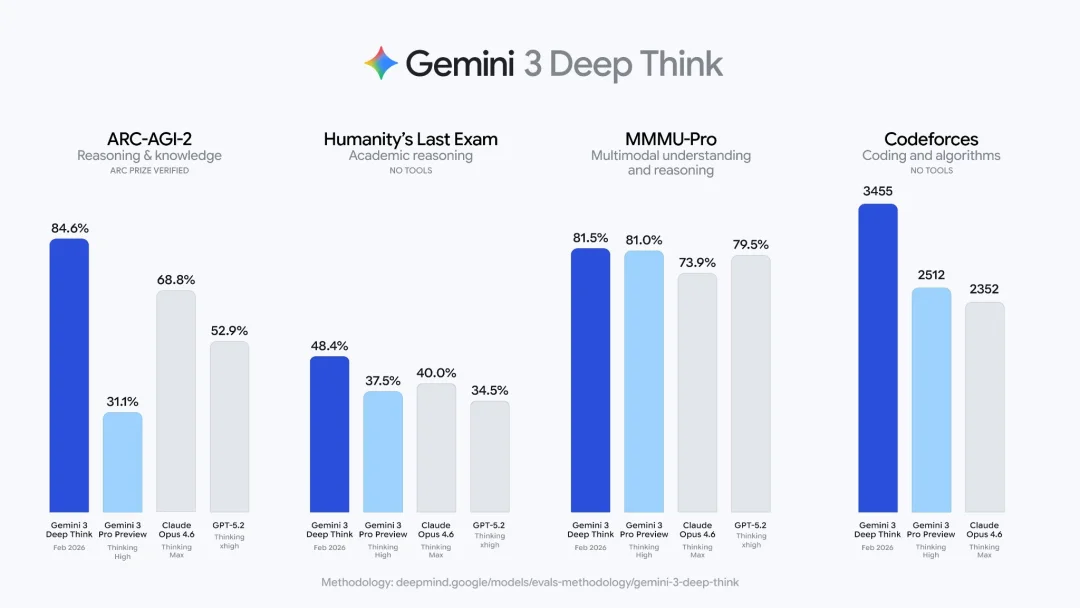
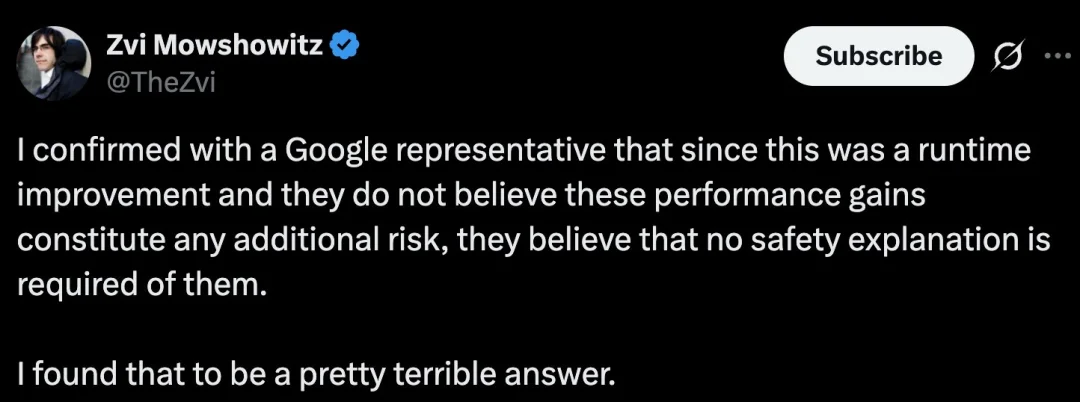
Tuttavia, sembra che dietro la controversia su Brown ci siano problemi più profondi: le aziende di intelligenza artificiale e le agenzie di sicurezza non hanno ancora sviluppato un metodo stabile per valutare le capacità dei modelli con diversi budget di elaborazione.
Egli ipotizza che Deep Think possa non essere un nuovo modello addestrato completamente in modo indipendente, ma piuttosto un sistema di supporto all’elaborazione basato su altri modelli esistenti. Questo sistema può migliorare le prestazioni in compiti complessi attraverso l’invocazione ripetuta dei modelli, la generazione parallela di risultati candidati, il controllo automatico delle risposte e la correzione iterativa.
Se questa ipotesi si conferma, allora, in teoria, Deep Think non solo sarà in grado di realizzare alcune delle funzionalità mostrate dalla piattaforma stessa, ma anche gli sviluppatori esterni, se sono disposti a investire un tempo sufficiente nella fase di ragionamento, potranno combinare diversi modelli per creare flussi di lavoro simili. Il ruolo principale di Deep Think è quello di rendere processi di ragionamento complessi, che normalmente richiedono competenze di sviluppo professionale, disponibili in una forma facile da utilizzare anche per gli utenti non esperti.
Pertanto, secondo Brown e gli altri, la vera questione da considerare non è se il prodotto abbia rilasciato separatamente la scheda del sistema, ma se le istituzioni di ricerca e sviluppo abbiano testato a sufficienza il livello di capacità che il modello di base poteva raggiungere al momento del suo primo rilascio, considerando diversi budget per il ragionamento e strategie di sviluppo.
L'valutazione di un alto budget è difficile da attuare in modo completo, ma si può provare a fare delle stime extrapolative.
Teoricamente, un attore con risorse sufficienti potrebbe investire costi di ragionamento pari a centomila dollari per singola attività. Tuttavia, la valutazione della sicurezza richiede solitamente migliaia o addirittura milioni di test. Se per ogni operazione si utilizzasse un budget estremamente elevato, i costi di valutazione diventerebbero rapidamente insostenibili.
Brown suggerisce di iniziare con test all’interno di un budget di ragionamento relativamente controllabile, per poi migliorare le prestazioni con budget più elevati in base alla tendenza delle capacità del modello in funzione della quantità di calcoli eseguiti. Inoltre, le istituzioni di valutazione dovrebbero indicare chiaramente l’ambito delle previsioni e l’incertezza associata, piuttosto che considerare i risultati dei calcoli come conclusioni definitive.
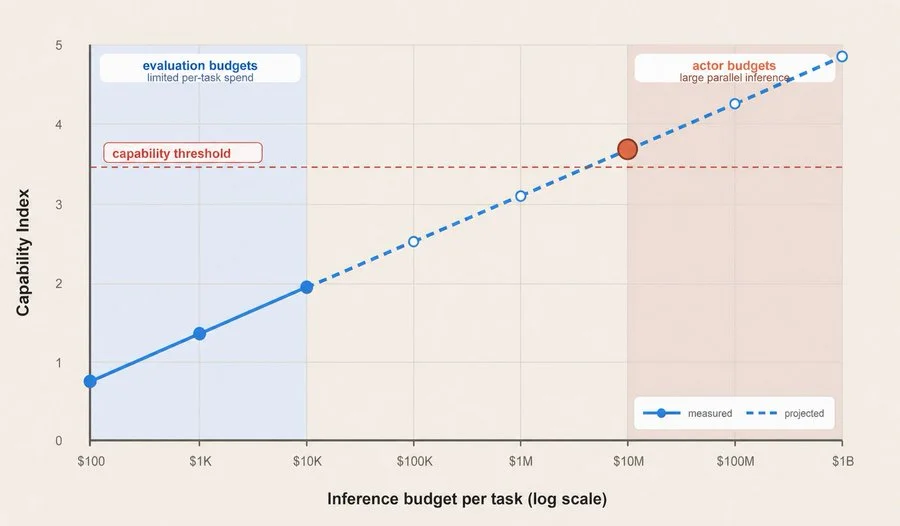
Questo metodo è simile all’uso di dati locali per stimare le tendenze di cambiamento in sistemi su larga scala. Non può sostituire i test effettivi, ma può aiutare le organizzazioni di sviluppo e le autorità di regolamentazione a comprendere come i confini dei rischi potrebbero cambiare quando al modello vengono forniti più tempo, strumenti e risorse di calcolo.
Tuttavia, Brown ammette anche che i compiti a lungo termine possono ancora presentare problemi che sono difficili da risolvere con esperimenti a breve termine.
Ad esempio, se i ricercatori vogliono determinare se un ente intelligente indipendente svilupperà deviazioni dagli obiettivi, inganni strategici o altri comportamenti non coerenti dopo un anno di funzionamento continuo, il metodo più affidabile potrebbe ancora essere quello di far eseguire effettivamente l’ente intelligente per un periodo di tempo sufficientemente lungo. Basandosi solo sui risultati di esperimenti durati poche ore o giorni, potrebbe essere impossibile rilevare i cambiamenti chiave nel suo comportamento a lungo termine.
Ciò genererà un nuovo conflitto di realtà: il ciclo di sviluppo e rilascio dei modelli di intelligenza artificiale potrebbe durare solo pochi mesi, mentre il ciclo di esecuzione dei corpi intelligenti potrebbe allungarsi sempre di più. In futuro, le aziende di ricerca e sviluppo potrebbero trovarsi di fronte a una situazione particolare: il prossimo modello potrebbe essere quasi pronto per il rilascio prima ancora di aver completato il suo ciclo di funzionamento massimo.
Tre suggerimenti: rendere il budget di ragionamento una variabile di base per la valutazione del modello
Rispetto ai problemi menzionati nella valutazione delle capacità e nella governance della sicurezza, Brown ha proposto tre suggerimenti concreti.
Innanzitutto, quando le aziende di ricerca e sviluppo nell'ambito dell'intelligenza artificiale rilasciano nuovi modelli, dovrebbero pubblicare i risultati dei test di benchmark sotto diversi condizioni di budget di elaborazione. Idealmente, le aziende dovrebbero fornire curve di prestazioni che mostrino la relazione tra il numero di token utilizzati, i costi o il tempo di esecuzione. Almeno, dovrebbero spiegare quante risorse di elaborazione siano state effettivamente impiegate per ottenere un determinato risultato.
In secondo luogo, i ranking dei test di benchmark dovrebbero registrare il consumo delle risorse di elaborazione (come CPU, memoria, ecc.) oppure impostare limiti uniformi in termini di token utilizzati, costi o tempo per i modelli di riferimento. Attualmente, alcune variabili di valutazione sono già state incluse, ma nell’industria non sono ancora state stabilite pratiche standard.
In terzo luogo, i risorse di calcolo per la fase di ragionamento del Framework di Preparazione delle Imprese di Intelligenza Artificiale (Preparedness Framework) e della Politica di Ampliamento Responsabile (Responsible Scaling Policy, RSP) devono essere considerate attentamente. Quando un’istituzione valuta se un modello supera determinati limiti di sicurezza, non è sufficiente esaminare le prestazioni in una singola configurazione, ma è necessario anche valutare diversi livelli di budget di ragionamento per prevedere con incertezza la capacità di risposta ai rischi in condizioni di budget più elevati.
Il settore si è già reso conto di questo problema, ma i sistemi di valutazione non hanno ancora completamente tenuto il passo.
L'aumento delle risorse di calcolo durante la fase di ragionamento può migliorare le prestazioni del modello, e questo non è una scoperta nuova.
Da quando OpenAI ha rilasciato il modello di ragionamento o1 nel settembre 2024, l'intero settore ritiene che questo modello impieghi un numero maggiore di passaggi di ragionamento per rispondere alle domande, ottenendo risultati migliori in ambiti come la matematica, il codice e compiti analitici complessi. La ricerca sulle "capacità di espansione durante i test di calcolo" o sull'"espansione della ragionamento computazionale" sta gradualmente diventando una direzione importante nello sviluppo dei grandi modelli.
Tuttavia, secondo Brown, quasi due anni dopo l'emergere di questa tendenza, la pubblicazione di molti modelli all'avanguardia si basa ancora principalmente su un unico punteggio di riferimento per la diffusione e il confronto. Alcune agenzie di sicurezza possono anche rivalutare i limiti delle capacità dei modelli utilizzando budget di elaborazione decine o addirittura centinaia di volte superiori in sistemi di tipo “scaffolding”.
Con i modelli che diventano sempre più abili nell’utilizzare processi di lunga durata, iterazioni di tentativi ed errori e risorse di calcolo su larga scala, la qualità delle spiegazioni fornite da liste tradizionali potrebbe continuare a diminuire. Sotto condizioni diverse, come domande e risposte a basso budget, ricerche approfondite a alto budget, collaborazioni tra più intelligenze e chiamate a strumenti automatizzati, lo stesso modello di base può mostrare livelli di capacità completamente diversi.
Brown ritiene che, in futuro, quando si misureranno le capacità dell’intelligenza artificiale, il budget di inferenza non dovrebbe più essere considerato solo un’informazione ausiliaria nel processo di test, ma dovrebbe diventare un parametro centrale nei rapporti di valutazione, insieme alla dimensione del modello, ai dati di addestramento e alla finestra di contesto.
Da una prospettiva più ampia, ciò significa anche che l’industria dell’intelligenza artificiale sta gradualmente lasciando alle spalle la fase in cui un modello viene definito da un singolo numero. Per quanto riguarda la valutazione delle capacità, il confronto dei prodotti e la sicurezza informatica, le domande veramente importanti non sono solo quelle relative a ciò che un modello può fare, ma piuttosto a cosa può realizzare quando dispone di sufficiente tempo, fondi e risorse computazionali.
Riferimento collegamento: https://x.com/polynoamial/status/2064210146558136827
L'autore proviene da "Heart of Machine" e dal "Editoriale di Heart of Machine".
Link dell’articolo:https://airai.cc/it/ai-news/10/
È stato utile?