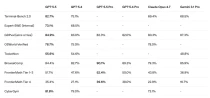
Alors que les grands modèles linguistiques commencent à être utilisés pour des tâches complexes telles que la raisonnement, la recherche automatisée et la sécurité des réseaux, les méthodes traditionnelles d'évaluation des modèles font face à de nouveaux défis.Depuis longtemps, la publication de modèles est accompagnée d'une table de résultats composée de divers tests de benchmark, incluant des tests en mathématiques, en programmation, en questions scientifiques, en sécurité informatique et en raisonnement cognitif, et ces résultats sont comparés horizontalement avec ceux de la génération précédente de modèles.